6.2 超参数调优:网格、随机与贝叶斯
6.2 超参数调优:网格、随机与贝叶斯
本节摘要:调参的本质是带昂贵评估的黑盒优化。网格搜索穷举组合但维度即爆炸;随机搜索在高维空间里以同样的预算覆盖更广;贝叶斯搜索用历史评估结果建模代理函数,把预算花在最有希望的点上。本节讲清三者的数学差异、关键超参的调参次序,以及「什么时候停手」。
验证口径立住之后(6.1),调参才有讨论的意义——在会作弊的尺子上再精巧的搜索也只是在优化幻觉。这一节的追问链从「三种搜索怎么选」开始,深入到「哪些参数值得调、按什么顺序调」,最后落在「怎么知道可以停了」——面试官用这道题判断你有没有带着预算意识做实验。
主问题:三种搜索的账本
主问题:「网格、随机、贝叶斯搜索各自的原理和适用场景?」
标准答案
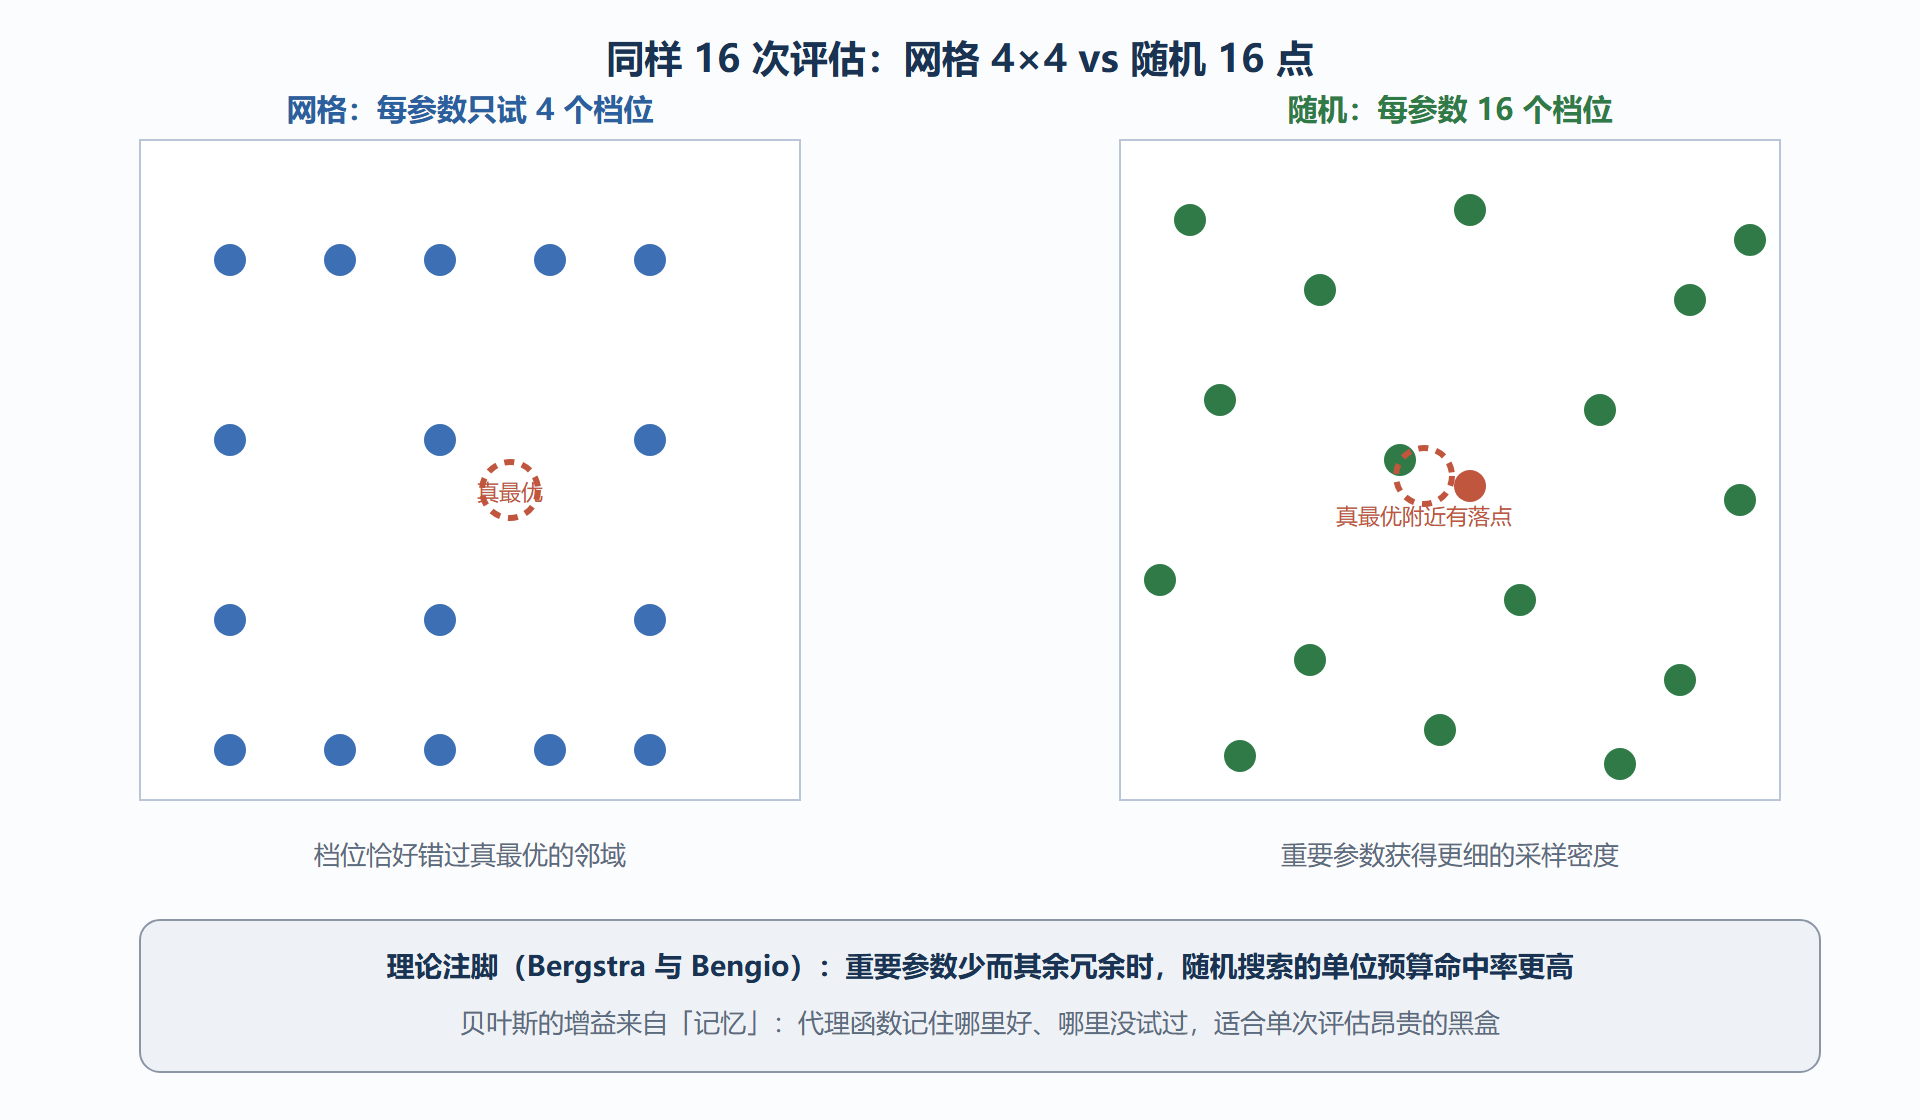
网格搜索枚举所有参数组合逐一评估:空间小、参数少时最透明,但维度与取值数一多就组合爆炸——五个参数各五个取值就是三千多次评估。随机搜索在空间里均匀抽样:同样的预算,它给每个参数更多取值档位;在「少数参数重要、多数参数无关」的常见情况下,随机搜索找到重要参数精细档位的概率显著更高。贝叶斯搜索维护一个代理模型(高斯过程、TPE 等)拟合「参数到分数」的关系,按采集函数在「可能好」与「不确定」之间权衡地选下一个点,通常用更少评估逼近最优,代价是并行化困难与实现复杂度。
三者的选择信号很直接:参数少于三个且要完整敏感性地图,用网格;参数多、预算紧,随机搜索打头;单次评估昂贵(大模型训练级)、追求逼近最优,贝叶斯接管。别忘了 Hyperband 与 successive halving 这类早停调度器:它们不选点而是砍命——把资源向有希望的训练 run 倾斜,与任何搜索策略正交叠加。
图:三种搜索策略在同预算下的覆盖差异
追问一层:调参的优先级与顺序
追问:「给你一个没调过的梯度提升模型,先调什么后调什么?」
参考答法要体现「影响面排序」:第一步学习率与树数量(连带早停)——它们决定整体节奏,单独调没有意义,通常学习率取小值、树数交给早停;第二步每棵树的复杂度(max_depth、min_child_weight、叶子最小样本),控制单棵树的偏差;第三步采样类参数(行采样、列采样),控制方差与相关性;第四步正则项(gamma、lambda)在过拟合确认后再收紧。顺序背后的原则是「先定全局节奏,再修局部形状」,反着调会陷入互相牵制的循环。学习率永远不进大网格——它和树数量是联动参数,用「小学习率加早停」的组合替代双参数搜索是标准省法。
追问二层:什么时候停手
追问:「怎么判断继续调参已经没有意义了?」
这题考的是元认知,参考答法分三个停机信号:其一,验证分数的改进幅度连续多轮小于噪声水平(6.1 说过,标准差之内不算改进);其二,学习曲线显示瓶颈不在超参——训练与验证曲线同时低且贴,是欠拟合,该换模型或造特征而不是继续拧超参;其三,边际成本核算:一次评估的时间成本乘以预期改进,超过业务的等待预算就该收手。能说出「调参的收益上限受限于特征与模型表达力,超参只能在表达力的上限内滑动」这句,基本就是本节的满分句。
from sklearn.model_selection import RandomizedSearchCV from scipy.stats import randint, uniform space = { "max_depth": randint(3, 9), # 树复杂度 "min_child_weight": randint(1, 8), "subsample": uniform(0.6, 0.4), # 行采样 "colsample_bytree": uniform(0.6, 0.4), # 列采样 "reg_lambda": uniform(0.5, 3.0), # L2 } search = RandomizedSearchCV( model, space, n_iter=60, cv=5, scoring="roc_auc", n_jobs=-1, random_state=0, refit=False) search.fit(X_tr, y_tr) print("最优:", search.best_params_) print("5折均值±标准差: %.4f ± %.4f" % (search.best_score_, search.cv_results_["std_test_score"][search.best_index_]))
代码里两个细节对应本章前两节:scoring 沿用 6.1 选定的诚实口径;报告带标准差,给「改进是否显著」留出判断依据。
易错点
- 在测试集上跑搜索:测试集被反复窥视后,最终分数退化为「对测试集的过拟合」,这是调参题里最严重的一票否决项。
- 把学习率扔进大网格与其他参数正交搜索:联动参数正交枚举是预算黑洞,组合用早停或分步走。
- 只报最优分不报分布:搜索结果该汇报「前若干名配置的分数分布」,单点最优可能是验证噪声的彩票。
- 忽视可复现:随机搜索不固定种子,结果无法复跑;生产实验每个 run 都要有种子与配置快照。
评分要点
及格:三种搜索的原理与适用各说得出;良好:调参次序体现「节奏先行、复杂度次之、采样与正则殿后」,停机信号至少两条;优秀:能引用随机搜索对网格的覆盖优势成因,讲清学习率与早停的联动省法,并把「调参上限受限于特征与表达力」作为收尾判断。调参题的高分段全在预算意识——机器资源与人力时间都是账本上的数字。
分数可信、参数到位,最后一问是「你懂你的模型吗」:解释性的两把尺子,请看下一节。
高频追问速答
问:早停(early stopping)为什么能同时防过拟合又省算力?
验证分数在训练轮数维度上也是一条先降后升的曲线,停在拐点就是给模型容量加了一条时间维的正则;同时它砍掉了后续无效轮次,与树数量搜索天然合一。GBDT 系「小学习率加早停」的组合正是这两笔账的合订本。
问:神经架构搜索(NAS)和超参搜索什么关系?
NAS 把「网络结构」也变成搜索变量,空间更大、评估更贵,需要权重共享或代理任务降本。概念上是超参搜索的超集,工程上只在研发布局级投入——普通业务把结构搜索的预算花在特征与数据上通常更值。
问:搜索空间的设定有什么讲究?
空间决定上限:对数尺度扫描学习率与正则强度(跨数量级的参数线性扫描是预算黑洞);参数相关性强的(学习率与 batch size、C 与 gamma)要么联动要么分步;空间先粗后细两轮走。搜索器再聪明,也只是在人划的空间里找。
表达纪律:调参题时刻报预算——评估次数、单次成本、总时长。带账本的回答自带资深感。
边角案例两则
问:搜索预算该在特征和超参之间怎么分?
经验法则:特征与数据侧的边际收益通常更高且更持久,超参挤的是表达力上限内的水分。预算分配的合理顺序是先把数据与特征做到当前模型的瓶颈,再用搜索收尾。「调参是最后一公里,不是高速公路」这句比喻可以直接用。
问:多目标(效果与延迟)怎么搜?
把延迟作为约束(只搜延迟达标区)或把加权组合当目标(分数减去延迟惩罚);前者工程可控,后者需要标定权重的业务含义。优化单指标而延迟爆表的模型,在部署环节会被全盘推翻——搜索目标必须包含部署约束。