6.3 模型解释性:重要性与 SHAP 两把尺子
6.3 模型解释性:重要性与 SHAP 两把尺子
本节摘要:解释性追问分两层:全局层回答「模型整体依赖谁」,样本层回答「这条预测为什么是这样」。特征重要性的三种口径各有偏差,SHAP 用博弈论的边际贡献给出一致的归因框架。本节给出各方法的机制、坑位与一句话选型。
调参完成只是技术终点,业务与合规的起点才是解释性:信贷拒贷要给理由、医疗辅助诊断要给依据、面试官问「你的模型为什么这么预测」要给逻辑。解释题的本质是把模型的内部机制翻译成人类能审计的语言——翻译得好坏,取决于你对各把「尺子」的偏差是否心中有数。
主问题:重要性有几种口径
主问题:「怎么衡量特征重要性?它们有什么区别?」
标准答案
三种常见口径。其一,内建重要性(树模型的分裂增益或加权次数):免费拿到,但偏向高基数与高方差特征,且相关特征会互相分摊重要性;其二,置换重要性:打乱某特征后看模型效果掉多少,模型无关、直白诚实,代价是计算量与「相关特征分摊」依旧存在——两个强相关的特征互相顶班,各自打乱都不掉点,会被同时误判为无用;其三,SHAP 值:按博弈论思路把预测在所有特征子集上做边际贡献的加权平均,保证每个特征的归因可加且正负分明,既有全局汇总也有单样本明细,代价是计算贵(树模型有加速实现)。
三把尺子的使用顺序通常是:内建重要性看个大概,置换重要性交叉验证结论,单样本追问时上 SHAP。口径越往后越贵也越可信——这个「可信度阶梯」本身就值得在面试里讲出来。
追问一层:SHAP 的机制与直觉
追问:「SHAP 值是怎么算出来的?加和为正意味着什么?」
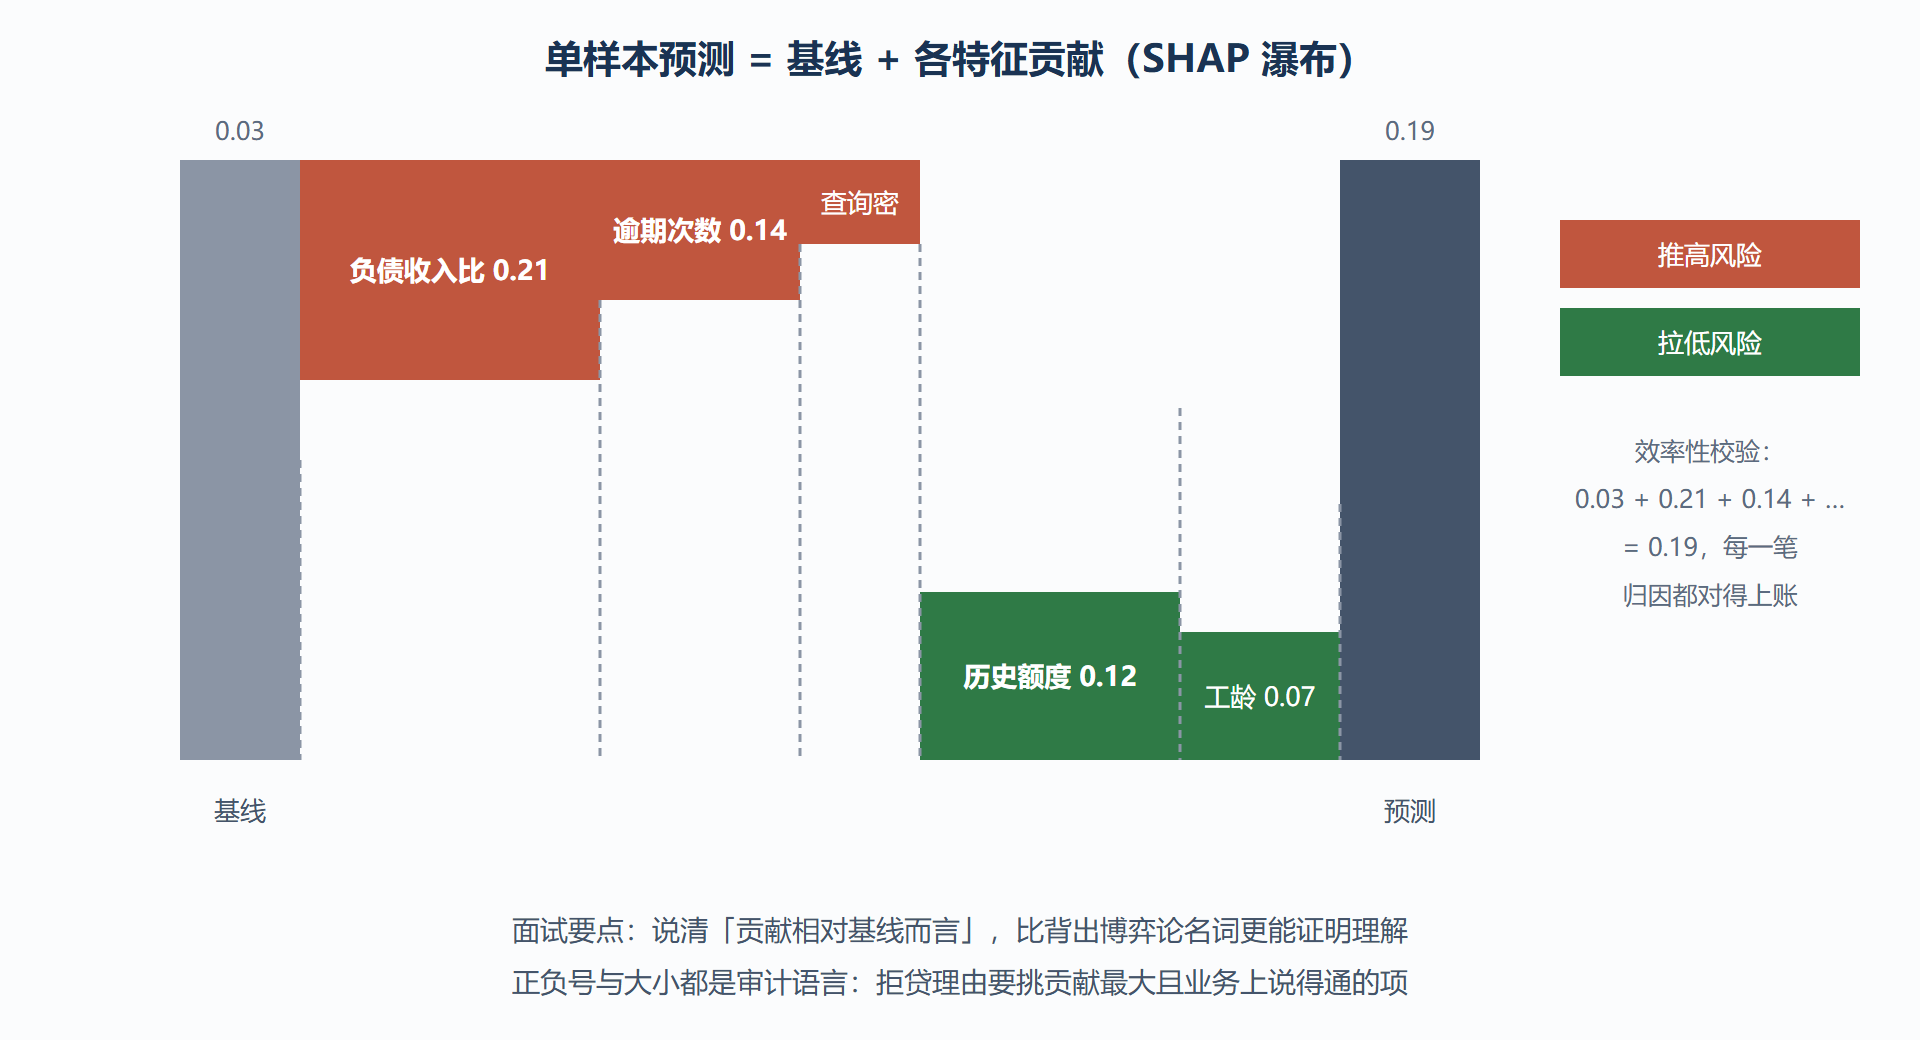
参考答法:SHAP 的思想是「公平分红」——把预测看成特征的合作成果,某特征的贡献等于它在所有可能加入顺序下边际贡献的期望(Shapley 值)。这样得到的归因满足三条好性质:效率性(所有特征的归因加基线值恰等于预测值)、一致性(模型越依赖某特征,其归因不降)、缺失性(缺席特征归因为零)。单样本的 SHAP 值为正表示该特征把这条例推高过基线,为负则拉低;把全量样本的 SHAP 值聚合,就是全局重要性。面试里能说出「它回答的是相对于基线(通常是全体样本均值预测)的贡献」,就能和背概念的人拉开差距。
图:一条预测的 SHAP 归因瀑布
追问二层:解释与因果的边界
追问:「SHAP 显示某特征贡献最大,能说它『导致』了结果吗?」
这题是解释章的哲学收尾,参考答法:不能。SHAP 与一切特征归因度量回答的都是「模型为什么这么说」,不是「现实里什么导致什么」——模型的依赖可能来自混杂变量、选择偏差或相关性的巧合。要谈因果,需要的是因果推断的工具(随机化实验、倾向得分、因果图),那是另一套方法论(第 8 章开放题还会回到这条边界)。面试的正确姿势是主动画清这条线:解释模型是审计模型的依据,解释世界要靠因果证据。这一句边界声明在合规敏感的业务(信贷、医疗)里几乎是必答项。
import shap explainer = shap.TreeExplainer(model) # 树模型专用加速实现 shap_values = explainer.shap_values(X_sample) # 单样本归因:从基线出发到该样本预测的完整分解 shap.force_plot(explainer.expected_value, shap_values[0], X_sample.iloc[0], matplotlib=True) # 全局重要性:平均绝对 SHAP 值排序 order = abs(shap_values).mean(axis=0) print("全局重要性排名:", order.argsort()[::-1][:10])
代码层面记住两点即可:树模型用 TreeExplainer 走加速路径;全局重要性与单样本归因是同一组数值的两种聚合,不必重复计算。
易错点
- 把内建重要性当真值:它对高基数列的偏置与相关特征的分摊都是已知缺陷,直接拿去删特征会冤案连发。
- 置换重要性的操作错误:在训练集上做置换(应当用验证集,且打乱后要重新评估而非复用缓存);相关特征互相顶班导致「双低」误删——先做相关性分组再置换是补救姿势。
- SHAP 解释写成因果结论:归因语言要带「模型层面」限定词,业务汇报里漏掉这层限定会引发错误的决策联想。
- 深度模型的解释硬套 SHAP 全量计算:算力爆炸;梯度类方法(积分梯度、Grad-CAM,第 8.4 节还会见)才是对口工具。
评分要点
及格:说出三种重要性口径与各自的直观机制;良好:SHAP 的效率性、基线相对性讲得清,置换重要性的相关特征陷阱能识别;优秀:主动划清解释与因果的边界,并按场景给出解释方法选型(树用 SHAP、深度用梯度法、合规场景保留审计日志)。解释题的终局是沟通:把数字讲成人话,把人话讲进决策链——这也是下一章的入场券。
第 6 章到此收束「单模型的可信闭环」。下一章镜头拉远:算法选型、线上排查与项目复盘,工程实践追问链的主场到了。
高频追问速答
问:全局代理模型怎么用,有什么风险?
用可解释模型(浅树、线性)拟合黑盒的输入输出,向业务转述「模型大致在做什么」。风险是代理模型只在黑盒行为的流形上近似,边界区域失真,且代理的准确率必须报告——不给保真度分数的代理解释是半成品。
问:反事实解释是什么,适合什么场景?
回答「最小改动多少,结果会反转」——对被拒贷用户说「收入再高某一档即可通过」。它是对用户最友好的解释形态,天然可行动;但生成高质量的反事实需要处理特征可行性与相关性(年龄加一岁不现实、收入与职业相关不能独立改)。
问:解释结果不稳定怎么办?
先查三处:背景数据集的抽样是否代表全分布、超参(SHAP 的样本数、LIME 的扰动宽度)是否固定、相关特征是否被分摊。解释方法的随机性必须像模型训练一样被种子化管理,否则每次解释一个故事。
表达纪律:解释题随时带上「受众」与「忠实度」两个维度,这是从工具使用者升级到方法使用者的标志。
深水区:两个延伸追问
问:怎么给非技术干系人做一场模型解释汇报?
结构是「结论、驱动因素、边界、监控」四段:先给业务结论与置信度,再给两三个主要驱动因素的业务翻译,然后主动讲模型不适用的人群与场景,最后给监控承诺。全程零术语,每个归因都配业务例子——汇报能力本身就是模型信任度的一部分。
问:解释的稳定性与准确性冲突怎么办?
稳定性优先。一个每次都变但局部更准的解释无法建立信任也无法过审计;工程做法是固定背景集与随机种子、对相似样本做解释一致性检查,牺牲一点局部保真换取可复现。「解释首先是沟通工具,其次才是数学对象」——这句定位能稳住整段回答。