2.3 比对:BWA 把读长放回基因组的原理与实操
2.3 比对:BWA 把读长放回基因组的原理与实操
本节摘要:比对是重测序分析的中枢。本节讲清 BWA 背后的 Burrows-Wheeler 变换为什么能把亿条读长秒级归位,SAM/BAM 文件里每一列在说什么,以及 MAPQ、多重定位这些实战里天天碰到的概念。
比对不是字符串匹配
先纠正一个直觉。如果读长与基因组完全一致,任何文本搜索都能搞定;麻烦在于读长带着测序错误,样本与参考之间还有真实差异(SNP、小片段插入缺失),读长两端还可能落在内含子两侧(RNA-seq)。比对工具的任务是:在允许这些"不完美"的前提下,为每条读长找到最可信的来源位置,并给这个判断打一个置信分。
置信分就是 MAPQ(比对质量值):Phred 刻度,Q30 表示这个位置判错的概率是千分之一。它与 1.2 节的碱基质量值是两回事——碱基质量管"这个碱基读对了没",MAPQ 管"这条读长放对地方没"。MAPQ 0 是个特殊值:这条读长在基因组里找到了多个同样好的位置,工具无法决断。变异检测通常会丢弃 MAPQ 过低的读长,因为放错位置的读长会伪装成变异。
BWA 背后的巧思
BWA 的速度来自对参考基因组做 Burrows-Wheeler 变换(BWT)。BWT 是一种可逆的重排,把基因组里重复出现的片段尽量聚到一起,配合 FM 索引可以做到"从后往前逐字符收缩候选区间":查询一条读长时,从它最后一个字符开始,每读入一个字符,候选区间就缩小一圈;区间缩没了说明这条读长在基因组里不存在(差异就是错配或 gap),区间收缩到很小就锁定了来源位置。整个过程不接触原始序列的绝大部分,比较次数与基因组大小几乎无关。
这就是为什么 2.2 节强调先建索引:bwa index 把 GRCh38 变换成 BWT 结构存盘,之后每次比对直接复用。一套索引可以服务无限次比对,这也是"参考固定、样本海量"的项目结构能高效运转的原因。
# 标准比对三步:比对 → 按坐标排序 → 标记 PCR 重复 bwa mem -t 16 -R "@RG\tID:sample1\tSM:sample1\tPL:ILLUMINA" \ grch38.fa trimmed/sample_R1_val_1.fq.gz trimmed/sample_R2_val_2.fq.gz \ | samtools sort -@ 8 -o sample.sorted.bam samtools index sample.sorted.bam # 给 BAM 建索引,供浏览器与区间查询用 # 统计比对结果:总读长数、比对率、dup 比例 samtools flagstat sample.sorted.bam # 输出示例: # 59126686 + 0 in total(总读长) # 57653215 + 0 (97.51%) mapped(比对率,全基因组重测序 95% 以上属正常) # 1187432 + 0 duplicates(重复读长,由 PCR 扩增产生)
命令里 -R 加的读组(read group)是给样本打的身份标签,GATK 按 SM 字段区分样本,漏写会在下游变异检测时被拒。比对率是第一个该看的体检数:人类样本低于 70% 要怀疑污染或参考版本用错。
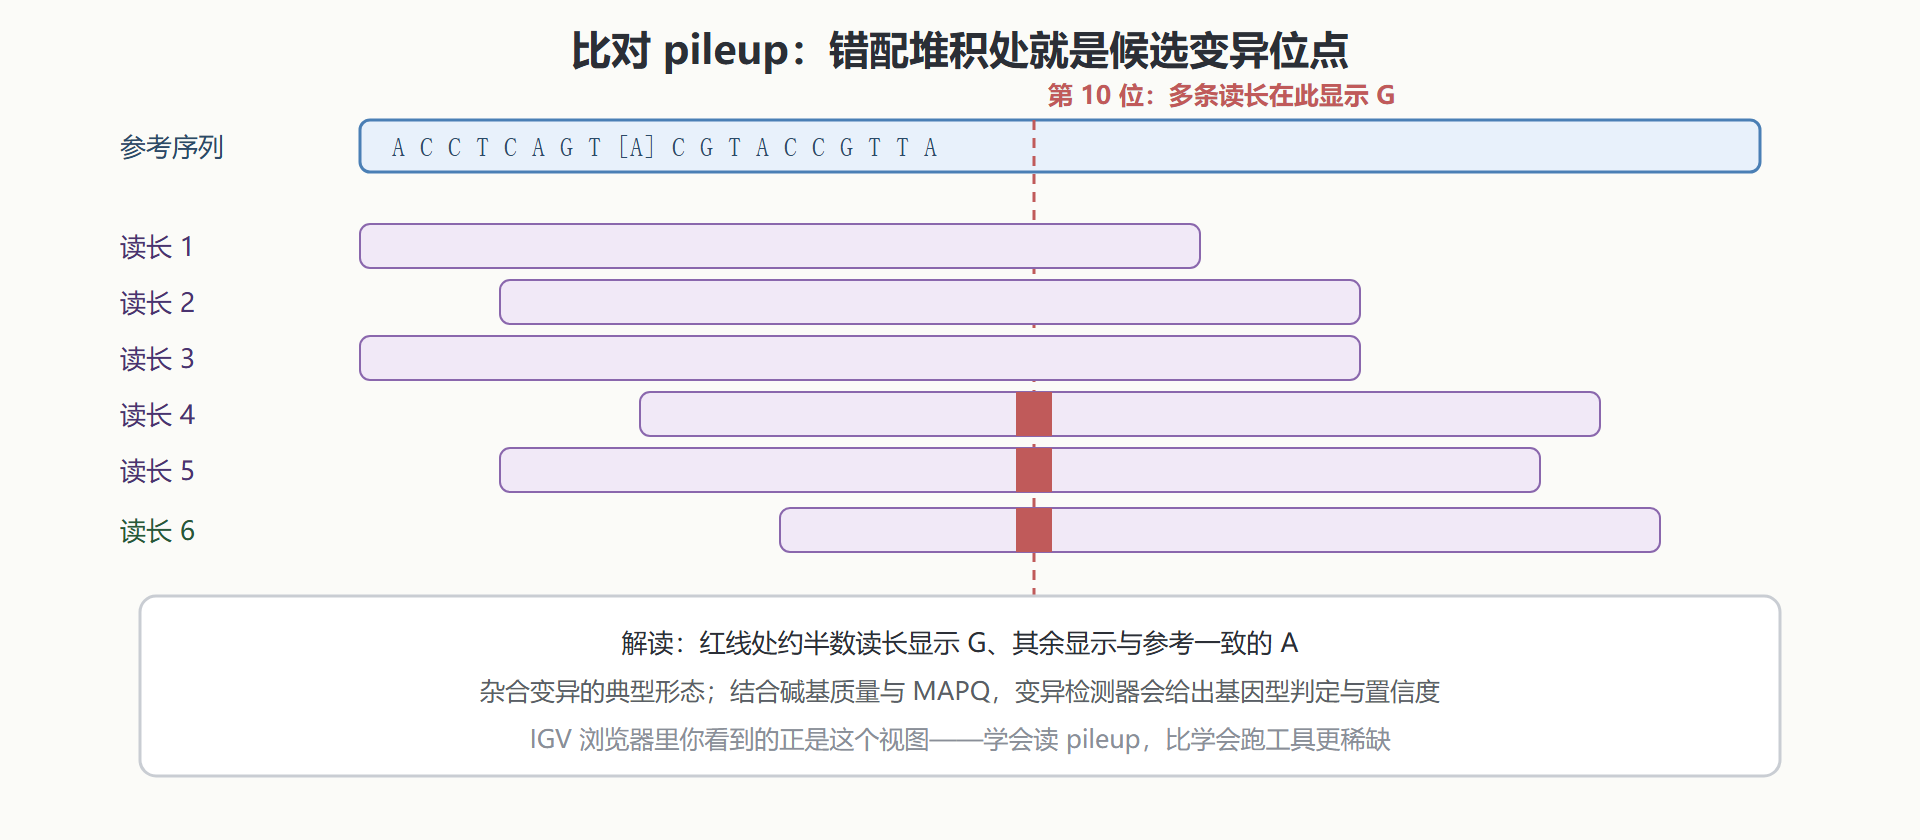
图:短读长比对到参考基因组的 pileup 视图
SAM/BAM:比对的记账本
比对结果存成 SAM(文本)或压缩后的 BAM(二进制)。每条读长一行,十一列必需字段:读长名、flag、参考序列名、位置、MAPQ、CIGAR、配对读长的 mate 信息、序列、质量值,外加任意多的可选标签。两个字段值得背下来。flag 是位掩码:数值 99 拆开是"双端、正向、mate 反向、第一端"的叠加,见旗不知义时用 flagstat 或查 flag 对照表解码。CIGAR 描述比对形态:76M 表示 76 个碱基全匹配,50M10I20M 表示中间插了 10 个碱基,30M200N46M 的 N 表示跨过 200 个碱基的内含子(RNA-seq 特有)。
# 看一条读长的原始记录(前两条) samtools view sample.sorted.bam | head -2 | cut -f1-9 # 按区域抽取:1 号染色体 11869-14409(基因 DDX11L1)上的读长 samtools view sample.sorted.bam 1:11869-14409 | head -3
排序、标记重复、建索引之后,这份 BAM 就是下游所有分析(变异、定量、覆盖度图)的统一输入。BAM 体量通常是 FASTQ 的 1.5 倍上下,集群项目要规划好存储与生命周期(分析归档后转 CRAM 可再省一半空间)。
多重定位与实战参数
基因组里有大量重复序列:同一段 150 bp 读长的序列可能在基因组出现几十次。BWA 的默认策略是保留一个"最好"位置并把 MAPQ 压到 0,让下游工具自行决定去留。这也解释了两个现象:着丝粒附近 reads 堆积如山却测不出可信变异;短读长的 RNA-seq 定量在多拷贝基因家族上系统性偏差。这些位置是短读长的能力边界,不是工具调参能根治的——真要搞清那里发生了什么,请回到 1.3 节换长读长。
bwa mem 的常用参数里,-t 是线程数,按机器核数给;默认的插入片段大小自动探测在绝大多数项目够用。要背的参数不多,但要懂原理——因为出问题时,知道原理的人能从 pileup 图反推原因,不知道的人只能换参数碰运气。
比对率与 MAPQ 的组合体检
比对完成后有一套两分钟的体检动作,能拦下绝大多数流程事故。先看比对率的构成:总体比对率正常、但唯一比对率(MAPQ 大于 30 的比例)偏低,说明参考与样本之间差异过大(近缘污染、版本错配或样本换错);总体比对率本身低,则优先怀疑污染与 Barcode 串扰。再看插入片段分布:sort 后用 samtools stats 或 picard CollectInsertSizeMetrics 画分布,肿瘤全基因组的插入片段分布应近似单峰,双峰或长尾提示建库异常。
MAPQ 的分布还要与区域联合看:高 GC、着丝粒附近、端粒区域的 MAPQ 天然偏低,属预期;若常染色质基因区大片 MAPQ 低迷,就要警惕参考版本或样本身份问题。变异检测环节对 MAPQ 有硬阈值,把体检做在前面,比在 GATK 的过滤环节反复返工划算得多。这一套动作的价值在于"把问题定位在正确的环节"——比对的问题回到比对解决,别让它伪装成下游的"变异太多"。
读长归位了。下一站先岔开一步:如果研究的物种根本没有参考基因组,坐标系从哪来——这是从头组装的问题。