2.4 没有参考怎么拼:从头组装、N50 与基因注释
2.4 没有参考怎么拼:从头组装、N50 与基因注释
本节摘要:研究新物种时没有坐标系可用,只能自己造:把海量短读长或长读长拼成完整基因组。本节讲 de Bruijn 图怎么用 k-mer 把碎片拼起来、N50 怎么衡量拼装质量、拼完之后如何给基因组做注释。
从拼图说起
从头组装(de novo assembly)面对的处境像拼一幅巨大的拼图,而且没有盒子上的成品图。测序把基因组随机打断,每条读长是一个碎片;组装的数学本质是利用碎片之间的重叠关系,把上千万个碎片重新排回原位。拼接的产物叫 contig(连续段),contig 之间若能确定顺序与朝向但中间有缺口,连成的结构叫 scaffold。目标形态是染色体级的完整组装:contig 数最少、单条最长、缺口最少。
拼图 analogy 到此为止,实际的困难在于重复序列。基因组里散布着大量完全相同或近似相同的长重复,碎片落进重复区就失去了坐标——你无法判断这段序列属于哪个拷贝。重复越长于读长,组装就必然在那里断开。这直接推出本节最重要的一条设计原则:想要组装好,先要读长长;这正是长读长平台统治组装领域的原因。
de Bruijn 图:短读长组装的经典解法
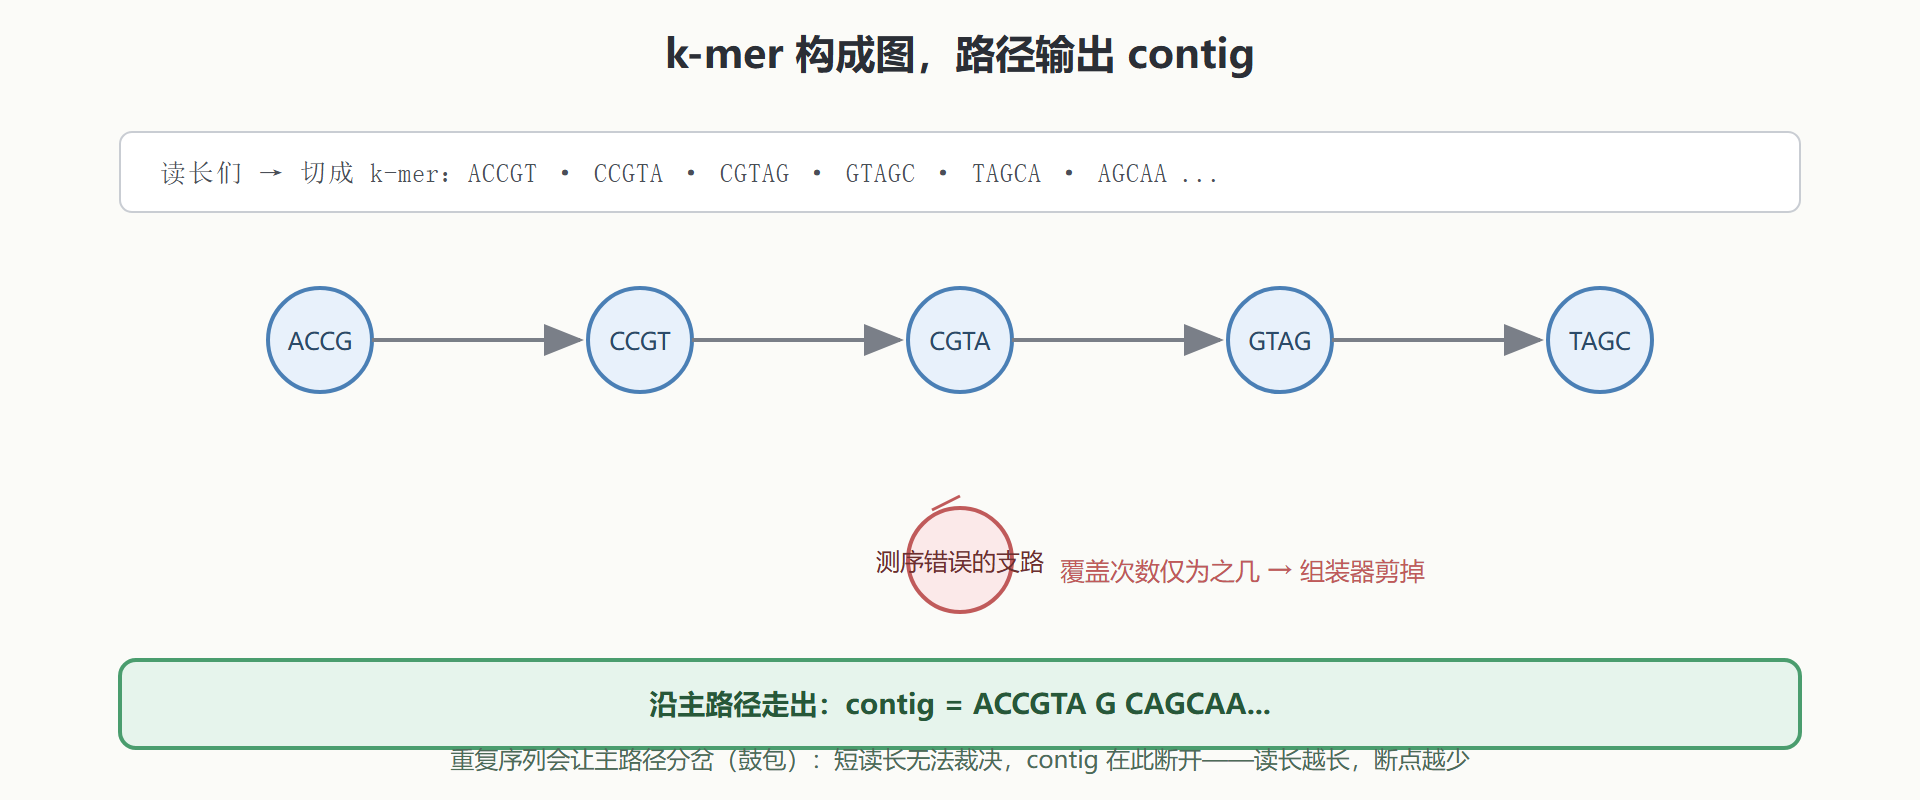
短读长组装的祖师爷算法是 de Bruijn 图。它不直接比较读长两两重叠(计算量爆炸),而是先把所有读长切成 k-mer——固定长度 k 的子串,比如 k=55。每个 k-mer 是图上的边,k-1 前后缀是节点;读长集合整体构成一张图,基因组的"真实序列"对应图中一条欧拉路径。测序错误会产生少量支路(tip),重复序列会产生鼓包(bubble),组装器清理这些结构后沿着主路径输出 contig。
参数 k 的选取是第一个工程取舍:k 小则图致密、重复导致的纠缠更严重;k 大则每个 k-mer 的覆盖变浅、低深度区域断裂。经验值取读长的 55% 到 75%,并用多个 k 值试拼对比。这套思路的代表作是 SPAdes(小基因组)与 ABySS、MEGAHIT(大基因组);元基因组项目里 MEGAHIT 几乎是默认选择。
长读长组装走另一条路:先对读长之间的重叠建立关系图(OLC 思路),或用 Hifiasm 这类工具直接以精确 k-mer 图处理 HiFi 数据,再经一至三轮"抛光"(polishing)把碱基级错误压到 Q30 以上。当前 T2T 级别的人类组装(2022 年完成)靠的就是 HiFi 加超长 Nanopore 加 Hi-C 的组合拳。
图:de Bruijn 图把 k-mer 拼成 contig 的示意
N50:给组装质量打分
怎么向导师汇报"拼得怎么样"?最常用的指标是 N50:把所有 contig 按长度从长到短排列,累加到总长一半时的那条 contig 的长度。举例:contig 长度为 90、70、50、40、30、20(总长 300),累加到 150 落在 50 这条上,N50=50。N50 越大说明序列越长、拼装越连贯。它的局限是只看长度分布、不看对错——一段被错误拼接的序列照样贡献 N50。所以正规报告会配套完整指标组:contig 总数、最长 contig、N90、缺口比例、BUSCO 完整性(用单拷贝直系同源基因评估基因区拼装完整度)。
用 QUAST 一条命令出全套指标:
quast.py assembly.fa -o quast_out/ -g annotation.gff # 报告里的关键行示例: # contigs: 1542 | N50: 1.8 Mb | L50: 312 | total length: 2.87 Gb # N50 per contig 数下降到三位数百 kb 级,对 Illumina 短读长组装已是不错的成绩
拼完之后:基因注释
组装产物是裸序列,注释赋予它含义:基因在哪些区段、外显子怎么剪、编码什么蛋白、与非编码区有哪些调控元件。三条路各取所长。同源注释:把组装序列与近缘物种的已知基因做比对,相似性转移功能——这是最可靠的一路。从头预测:用训练过的模型(如 Augustus、BRAKER)按编码区统计特征(开放阅读框长度、密码子使用偏好、剪接位点信号)直接预测基因结构,在新物种没有近缘参考时挑大梁。RNA 证据:对该物种自己的转录组数据做比对,外显子边界由真实剪接事件直接锚定,是修正预测的黄金证据。工程上通常三路并跑再用 EVidenceModeler 合并打分,得到一套基因结构集(GFF3),后续的差异表达、功能富集都建立在这份文件上。
组装的验证与精修:从草图到可用参考
初拼的组装只是半成品,三道精修工序决定它能不能当参考用。第一道是抛光:用短读长或长读长回比对,修正碱基级错误(NextPolish、Pilon 一类工具),把一致性拉到 Q30 以上——长读长组装尤其需要,indel 型错误在高同聚物区特别多。第二道是挂载:Hi-C 数据利用同细胞内染色质的空间邻近信息,把 contig 排序定向并挂成染色体级 scaffold,端粒到端粒的缺口再用超长读长或专门 PCR 补齐。第三道是去污与评估:用 BlobToolKit 按 GC 含量与比对相似性剔除污染 contig(共生菌、宿主序列),再用 QUAST 与 BUSCO 出正式指标。
验证的黄金标准是"独立证据不自洽地吻合":Hi-C 热图上染色体内的块状互作清晰、BUSCO 单拷贝基因占比接近近缘物种水平、流式细胞术估的基因组大小与组装总长一致——三条独立证据都点头,这套参考序列才拿得出手。发数据时把组装连同注释一起提交到公共库(NCBI 的基因组提交通道),换回一个正式登录号,别人引用你的基因组才有落点。
杂合与多倍体:组装里的特殊难题
有些基因组的难点不在重复而在杂合。高杂合二倍体(许多林木、药用植物杂合度可达百分之一以上)组装时,来自父本与母本的两套单倍型会被当成"两个物种"各自拼一份,组装总长虚高一倍、单倍型之间互相纠缠——经典症状是组装大小远超流式估测的基因组大小。对策是先做单倍型分相(hifiasm 的分相模式)只保留一套单倍型,或用去冗余工具把两套单倍型合并。多倍体(小麦是六个染色体组的典型)难度再上一个台阶:同源染色体组之间的序列极其相似,需要足够长的读长加分相数据才能把各组分家——多倍体组装至今仍是这个领域的珠峰项目。
💡 关键直觉:组装质量的上限在读长决定那一刻就已锁定。参数调优只能在读长允许的空间内争取最优,重复区里的断点是物理性的,不是软件缺陷。
坐标系有了、序列拼好了,下一节回到"找不同":怎么从比对结果里把变异位点筛出来、验证下来。