2.5 找不同:SNP、InDel 与结构变异检测
2.5 找不同:SNP、InDel 与结构变异检测
本节摘要:比对把读长放回了坐标系,变异检测要在堆积的证据里分辨真差异与噪声。本节梳理变异的类型学,拆解 GATK 最佳实践每一步在防什么错,并教会你读懂 VCF 这份"变异清单"。
变异的类型学
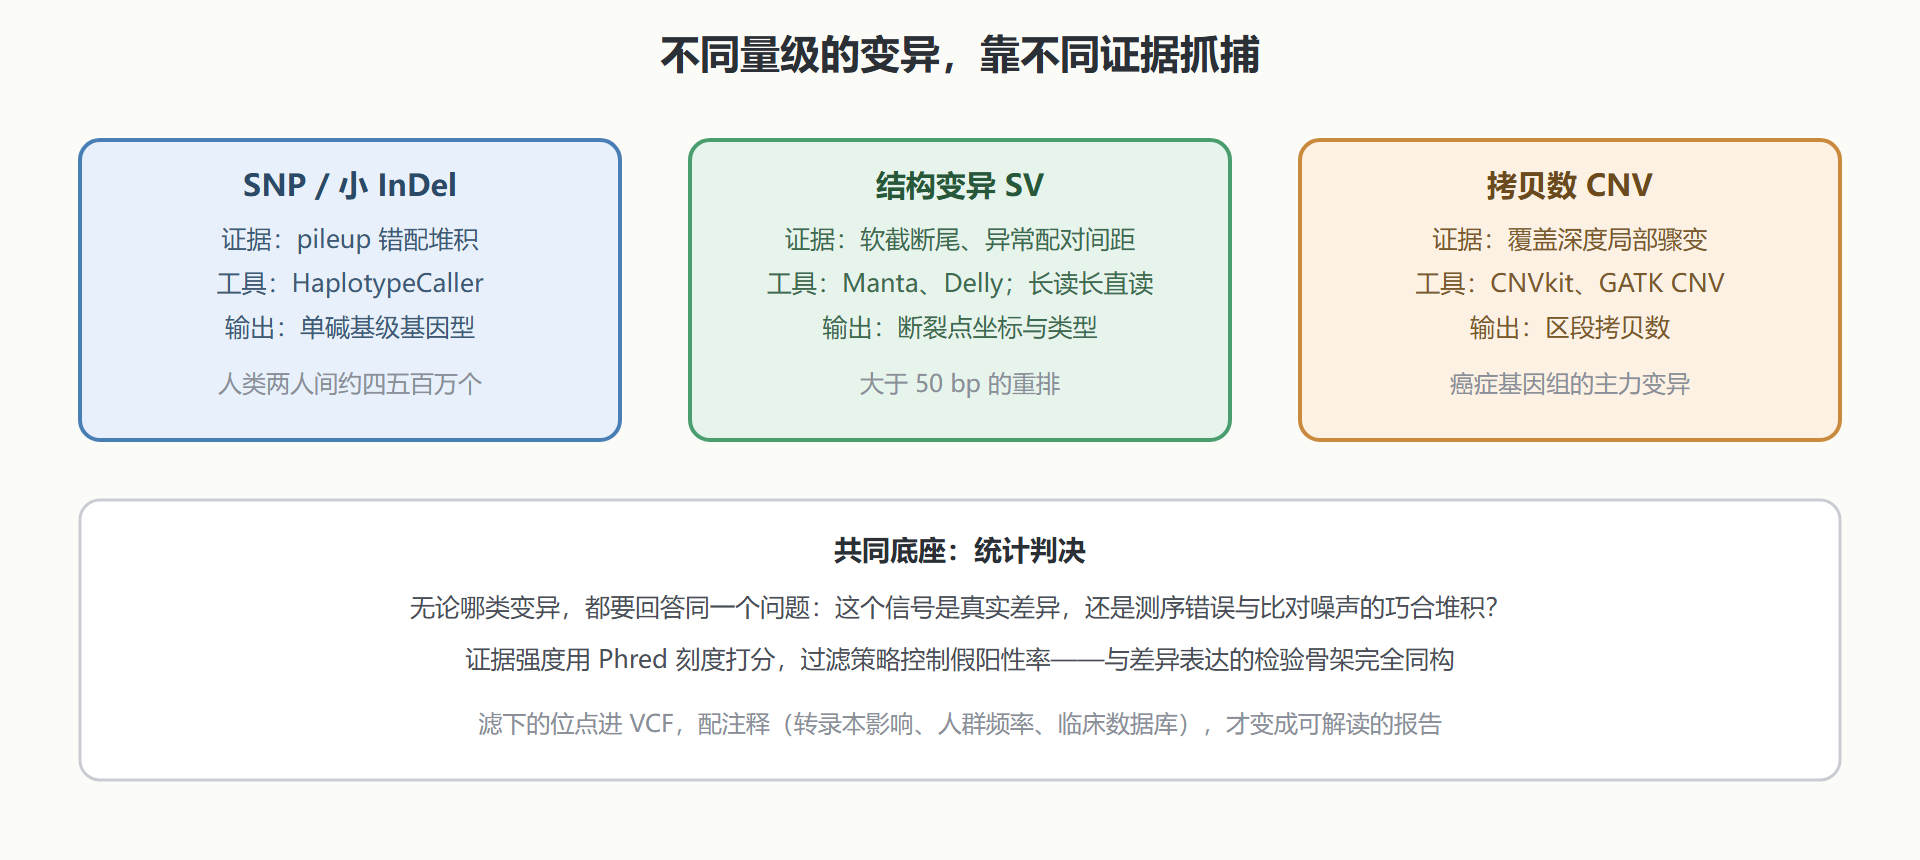
个体之间基因组序列的差异分四个量级。SNP(单核苷酸多态性):某个碱基被替换,人类任意两人之间约有四百万到五百万个,是最常见的变异类型。InDel(插入缺失):几十个碱基以内的短片段插入或丢失,数量比 SNP 少一个数量级,但因为它可能移动阅读框,对功能的影响往往更猛。结构变异(SV):大于 50 bp 的重排,包括缺失、重复、倒位、易位,以及它们的组合;单个结构变异涉及的碱基量远超 SNP,是基因组多样性与疾病的大头。CNV(拷贝数变异):整段序列拷贝数的变化,可视为结构变异的一个子类,在癌症基因组里尤其活跃——癌基因扩增、抑癌基因缺失,都是 CNV 的剧本。
量级不同,检测方法就不同。SNP 与小 InDel 从 pileup 的错配堆积里判读;结构变异要从读长的"异常行为"里推断:软截断的读长尾段在别处找到了家(易位)、比对间距异常的配对读长(缺失或插入)、覆盖深度局部骤变(CNV)。长读长把结构变异检测从"推断"变成"直读",一条读长横跨断裂点,2.3 节说的能力边界在这里兑现。
GATK 最佳实践:每一步在防什么错
GATK 是体细胞与胚系变异检测的事实标准,它的流程长不是仪式感,每一步都有明确的敌人。
标记重复:PCR 扩增让同一个原始分子产生多条读长,它们会伪重复投票、放大偶然错误。工具按比对坐标与插入片段长度识别"长得一样的家族",只留一条做主力。碱基质量重校准(BQSR):测序仪的质量值有系统性偏差——比如接尾位置的碱基质量普遍虚高。用已知变异位点(dbSNP)排除真差异后,统计每个"机器、通道、位置"组合的经验错误率,反过来修正质量值。HaplotypeCaller:不逐位点孤立判读,而是在候选区域局部重建单倍型,把读长对重建的单倍型做比对再判基因型——这解决了 Indel 附近"一位错、全盘乱"的比对噪声。VQSR:用机器学习按多维特征(质量值、链偏好、位置分布)给候选变异打分,与可信位点集的训练结果对比过滤;样本量不够时退回硬过滤——手动设置 QD、FS、MQ 等指标阈值。
# 体细胞检测的简化主线(胚系略同,把 Mutect2 换成 HaplotypeCaller) gatk MarkDuplicates -I sample.sorted.bam -O sample.dedup.bam -M dup.metrics.txt gatk Mutect2 -R grch38.fa \ -I tumor.dedup.bam -normal normal.dedup.bam \ --germline-resource af-only-gnomad.vcf.gz \ -O tumor.somatic.vcf.gz gatk FilterMutectCalls -R grch38.fa -V tumor.somatic.vcf.gz \ -O tumor.filtered.vcf.gz
图:变异类型与对应检测证据
读懂 VCF
变异检测的产出是 VCF(Variant Call Format):表头带元信息,数据区每行一个位点,前八列固定(染色体、位置、ID、参考碱基、替代碱基、质量、过滤标记、信息栏),之后每样本一列基因型。信息栏 INFO 里塞满证据统计:DP 是覆盖深度,AF 是变异等位频率,MQ 是比对质量均值。
#CHROM POS ID REF ALT QUAL FILTER INFO FORMAT sample1 1 10352 . T C 523.4 PASS DP=48;AF=0.52;MQ=60.2 GT:AD:DP 0/1:24,23:48 1 10490 . ACG A 88.1 PASS DP=33;AF=0.98;MQ=59.7 GT:AD:DP 1/1:1,31:33
读法:位点是杂合变异(基因型 0/1,深浅各半),位点 2 是纯合缺失(1/1,两份拷贝都丢了 CG)。AF 与 GT 要对照着看:肿瘤样本里 AF=0.25 的杂合位点可能意味着只有四分之一的细胞携带它——这是肿瘤纯度问题,不是检测错误。VCF 之后还要过注释这一关:这个位点落在哪个基因、改变的是错义还是无义、人群里频率多高、临床数据库里有没有记录——ANNOVAR 与 VEP 是两个主流注释器,解读环节在第 5 章的精准医疗一节展开。
硬过滤指标的字典
退回硬过滤时,每个指标都有明确的靶子,认得指标才能设阈值。常用组如下:
| 指标 | 含义 | 可疑形态 |
|---|---|---|
| QD | 每单位深度的质量分 | 低:证据摊薄,多为噪声 |
| FS | 链偏好统计量 | 高:正反链证据不均,伪影 |
| MQ | 比对质量均值 | 低:读长落点不可信 |
| SOR | 链方向比值 | 偏离 1:方向性偏差 |
| ReadPosRankSum | 变异靠读长末端的程度 | 低:末端错误堆积 |
GATK 官方文档按 SNP 与 Indel 分别给过一组推荐的初始阈值,直接拿来用即可,随后按自家数据的分布微调——把候选变异的指标画成分位曲线,选自然断点比死抄数值更稳。硬过滤的意义是守底线,别指望它优化敏感度;对临床敏感场景,宁可多留几条待验证位点,也别把真信号滤掉。
💡 关键直觉:变异检测是全流程里"错则全错"的环节。上游质控与比对的任何瑕疵,都会在这里变成一行行看似确凿的 PASS 位点——所以可信位点集与人工抽查 pileup,永远不能省。
变异之外,基因表达量的差异是另一条平行叙事:下一节从 counts 矩阵讲起,看 DESeq2 怎么把表达差异做成有统计背书的基因列表。