2.6 找差异表达基因:RNA-seq 定量与 DESeq2
2.6 找差异表达基因:RNA-seq 定量与 DESeq2
本节摘要:差异表达是问题链上被问得最多的一环:处理组与对照组比,哪些基因表达变了。本节从计数矩阵讲起,拆解 DESeq2 的中位数比归一化与负二项检验,并完整解读一次火山图。
计数矩阵:差异分析的起点
RNA-seq 数据加工到一半就换了个赛道:比对不求全,只要确定每条读长来自哪个基因,就能计数。用 featureCounts 或 Salmon 拿到的是一张 counts 矩阵——行是基因,列是样本,格子是"这个样本里这个基因被测到的读长条数"。肿瘤案例里,六列样本(三列肿瘤、三列正常)的矩阵大约两万行。
这张矩阵不能直接比较。三个坑摆在面前。测序深度不同:A 样本测了 3000 万条、B 样本测了 2000 万条,A 的基因天然计数偏多。基因长度不同:长基因容易被测到更多条,比较不同基因间的表达量必须除以长度(但比较同一基因在不同样本间的差异不必除——长度没变)。RNA 组成不同:少数超高表达基因会吃掉大量读长,压低其他基因的表观计数。三个坑叠加,决定了"先归一化、再检验"是硬顺序。
DESeq2 的归一化:中位数比法
DESeq2 的 size factor 归一化专门处理组成偏移。逻辑分四步:对每个基因算它在所有样本里的几何平均数,作为该基因的"伪参考值";每个样本用自己的 counts 除以对应基因的伪参考值,得到一列比值;取这列比值的中位数,就是该样本的 size factor——中位数天然免疫少数超高表达基因的拉扯;最后用 counts 除以 size factor,得到可比的归一化计数。
为什么不用 TPM?TPM(每百万转录本归一化)先除基因长度再除样本总量,适合回答"这个样本内部哪个基因占比高",却对组成偏移没有防御力:一组高表达基因整体上调时,TPM 会把其他基因"显得"下调,制造假的差异。找差异基因用 size factor 口径,画样本内占比图才用 TPM 口径——两个指标回答不同问题,混用是审稿意见的常客。
检验:负二项分布与多重校正
counts 是整数,方差随均值上升(高表达基因绝对波动更大),且生物学重复带来真实的天生变异——泊松分布只能管住技术噪声,管不住生物学差异。DESeq2 用负二项分布建模:均值来自组内估计,方差由"技术项 + 强度相关项 + 生物项"三部分拼成,离散度从数据本身估出。检验的零假设是"两组均值相同",输出 p 值。
两万多个基因同时检验,多重性问题必须处理:按 p 小于 0.05 的阈值放行,纯靠运气也会有上千个假阳性。Benjamini-Hochberg 法把 p 值校正成 padj(FDR,假发现率):报告通过 padj 小于 0.05 的基因,意思是"这批结果里假货预期不超过百分之五"。差异分析报告的黄金标准就是:log2 倍数变化绝对值大于 1,且 padj 小于 0.05。
library(DESeq2) # counts: 行=基因,列=样本;colData: 样本分组表 dds <- DESeqDataSetFromMatrix(countData = counts, colData = colData, design = ~ condition) # condition: tumor / normal dds <- DESeq(dds) # 估离散度 → 拟合模型 → 检验,一条命令走完 res <- results(dds, contrast = c("condition", "tumor", "normal")) summary(res) # 上调/下调各多少个(padj<0.05) deg <- subset(as.data.frame(res), padj < 0.05 & abs(log2FoldChange) > 1) deg <- deg[order(deg$padj), ] # 按校正后 p 值排序,取头部基因
图:差异表达火山图——一图看全两组比较
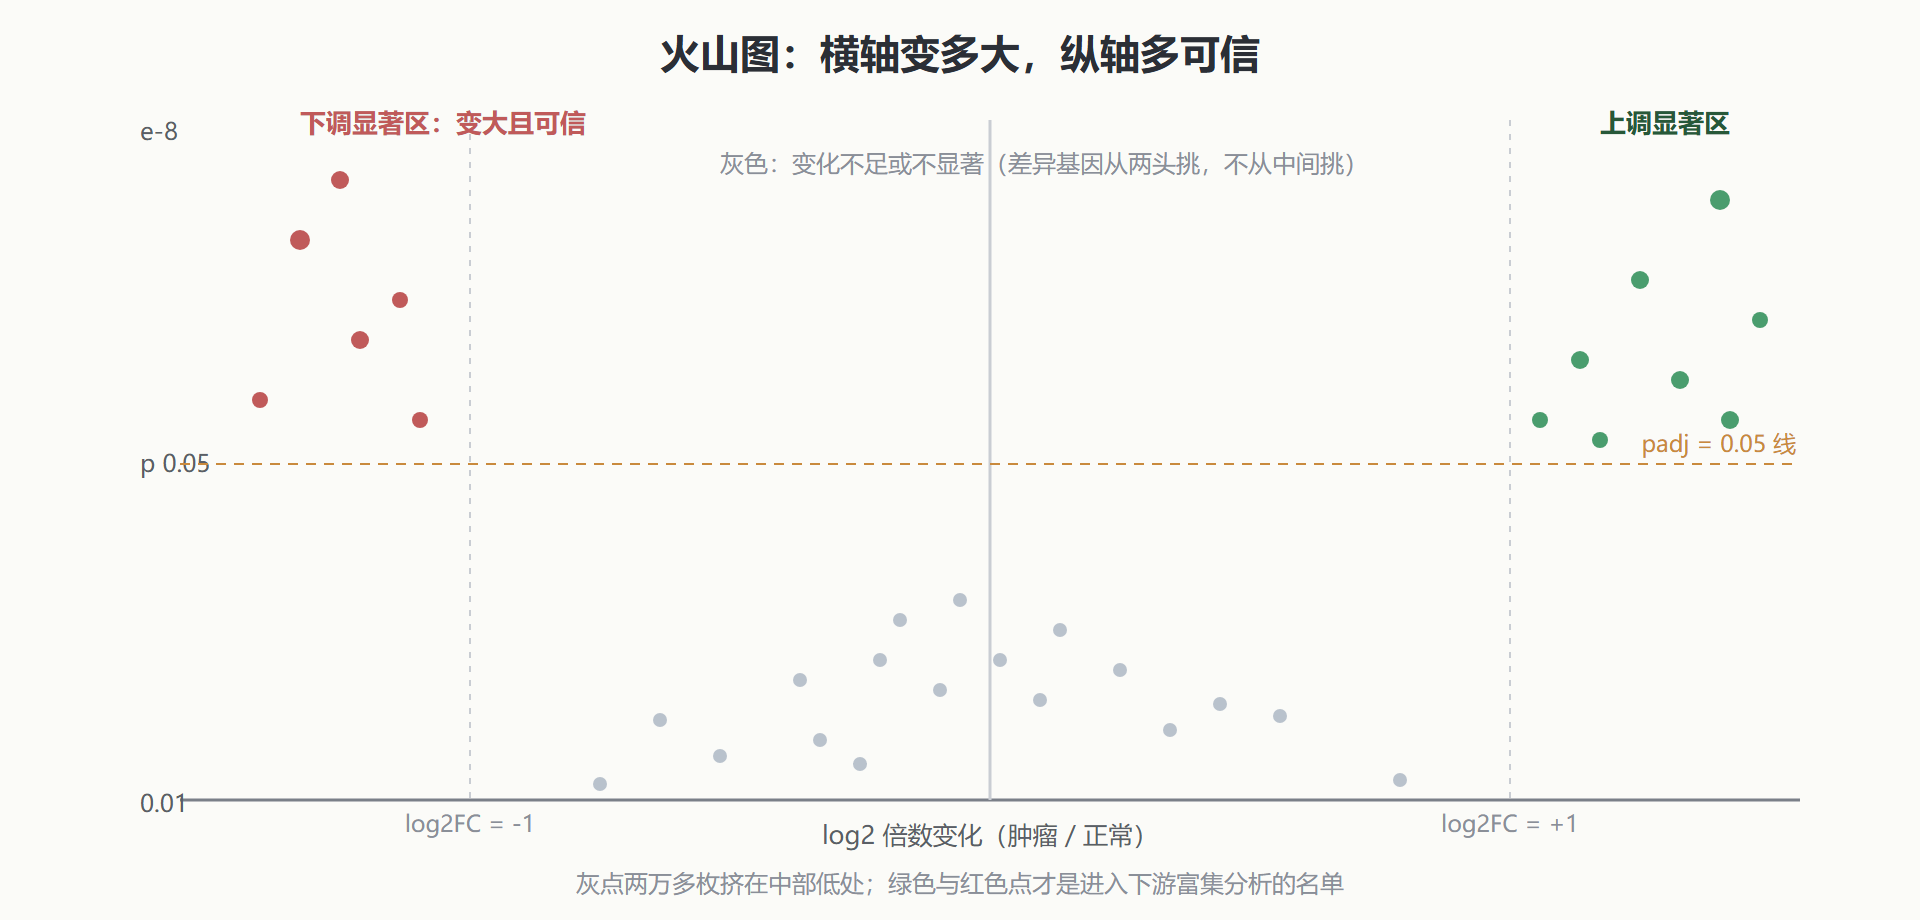
火山图怎么读,结果怎么用
火山图的横轴是 log2 倍数变化(左负右正,越靠边差异越大),纵轴是 -log10 转换后的 padj(越高越可信)。左右上角的点是"又大又可信"的差异基因——肿瘤样本里右上角常见 MYC、CCND1 这类增殖驱动基因,左上角常见正常组织特征基因。中下部灰色云团是绝大多数基因的真实处境:没变化或变化不显著。读图先看角上有没有点、再看绿红数量是否失衡,一眼即可判断数据质量:一张没有任何显著点的火山图,先回头查样本分组与批次,而不是换工具。
得到的差异基因列表还要做功能富集:把两三百个基因交给 GO 与 KEGG 富集分析,看它们是否集中在某几个通路——"上调基因富集在细胞周期通路"比"上调了 237 个基因"更接近生物学结论。通路分析的工具与陷阱在 3.6 节与第 4 章继续。
批次效应与设计矩阵:被低估的半壁江山
差异表达做砸的项目,多数砸在设计而不是算法。批次效应是头号杀手:对照组先测、处理组后测,测序日期本身就是一个与分组完全绑定的变量——模型无法把"日期的效应"与"处理的效应"分开,任何差异基因都不可信。防御的黄金原则叫随机化:两组样本穿插进同一批建库与上机,让批次与分组在统计上解绑。若批次已不可避免(样本分两批到位),至少保证每批内两组都有样本,并把批次写进设计公式:
# design 公式:把批次作为协变量吸收,再检验处理效应 design(dds) <- ~ batch + condition dds <- DESeq(dds) res <- results(dds, contrast = c("condition", "tumor", "normal")) # 若批次与分组完全嵌套,这个模型会失败——PCA 图上第一批全 tumors,没有救
配对设计是另一类常见结构:同一患者的肿瘤与癌旁配对比较。配对信息必须进设计(约上患者编号),它既控制个体间差异,也让有效样本量从"样本数"升级为"对子数"。一言以蔽之:DESeq2 的设计公式就是你实验设计的直接翻译,公式写错,后面全错——写公式前先画样本表,把每个已知变异来源(批次、供者、时间点)列成列。
💡 关键直觉:差异表达的统计框架(归一化 → 建模 → 多重校正)与变异检测、蛋白定量完全同构。学会这一节,等于同时拿到了另外两个领域的方法论钥匙。
表达差异之外还有更宏观的问题:两个物种的基因组怎么比、基因家族怎么演化——下一站把尺度拉到演化。