3.3 谱图搜库与假发现率:把错误压到百分之一
3.3 谱图搜库与假发现率:把错误压到百分之一
本节摘要:数万张谱图对几十万条理论肽段,随机误配在所难免。本节讲搜库引擎怎么打分、靶标-诱饵策略怎么估计假发现率,以及 1% FDR 为什么是这个领域的通行证。
打分:匹配得多好才算好
搜库引擎(Mascot、MaxQuant 的 Andromeda、MS-GF+、FragPipe)面对的匹配问题有个天然陷阱:理论肽段库太大,总有一些肽段"碰巧"与谱图对得上几处峰。所以打分不能只看匹配峰数,要同时看"这么好的匹配随机发生的概率"。Mascot 的经典打分是离子得分加显著性检验——报告里的分数背后是"这条匹配比随机匹配好多少个数量级"。打分还要考虑工程细节:前体质量容差(取决于仪器质量精度,高分辨 Orbitrap 可到 5 ppm)、碎片质量容差、固定修饰(半胱氨酸烷基化)与可变修饰(甲硫氨酸氧化、磷酸化)都参与理论谱的生成。
同一个样本用不同引擎搜,结果不完全一致——各家的打分函数与统计模型不同。规范做法是选一种引擎走到底并在方法部分写明版本与参数,混用引擎的结果再合并是自找麻烦。
靶标-诱饵:错误率的标尺怎么立
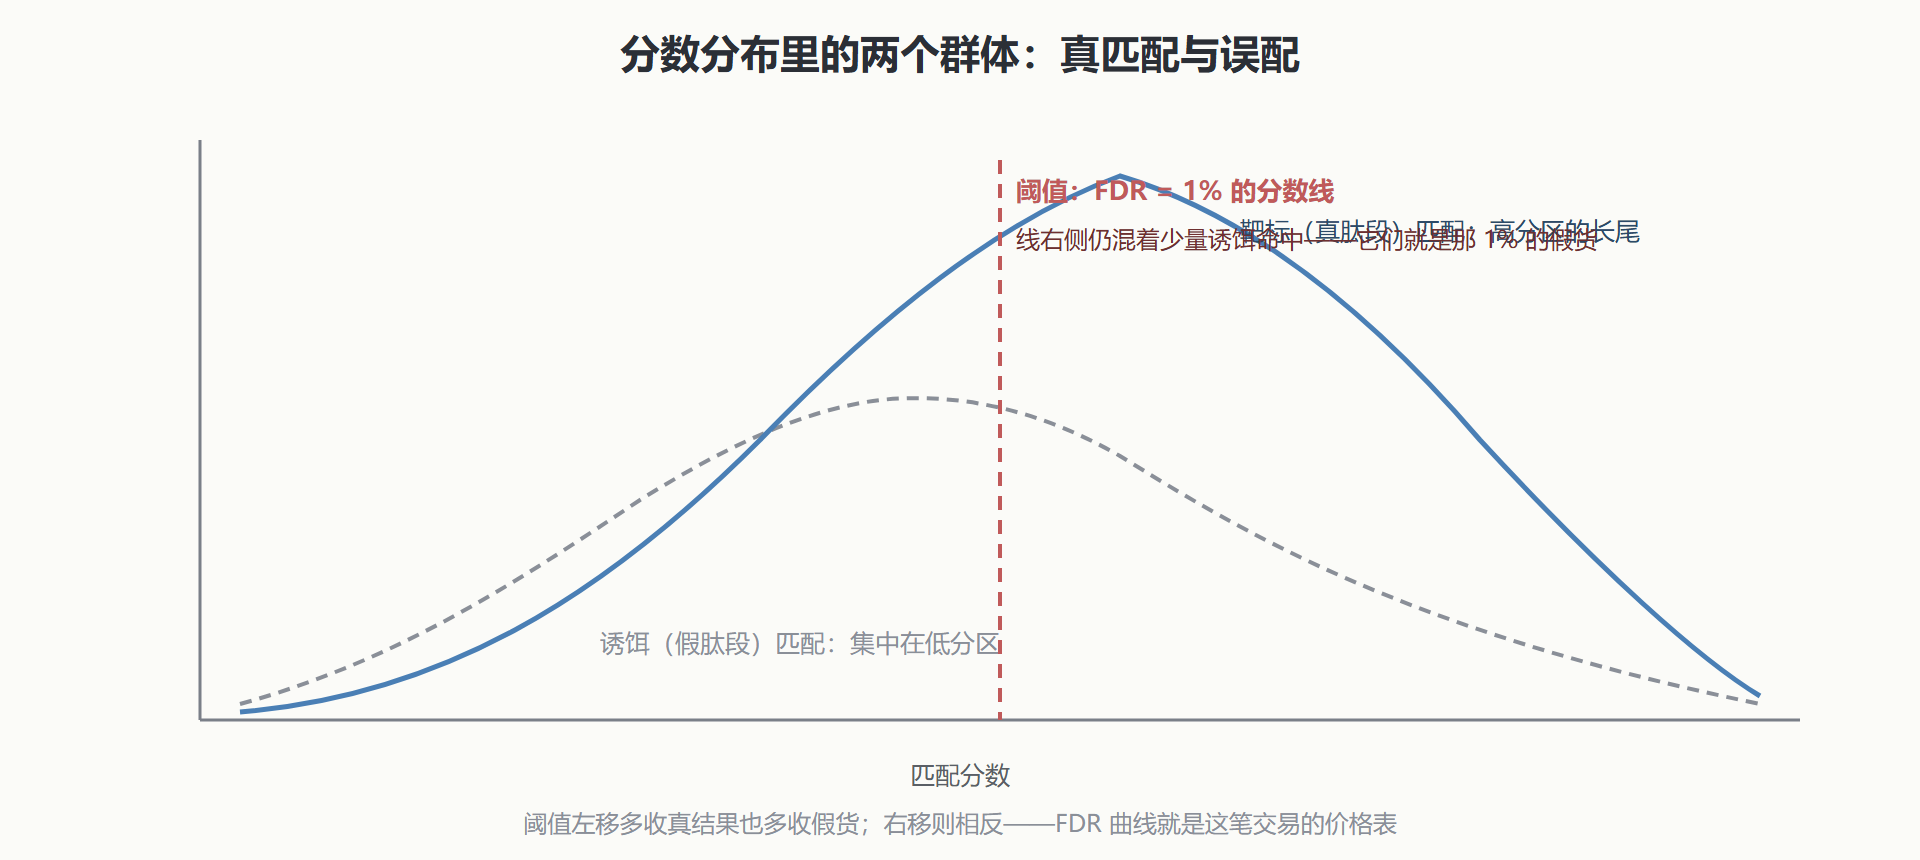
搜库报告里每条肽段匹配都有分数,但"分数多高算可信"没法拍脑袋定。靶标-诱饵(target-decoy)策略给了个漂亮的解法:把蛋白库反转或乱序,生成一套"假肽段库",真库假库合并搜。实测谱图来自真蛋白,它们匹配假肽段的概率,与匹配真库中错误候选的概率在统计上同分布——于是数一数高分区间里落在诱饵库上的匹配数,就等于数出了落在真库里的错误数。
具体算法:给定某个分数阈值,数出诱饵命中数 D 与靶标命中数 T,FDR ≈ 2D / T(乘 2 是因为靶标库是诱饵库的两倍大)。把阈值从高往低滑,FDR 逐渐上升;取 FDR 等于 1% 的位置定阈值,就得到"假货预期不超过百分之一"的肽段列表。行业默认在肽段、蛋白两级都做 1% FDR 过滤,修饰位点鉴定(如磷酸化位点)常用更严的定位概率阈值。
# MaxQuant 输出的 peptides.txt(节选)——看 PEV 与酶切质量列 sequence leadProt PEV missed cleavage charge LDEVPcSQEVK P12345 0.00012 0 2 GSHSMRYFSTSVK P67890 0.00340 0 3 SAPGGPFHyVK Q23456 0.00980 0 2 ← y 小写表示氧化修饰定位 # PEV(后验误差概率)< 0.01 对应 1% FDR;修饰位点另有 localization prob 列
图:靶标-诱饵策略的分数分布与阈值选择
FDR 的正确读法与常见误读
1% FDR 是过程属性不是单条承诺:它说的是"按这套阈值,列表整体预期有 1% 的假货",不保证哪一条具体结果必然为真。列表越长,假货的绝对数量越多——五千个蛋白的列表里预期有五十个假的,做湿实验验证时挑错对象并不奇怪。所以关键候选(要用去做功能验证的那几个)永远要人工复查谱图,或挑有独立肽段支持的蛋白。
蛋白级 FDR 与肽段级 FDR 还有个联动问题:两条肽段各自 1% 可信,但它们指向的蛋白可能共享肽段,蛋白层推断会引入新的不确定性。MaxQuant、FragPipe 在推断阶段内置了蛋白级过滤,报告里看 "Razor + unique peptides" 列即可判断证据强弱。
第二层误读是把 FDR 当 p 值。p 值针对单一假设,FDR 针对整个列表的操作特性;审稿意见里"请报告 q 值而非裸 p 值"指的就是要求给多重校正后的口径。与 2.6 节的 padj 对照着看,两个领域的统计伦理完全一致:先控制假阳性率,再谈发现。
搜库之外的路径
搜库依赖数据库,于是有两条补丁路线。谱图库检索(spectral library):把先前实验确认过的谱图存成库,新谱图直接对库匹配,速度快、假阳性低,代价是只能认出库里有过的分子——临床应用里常用它锁定标准化流程。直接打碎(DIA)数据分析则发展出以谱图库为中心的完整生态(Spectronaut、DIA-NN),定量稳定性优于传统 DDA,正成为大规模临床蛋白组的默认选型。从头测序(de novo)用于无参考物种与抗体测序这类"库里没有"的场景,长序列多肽与新型氨基酸的鉴定也是它的主场。
算一遍:阈值滑动的代价曲线
靶标-诱饵的逻辑值得动手算一遍,体会阈值与假货的交易关系。假设某次搜库在某分数段得到靶标命中 8000 条、诱饵命中 40 条,则该段的 FDR 约 2×40/8000 = 1%。把阈值放宽一档,靶标多收 2000 条、诱饵多收 30 条:新增的 2000 条真命中里,预期混着约 2×30/2000 = 3% 的假货——放宽阈值买来的增量,质量明显低于存量。反之收紧阈值,每一条新增命中都更接近金标。这条代价曲线解释了实践中的两个动作:探索性分析用 1% FDR 求广度,关键候选的确认再单独收紧到 0.1% 或人工复核谱图。
肽段级与蛋白级还有一层联动账:每个蛋白由肽段支持,肽段的证据独立时蛋白级假发现近似可加。同工酶共享肽段造成的"证据混叠"会让蛋白级推断更保守——MaxQuant 的 razor peptide 机制就是把共享肽段判给证据最强的那一家,代价是另一家可能漏报。读蛋白组结果表时,"只有 shared peptide 支持"的蛋白要在心里降档处理,这个习惯能省掉很多无谓的争论。
质量指标的日常自查
搜库完成后,除了 FDR 还有几个数字能快速判断实验质量。谱图利用率:被鉴定出肽段的 MS2 谱图占总谱图的比例,DDA 数据健康值在三到五成之间,明显偏低提示样本降解或仪器状态差。肽段长度分布:集中在七到二十几个氨基酸属正常,异常偏短提示酶切过度或非特异切割过多。漏切位点比例:胰蛋白酶切后允许两个以内漏切,漏切偏多说明酶解不完全——这是湿实验环节的反馈信号。这些指标共同构成质谱实验的"体检报告",与分析质量一起随结果归档,它们回答的是"这批数据值不值得信"。
把这套自查固化成习惯后,实验与分析之间会形成有效的反馈环:分析端发现酶切质量问题,实验端改进消化条件;分析端发现杂质谱图增多,实验端排查容器污染。质谱项目的进步速度,很大程度上取决于这个环转得快不快。
💡 关键直觉:靶标-诱饵是这个领域最优雅的统计装置——不需要知道错误长什么样,只需要往库里掺已知的假货,让数据自己把错误率供出来。这个思想在其他组学的质控里同样常见。
鉴定解决"是谁",定量解决"多少":下一节对比 TMT 标记与 label-free 两条路线。