3.4 蛋白质定量:TMT 标记与 label-free 两条路线
3.4 蛋白质定量:TMT 标记与 label-free 两条路线
本节摘要:鉴定回答"是谁",定量回答"差多少"。本节拆解 TMT/iTRAQ 多通道标记与 label-free 自由定量的原理、适用场景与统计陷阱,并给一次差异蛋白分析画出完整路线。
定量的两难处境
质谱定量有一个先天麻烦:离子化效率因肽段的序列、修饰、共流出组分而异,同一肽段两次跑,信号可以差出数倍。也就是说,绝对信号强度不是可靠的丰度读数。领域内两条路线各自绕开这个麻烦的不同侧面:标记定量把要比较的样本"绑在同一次实验里",让仪器误差作用于所有样本时彼此抵消;label-free 则接受信号波动,用跑多次、算统计的方式把它平均掉。
TMT:同池比较,通道互补
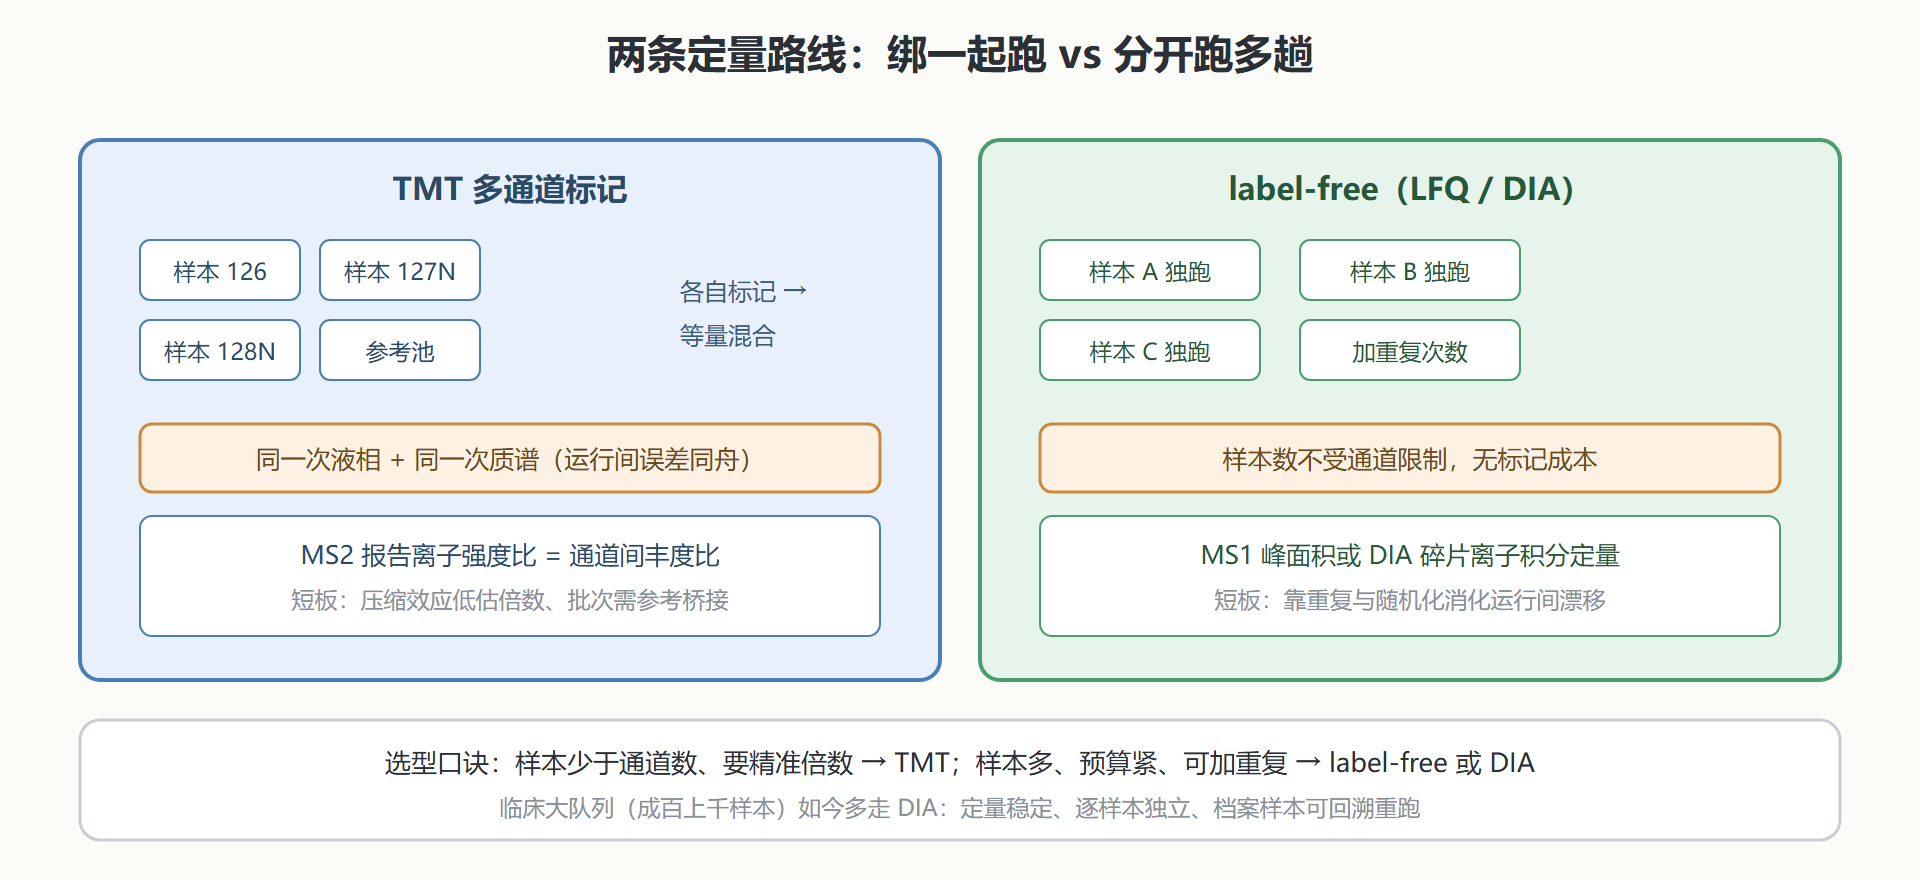
TMT(tandem mass tag)是一组化学标签,现在常用 16 通道(TMTpro)甚至 18 通道版本。每个通道质量标签不同但总质量相同(同位素组合方式不同),样本各自标记后等量混合、同一次液相与质谱运行里被分析。一级质谱里它们并成一个峰(质量相同),二级碎裂时报告基团释放出各通道特征质量的报告离子——报告离子的强度比就是各通道的丰度比。核心优势是消除运行间误差:比较在仪器同一次进样里完成,批间漂移不再是变量。
代价同样明确。通道内压缩(ratio compression):共流出肽段混杂进报告离子,把真实差异往 1 附近拉——实测倍数变化系统性被低估,通常要往更严的阈值上卡。批次设计复杂:超过通道数的样本要拼批次,每批必须留一个公共参考通道做跨批桥接,参考通道安排不好,跨批比较就失去锚点。成本与失败风险:标记试剂贵,混合前的定量不准则通道间不等量,直接污染全部比较。
图:TMT 多通道标记与 label-free 定量路线对照
label-free:用统计驯服漂移
label-free 定量两条技术子路:DDA 模式下用峰面积或光谱计数,DIA 模式下对每个肽段的全部碎片离子积分。DIA 把扫描窗口轮转覆盖全部离子,缺失值大幅减少,定量系数变异通常能压到 15% 以内——这正是大队列项目倒向 DIA 的原因。label-free 的统计要求更高:每组至少三个生物学重复(五个更稳),样本进样顺序随机化以打散漂移,批次之间用 pooled QC 样本监控信号衰减。做完这些,用 t 检验加 BH 校正(或 limma 这类线性模型)做差异检验——框架与 2.6 节的 RNA-seq 差异分析同构,只是把 counts 换成了丰度值、把负二项换成对数正态近似。
一次差异蛋白分析的完整过程
以"药物处理前后细胞蛋白组变化"为例走一遍。设计:处理组与对照组各三个重复,TMTpro 16 通道,多出的通道放公共参考池。上机:SPS-MS3 采谱抑制压缩效应(只对高置信肽段做三级定量)。分析:Proteome Discovery 或 FragPipe 搜库定 FDR 后,做组内归一化(每通道总量归一)、差异检验、BH 校正。结果解读:假设拿到 42 个下调蛋白,GO 富集显示剪接体通路集中下调,Western blot 验证其中剪接因子 SF3B1 的变化——到这里才算一条完整证据链。常见失误是不做生物学重复(每组一条样本,任何统计都无从谈起)、以及拿技术重复冒充生物学重复(同管混样测三遍,算不出组间差异的显著性)。
跨批桥接:参考通道的设计账
TMT 的通道数有限,大队列必须分批,批与批之间靠公共参考池桥接:每批留出相同的通道给所有样本等量混合的参考池,分析时把每个样本的信号除以本批参考信号,得到跨批可比的相对值。参考池的调制质量决定整批数据的成败——它必须在每个通道都被测到足够深度,且本身稳定(等量混合、充分匀质)。
设计与分析各有一条纪律。设计上,参考池要覆盖全部批次且用量一致;关键比较(处理与对照)尽量安排在同一批内,跨批只安排次要比较。分析上,桥接之后还要做批次检查:把每批的参考通道信号画成分布,批间系统性偏移要再校正(常用的做法是对数空间下做分位校正或线性模型吸收批次项)。跳过桥接直接把不同批的 TMT 数据拼在一起比较,是蛋白组定量最常见的不可挽回错误——数据看起来完整,比较全部失真。
回顾整个定量流程,可以发现它把 2.6 节 RNA-seq 的骨架完整重演了一遍:归一化(size factor 对应通道归一/桥接)、建模(负二项对应线性模型或 t 族检验)、多重校正(BH 校正原样照搬)。领域间的通用骨架不是巧合——高维计数或丰度数据的统计问题本来就长着同一张脸。差异蛋白结果的下游通路解读,照搬 3.6 节的网络与富集流程即可,把基因 ID 换成蛋白 ID、把转录水平的解释换成丰度与活性的解释,其余几乎不用动。
缺失值:蛋白定量数据的特殊形态
与转录组不同,蛋白定量矩阵里有大片"缺失"——某个蛋白只在部分样本里被鉴定到。缺失的机理是"逢低必失":丰度低于当次采谱探测线的蛋白时有时无,属左删失数据而非随机缺失。这决定了缺失值的处理纪律:不能用全均值填充了事(会把系统性的低丰度信号造出来);正确的做法要么是只在"多数样本中稳定鉴定"的蛋白子集上做统计,要么用显式建模左删失的填充策略(从低丰度区域的经验分布里抽样填充并标记)。
报告差异蛋白时把缺失模式一起交代,是这套数据的行规:一个"在处理组缺失、对照组全部检出"的蛋白,与一个"两边各检出半数"的蛋白,证据强度完全不同——前者可能是真实的表达关闭,后者多半是探测线附近的抖动。审稿人问"缺失怎么处理的",答得出机理与策略的项目才能过这一关。
倍数变化的表述也有讲究:蛋白组的倍数变化天然偏保守(压缩效应、离子化差异),报告里常看到的显著差异蛋白倍数变化只有小数点后几位的对数值,这与转录组动辄数倍的差异形成对照。解释时不要把蛋白组的小倍数当成"效应弱"——在蛋白层面,百分之几十的丰度变化已足以改写通路活性,修饰层面的开关效应更是在丰度数字完全看不到的地方。
💡 关键直觉:蛋白定量的统计学与 RNA-seq 一脉相承——归一化、建模、多重校正三步曲换汤不换药。差异在技术噪声结构:这里的敌人是离子化效率与批次漂移,不是测序深度。
丰度变化只是蛋白调控的一半:下一节看修饰——同样多的蛋白分子,加上磷酸基团就是另一台机器。