3.5 翻译后修饰:磷酸化如何改写蛋白命运
3.5 翻译后修饰:磷酸化如何改写蛋白命运
本节摘要:翻译后修饰(PTM)让同一份蛋白清单演绎出无穷的状态组合。本节聚焦最主要的修饰类型,讲修饰组学的三件套——富集、定位、定量——并解释为什么修饰分析是信号通路研究的利器。
为什么修饰是第三层调控
基因组给定了蛋白的氨基酸序列,翻译过程决定了它是否被制造,而 PTM 决定它此刻的状态:磷酸化像开关,一秒内接通或切断酶活性;泛素化像标签,决定蛋白被蛋白酶体销毁还是被转运;糖基化像工牌,指挥蛋白去哪个细胞区室;乙酰化既调组蛋白的可及性,也调代谢酶的活性。同一个细胞里,蛋白总量在小时级缓慢变化,修饰网络在秒级疾速响应——药物刺激后几分钟,磷酸化图谱已经面目全非,而蛋白总量还没来得及动。
修饰的规模值得记住:人类蛋白上已知的磷酸化位点超过二十万个,单个蛋白可以被多个位点、多种修饰叠加调控——组蛋白尾巴上密布十几个可修饰残基,它们的组合构成"组蛋白密码"。修饰位点大多不在固定序列基序里,这就决定了修饰分析不能靠序列扫描,必须靠质谱实测。
图:同一条蛋白链上的三类修饰及其后果
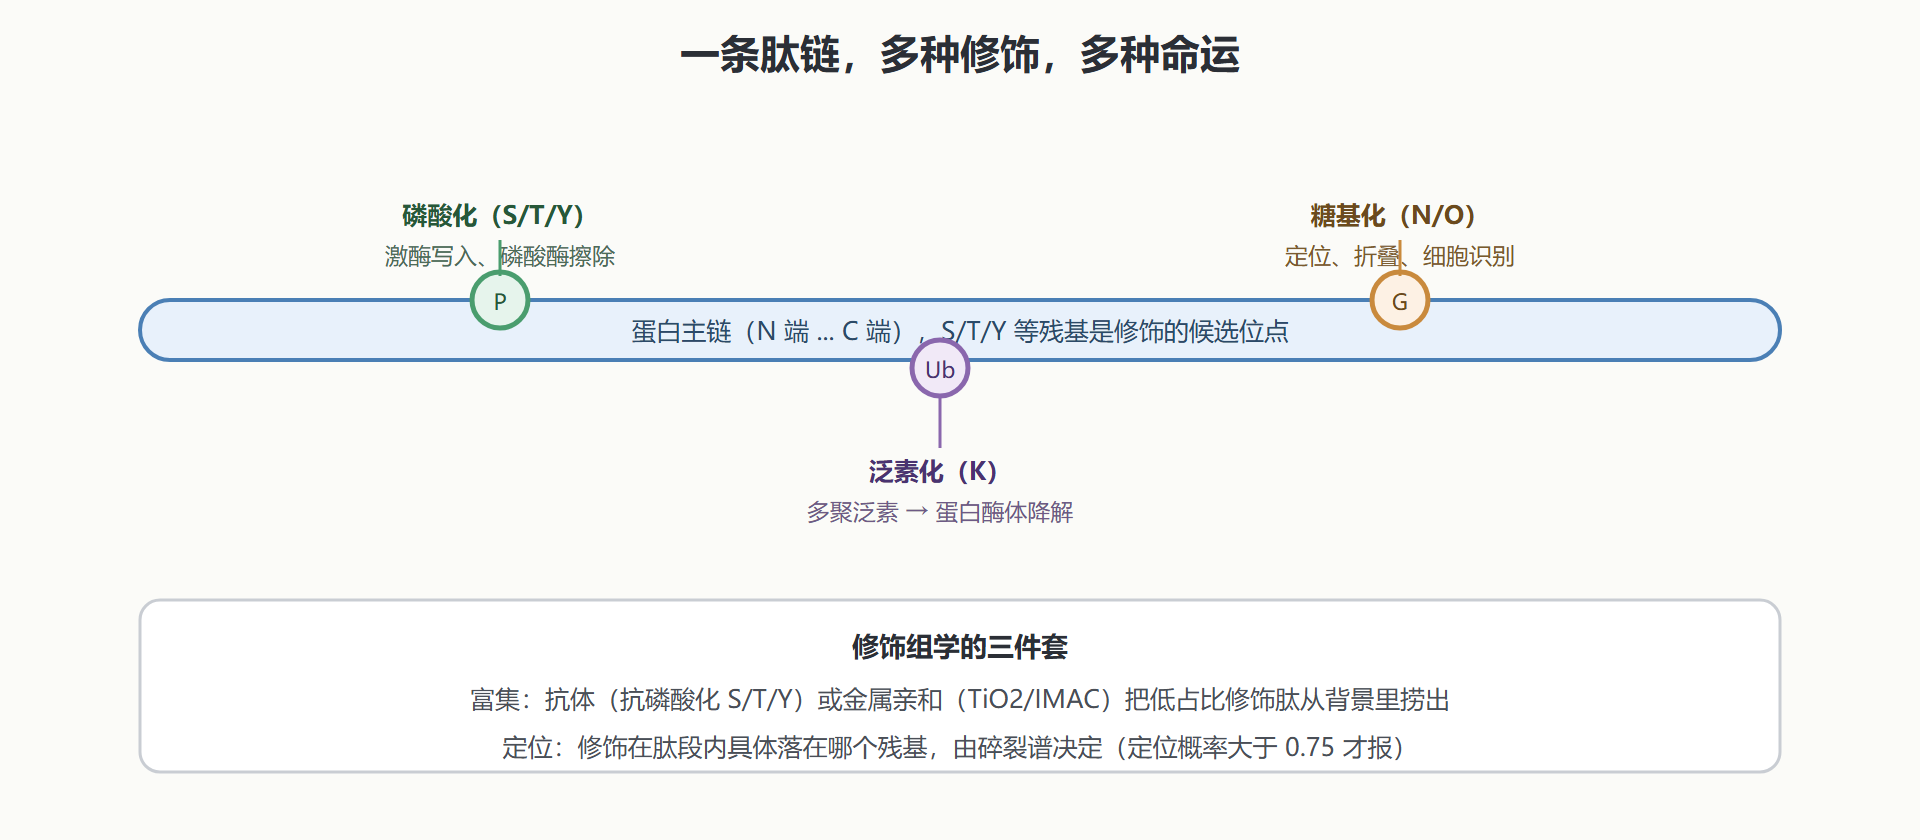
修饰组学三件套
富集:磷酸化肽段在全肽段里通常只占几个百分点,不富集根本采不到。磷酸化用特异性抗体(抗 pSer/pThr/pTyr)免疫沉淀,或用 TiO2、IMAC 金属亲和材料吸附负电性的磷酸基团;糖基化用凝集素或酰肼化学捕获;泛素化则借助 K-ε-GG 残基抗体——胰蛋白酶切过泛素化位点会留下这个特征二肽,抗体验之。富集是修饰分析的入场券,跳过富集谈修饰定量等于在噪声里找信号。
定位:富集拿到"这条肽段带着修饰",还要回答"修饰落在肽段的哪个残基"。答案藏在碎裂谱里:覆盖修饰位点的 b/y 离子会带着质量偏移,计算每个候选位点的证据强度得到定位概率,行业惯例只报告概率大于 0.75 的位点(Class I)。定位不清的位点写进论文会被审稿人抓住——序列基序分析、激酶底物预测全建立在定位正确的前提上。
定量:修饰定量几乎都走 TMT 或 DIA。比总蛋白定量多一步归一化:修饰水平 = 修饰肽丰度 ÷ 对应蛋白总量。跳过这一步是新手最常见的错误——磷酸化"上调"可能只是蛋白总量涨了,通路根本没被激活。
一次磷酸化分析的完整过程
以 EGFR 抑制剂处理肿瘤细胞为例。设计:药物处理与对照各三个生物学重复,处理设时间梯度(处理五分钟与三十分钟)。实验:裂解、酶解、TMT 标记混合、TiO2 富集磷酸化肽、高分辨 LC-MS/MS 采谱。分析:搜库时把磷酸化设为可变修饰,位点定位概率过滤,修饰水平按蛋白总量归一,组间比较做 BH 校正。结果:五分钟即出现数百个位点的显著变化,Motif 分析发现富集出 MAPK 底物的 SP 基序,激酶底物富集分析(KSEA)把变化归因到 ERK 通路的活性骤降——这一条链就是信号通路研究的标准叙事。配体刺激、抑制剂处理、突变细胞系的比较,全都套这个框架。
从位点清单到通路叙事:基序与激酶归因
修饰分析产出的位点清单要再加工两步才能变成通路故事。第一步是基序分析:把全部显著变化的修饰位点周围序列抽出来做多序列比对,统计哪些氨基酸模式富集——以丝氨酸-脯氨酸(SP)基序的富集为例,它直接指向 MAPK 家族的底物偏好,等于从数据里"认出"了作案的激酶家族。基序工具(motif-x、MoMo 一类)的输出要与已知激酶的底物基序库对照,认亲要有依据。第二步是激酶归因:把变化位点映射到已知的激酶-底物关系库(如 PhosphoSitePlus 的知识库),用 KSEA 一类富集检验评估每个激酶的底物整体偏移——底物集体下调的激酶推断其活性受抑。归因结果再与药理学证据(抑制剂处理)交叉验证,"哪个激酶在响应中起作用"就有了数据闭环。
资源层面值得收藏的几件工具:位点知识库(PhosphoSitePlus 收录文献 curator 的位点与调控注释)、通路叠加(把修饰变化画进通路图看级联的哪一级在动)、网络推断(激酶-底物网络与 3.6 节互作网络的叠合)。修饰组学分析的大部分技术难度不在跑工具,而在把三层证据(位点变化、基序偏好、知识库归因)拧成一条自洽的叙事线——这正是审稿人评估这类论文时反复掂量的地方。
富集方法的选型与坑
修饰富集的三条技术路线各有脾气,选错路线等于白做。抗体富集(免疫沉淀磷酸化肽)特异性最高,尤其是酪氨酸磷酸化——酪氨酸位点在总磷酸化里只占几个百分点,金属亲和材料抓不住,必须靠高质量抗体;代价是抗体批次间差异要监控。金属亲和(TiO2、IMAC)通量最高、成本低,是丝氨酸/苏氨酸磷酸化的默认选择;坑在与酸性肽段的非特异结合,上样前的酸化与洗涤条件要优化。结构类似的新路线(如磷酸化肽段树脂)在特定场景各有胜负,工程上"选一种走通、固定下来"比"每种都试"重要。
糖基化的富集又是另一套逻辑:糖链结构多样,化学法(酰肼捕获)与凝集素法(按糖型亲和)各取所需,且糖基化肽段的谱图解析本身就是专门学问——糖链的碎裂规律与肽段不同,分析工具链(糖蛋白组专用搜库)独立成派。泛素化用 K-ε-GG 抗体富集的策略是"借道设计"的范例:不直接抓泛素,而是抓住酶切后留在底物上的泛素残基指纹。修饰组学做到深处,分析人员对湿实验环节的理解深度,直接决定数据解读的 ceiling。富集方法的选型逻辑顺带回答了一个常见疑问:为什么修饰组学的定量重现性不如总蛋白组?因为修饰分析多了一道富集工序,每一道物理操作都引入变异来源——抗体批次、富集回收率、洗脱条件。对策是把上样量与内标标准化,并在分析端把批次变异建模吸收;理解了变异从哪来,就不会对修饰数据的统计要求掉以轻心。
富集方法的选型逻辑顺带回答了一个常见疑问:为什么修饰组学的定量结果重现性不如总蛋白组?因为修饰分析多了一道富集工序,每一道物理操作都带来变异来源——抗体批次、富集回收率、洗脱条件。对策是把富集后的等量合并、内标加入这些动作标准化,并在分析端把批次的变异项建模吸收。理解了变异从哪来,就不会对修饰数据的统计要求掉以轻心。
💡 关键直觉:总蛋白组是"演员名单",修饰组是"现场剧本"。想知道细胞此刻在做什么,看修饰;想知道细胞能做什么,看总量。
修饰讲了单体蛋白的状态,下一节把蛋白连成网络:谁跟谁互作、信号沿着哪条线传递。