3.6 蛋白质相互作用网络:从复合体到通路
3.6 蛋白质相互作用网络:从复合体到通路
本节摘要:蛋白不是孤军,功能在复合体与网络层面涌现。本节讲两类主流互作检测技术的数据形态、互作网络的构造与读法、以及 hub 蛋白与富集模块在疾病研究里的用法。
互作数据从哪来
大规模互作数据主要出自两类技术。酵母双杂交(Y2H):把诱饵蛋白绑在转录因子的 DNA 结合域、猎物蛋白绑在激活域,两者若在酵母核内结合,报告基因就表达——物理结合的二元测试,适合系统性地扫描"谁和谁能结合"。它的偏差也清楚:膜蛋白与分泌蛋白进不了细胞核测不了,自激活会造成假阳性,文献里大规模 Y2H 数据的假阳性率常在五成上下,必须靠重复与正交验证清洗。
亲和纯化加质谱(AP-MS):给目标蛋白挂上标签(FLAG、GFP),从细胞里把复合体拉下来,质谱鉴定一起被拉出来的所有蛋白。它的产出是"复合体成员名单"而非二元配对——更贴近生理状态,但区分直接结合与间接结合(A-C 互作可能只是因为 B 把它们拉一起)要靠对照与定量。近年热蛋白组剖析(thermal shift)、邻近标记(BioID/APEX)补上了瞬时与微区互作的空白。公共库里,BioGRID 与 STRING 汇总了文献与高通量数据,STRING 还把基因组共邻接、共演化、共表达等间接证据折成综合分数——用它时要分清哪些边是物理结合、哪些只是功能关联。
网络怎么构造、怎么读
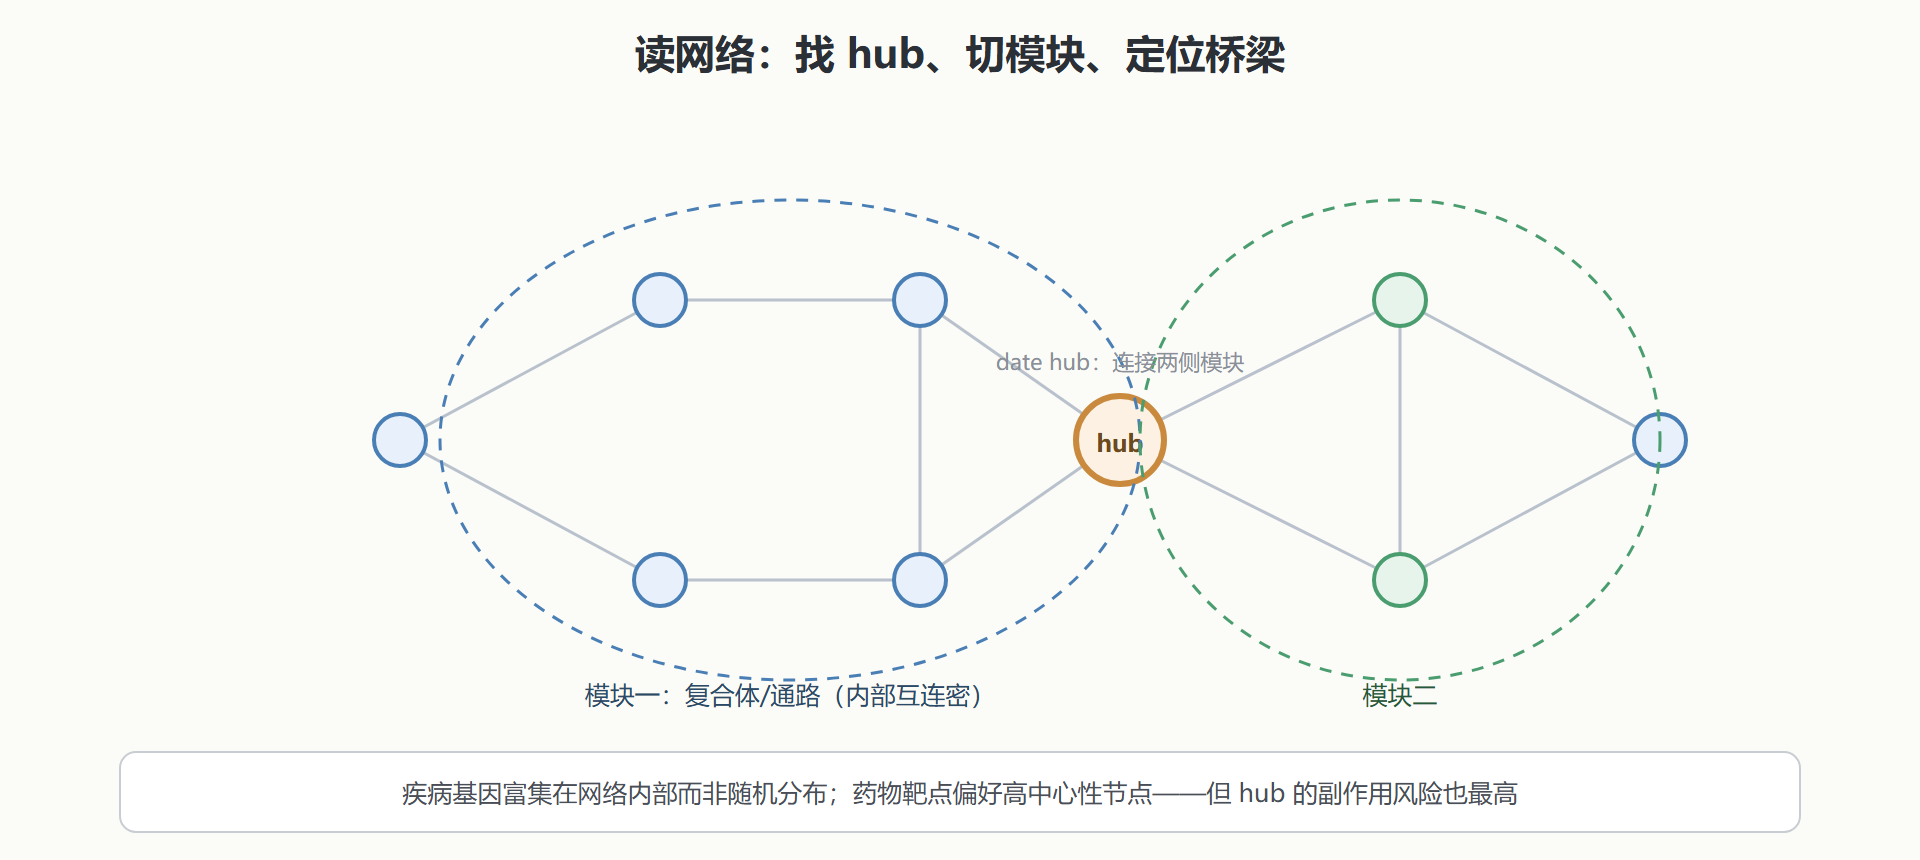
拿到互作列表,以蛋白为节点、互作为边建图。读网络有四个惯用视角。度(degree):一个节点连了多少边,度高的叫 hub。中介中心性(betweenness):一个节点出现在多少条最短路径上,高的往往是模块之间的桥梁。聚集系数(clustering):邻居之间互连的密度,高的区域暗示复合体或功能模块。模块(module/community):内部互连紧密的子图,常用 Louvain 等算法切分。
hub 有两种,性质截然不同:_party hub_只在一个复合体内部与大量伙伴互作(如核糖体蛋白),_date hub_连接多个不同模块、在不同时间地点与不同伙伴结合(如信号节点)。敲除 date hub 的表型通常更剧烈——它承载了模块间的信息流。这个区分对解释"为什么有些 hub 不能碰、有些 hub 敲了没事"非常关键。
图:互作网络的结构视角——hub 与模块
差异蛋白 → 网络 → 通路:一次完整解读
回到肿瘤案例:第 2 章得到二百多个差异表达基因,第 3.4 节得到八十多个差异丰度蛋白。把两份名单映射到 STRING 网络,提取最大连通子图后切模块:一号模块聚集了核糖体与翻译起始因子(上调,对应肿瘤的高增殖),二号模块聚集了 MHC-I 抗原呈递组分(下调,对应免疫逃逸)。模块级别的解读立刻把"两百个散点"压缩成两条可陈述的生物学结论——这正是网络分析的价值:把基因列表升维成结构信息,让通路层面的故事自己浮出来。
功能富集是网络的孪生兄弟。GO 与 KEGG 富集检验(超几何检验加 FDR 校正)回答"这份名单是否聚集在某类功能上";GSEA 这类排序富集方法更进一步,不设显著性阈值、直接拿全基因组的排序算富集分数,规避了"阈值卡在哪"的争议。GSEA 的 leading edge 子集还能指认驱动富集的具体基因——差异分析与网络分析的接口就在这里。
网络数据的清洗与偏差校正
大规模互作数据不能直接入网,先过三道清洗。去本底:AP-MS 的对照(空标签、无关抗体)拉下来的杂蛋白(常见污染物是细胞骨架与核糖体蛋白)要从结果里扣除,SAINT 一类工具按对照与样本的丰度比对打分。去冗余:同一复合体在不同实验里被反复鉴定,按证据合并成稳定的边。标注证据等级:文献整理的边与高通量实验边分开存放,解读时分开对待——文献边假阳性低但发表偏倚重(热门蛋白的边密度虚高),高通量边覆盖广但噪声高。
发表偏倚值得单独点名:网络里度数最高的节点往往不是"最重要的蛋白",而是"被研究最多的蛋白"。用 STRING 这类汇总库时,把"实验证据"与"文献挖掘"证据分开过滤,能显著降低这种热度偏差。任何以度数为中心的下游分析(hub 识别、药物靶点偏好),都要先自问:这个 hub 是结构性的,还是人气的?
富集检验:把超几何分布算明白
网络与通路分析的核心统计是超几何富集检验,值得把这笔账算透。设背景是两万个基因,其中三百个属于细胞周期通路;你的差异清单有两百个基因,其中十二个落在细胞周期。问:若差异基因是随机抽取的,命中通路的期望是 200 × 300/20000 = 3 个,实际命中 12 个——超出期望这么多倍的概率有多大?超几何分布直接给出这个尾部概率,算出来若小于 0.001,说明这份清单确实向细胞周期富集。
算完单条通路还要做多重校正:GO 的几千条通路同时检验,不加校正必然"处处富集"。BH 校正(与 2.6 节同一公式)后报告的 q 值才是可引用的数字。解读富集结果还有两条纪律:背景集必须与实验语境一致(用你检测到的两万个基因做背景,而不是库里全部基因——背景错,一切白算);富集到的通路之间高度重叠(GO 的层级结构决定了这一点),报告时按层级剪枝,别把同一信号的不同层级当独立发现罗列。可视化上,富集结果常用气泡图呈现——横轴富集倍数、纵轴负对数 q 值、气泡大小对应基因数,一张图排完十几条通路,是通路分析的标准出场方式。
💡 关键直觉:互作网络的力量不在单条边,而在结构。单看"蛋白 A 与 B 互作"价值有限;"差异蛋白聚集成一个免疫逃逸模块"才是可以写进论文讨论的句子。
网络给了功能的宏观图景,下一节下潜到最微观的层面:氨基酸序列如何折叠成结构,以及 AlphaFold2 如何把这道难题变成日常工具。