第 8 章 稳态运行:性能、测试与监控
第 8 章 稳态运行:性能、测试与监控
章节摘要:本章跟着一条性能曲线走——上线后接口耗时为什么缓慢爬升、瓶颈藏在哪一层、扩容该横向还是纵向、改动凭什么敢发布、出了问题谁能第一时间知道。剖析、压缩缓存与部署、测试与监控,三站把服务从"能跑"带到"敢托付"。
一条主线:曲线爬升的两天
一条真实的曲线开启了本章:某服务上线首日接口耗时 P99 在 80 毫秒上下,第三天爬到 600 毫秒,期间没有发版、流量只涨了三成。这根曲线背后往往不是单一原因——可能是某个中间件里的同步调用在并发下放大、可能是无上限的全局缓存吃内存引发 GC 风暴、也可能是连接池耗尽导致排队。本章三站就是排查与治理这条曲线的完整工具箱:8.1 教你把请求耗时拆到中间件的每一层,找到真凶而不是瞎猜;8.2 给出流量涨上来之后的系统性方案——压缩省带宽、缓存省计算、集群扩并发;8.3 建立质量与可观测的底盘——测试让你敢改代码,监控让你先于用户知道出事。
沿途站点
- 8.1 中间件性能剖析与优化——耗时的拆层方法(计时头、事件钩子、火焰图)、同步调用与每请求重活的清理、连接池与序列化的优化手法。
- 8.2 压缩、缓存与部署扩展——响应压缩的取舍、多级缓存(进程内、Redis、HTTP 缓存)的分层与失效、PM2 集群与容器化部署的配置要点。
- 8.3 测试、调试与监控体系——中间件单测与 supertest 集成测试、Inspector 与诊断报告的调试手法、指标采集与告警的最小可用方案。
拐点与结论
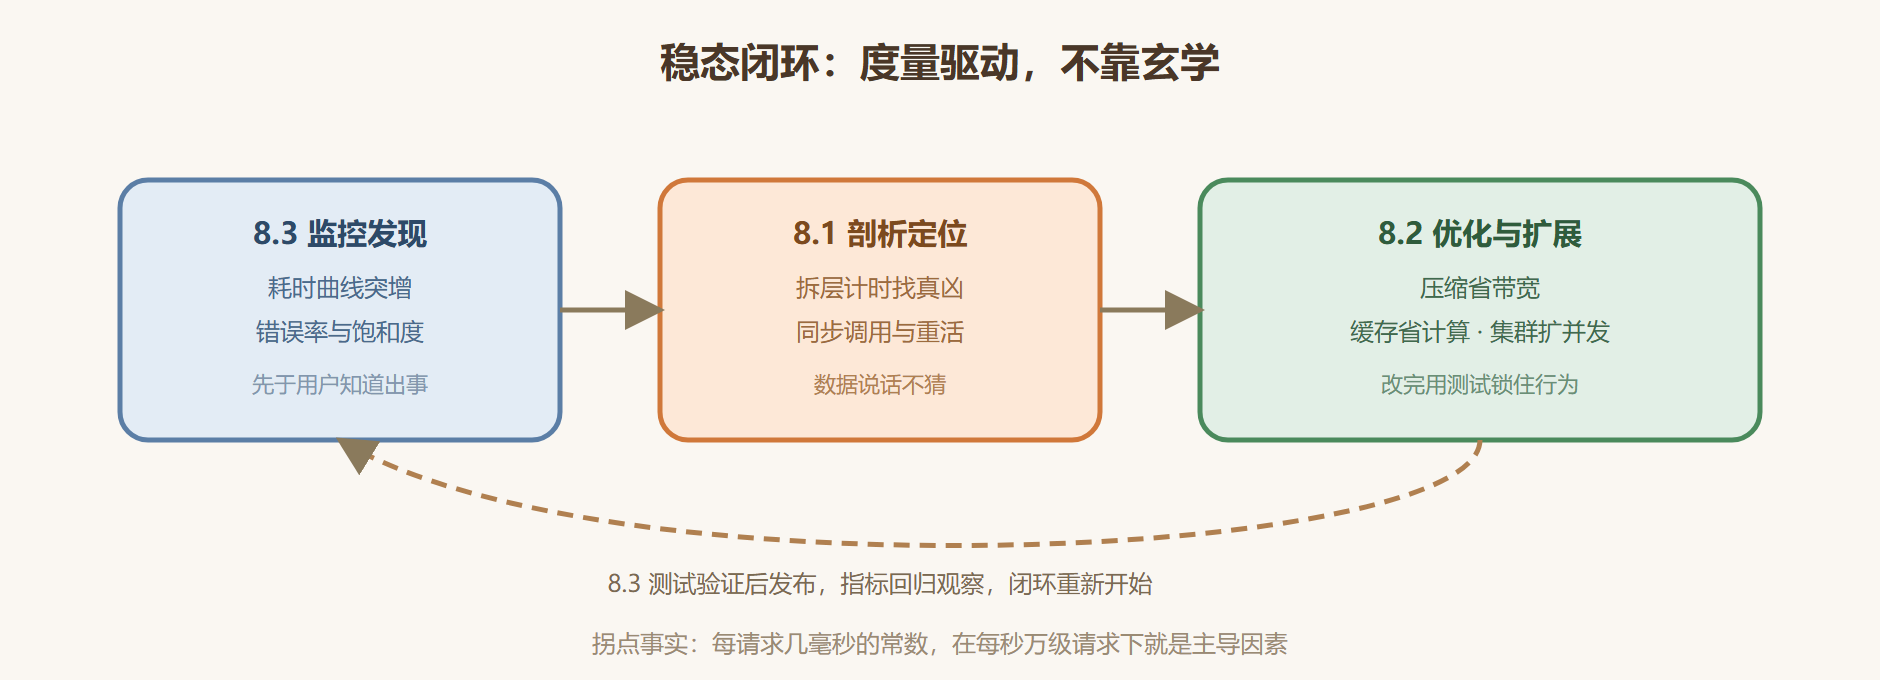
本章拐点在 8.1 的一个量化事实:把"每请求 5 毫秒"的中间件放大到每秒一万请求,单是这一层就吃掉几十秒的 CPU 时间——性能问题在微观上是常数,在宏观上是主导因素。多数人凭直觉优化"看起来慢"的代码,剖析数据却总指向意料之外的位置。结论是:稳态运行靠的是度量驱动的闭环——剖析找到真凶、测试保住改动、监控盯着趋势,三者任何一个缺席,性能与稳定性都会退化成玄学。
稳态运行的闭环结构如下图。
图 8-0:稳态运行的度量闭环
稳态三问
进入本章前,先自问三个问题,答案的空白处就是本章要补的课。**一问:你的服务现在多快?**如果只有"感觉挺快"而没有分位数数字,说明剖析与指标这一环缺失,8.1 与 8.3 直接对口。**二问:流量翻倍会发生什么?**答不上来说明容量边界没有探过,8.2 的压测与扩展方案是解法。**三问:今晚发布的改动,凭什么确定没改坏别的?**没有测试底盘的团队只能靠人工点检,8.3 的测试金字塔把这个问题变成机器回答。三问答完,本章的学习目标就不再是知识点,而是三个可以随身携带的工程能力。
读完你应该
- 能把一次请求的耗时拆解到中间件层与函数级,用剖析数据指出真凶;
- 能识别并清除三类典型性能反模式:每请求同步 IO、每请求重计算、无上限全局集合;
- 能为一个服务配齐压缩、多级缓存与集群部署,说清各自的取舍与失效策略;
- 能为中间件写单测、为接口写 supertest 集成测试,覆盖正常、截停、异常三路径;
- 能搭建最小可用监控:黄金指标采集、错误率告警、耗时曲线看板。
下一章的接力
服务稳了,视野该抬高了:TypeScript 工程化让洋葱的类型也受控,微服务与 Serverless 把洋葱装进更大的架构,API 网关与中后台两个案例把全册知识拧成一股绳——下一章是剥层之后的全景。