1.1 从 MemGPT 到 Letta:记忆研究的源流
1.1 从 MemGPT 到 Letta:记忆研究的源流
本节摘要:Letta 的前身是 2023 年发表于伯克利的学术项目 MemGPT。本节沿着"上下文窗口之痛 → 虚拟上下文管理论文 → 项目服务化更名"的线索,梳理这套记忆技术的源流,帮你理解 Letta 的每个设计决策分别来自哪个阶段的经验教训。读完本节,你能说清 MemGPT 论文的核心赌注、2024 年更名背后的三重动机,以及这套演化路径对今天使用框架的影响。
「金鱼记忆」与第一代补救方案
"金鱼记忆"是大模型应用圈子里流传已久的自嘲:模型在单轮问答里才思泉涌,隔上几轮对话就忘得一干二净。它描述的正是无状态推理的本质——大语言模型本身是一台概率预测机器,输出只取决于当次输入,上一轮说过什么,模型一概不知。要维持多轮对话,应用层只能把历史消息不断堆回请求里,假装模型"记得"。
第一代补救方案很快暴露出两类瓶颈。一类是硬截断:对话一旦超过上下文窗口上限,最早的消息就被丢掉,用户在长对话里反复经历"昨天的约定今天不认账"。另一类是检索增强生成(RAG):把历史与文档切块存进向量库,按相似度捞回几段拼进提示词。RAG 缓解了溢出,却引入了新的尴尬——它是静态且被动的,检索发生在模型推理之前,由外部代码决定"给模型看什么"。模型自己既不能说"这段话对我很重要,我要长期记住",也不能说"我之前记错了,现在更正一下"。记忆的主导权始终在开发者手里,模型只是被动接收者。
要评判 Letta 的贡献,得先看清这两条老路的天花板:截断丢信息,检索不授记忆权于模型。源流故事的一切,都从这里开始。
虚拟上下文管理:论文的核心赌注
2023 年秋天,加州大学伯克利分校的研究者发表 MemGPT 论文,副标题直译过来是"迈向作为操作系统的语言模型"。论文的核心赌注只有一个:操作系统的虚拟内存思想可以原样搬进大模型应用。物理内存再大也有限,操作系统靠"进程以为自己独占连续内存"的抽象,把数据在内存与磁盘之间来回换页;上下文窗口再长也有限,那就在窗口之外挂一个外部存储,靠一套函数调用协议让模型自己决定换什么。
在论文的架构里,上下文窗口被称作主上下文(main context),窗口外的存储被称作外部上下文(external context)。主上下文里驻留系统提示词、核心记忆(关于智能体自身与用户的关键事实)和最近的消息队列;外部上下文则分成召回存储(可检索的完整对话历史)与存档存储(向量化的长期知识库)。关键创新在于调度权:当模型判断"这条信息值得记住"或"这个记忆该更新了",它主动发起函数调用去改写存储,而不是等外部代码替它决定。论文把这比作缺页中断——模型的"内心独白"发现主存里没有所需信息,就触发一次对外部存储的寻址。
用伪代码描画这个循环,大概是这个样子:
# MemGPT 推理循环的骨架(示意,非可运行代码) while True: prompt = build_context(system_prompt, core_memory, recent_messages) output = llm.generate(prompt) # 模型输出含内心独白与工具请求 for call in parse_tool_calls(output): if call.name == "core_memory_replace": # 修改驻留记忆 core_memory = apply_edit(core_memory, call.args) elif call.name == "archival_memory_insert": # 写入长期档案 archival.store(call.args["content"]) elif call.name == "archival_memory_search": # 主动检索档案 results = archival.search(call.args["query"]) recent_messages.extend(results) # 检索结果回到下一轮上下文 persist_state(core_memory, archival, recent_messages) # 状态落库
注意循环末端那行 persist_state:每轮推理结束后状态写入数据库,下一次会话从数据库恢复。正是这一步,让"记忆"第一次成为可持久化、可编程的对象,而不只是聊天记录的另一种叫法。
从论文原型到 Letta:更名背后的三件事
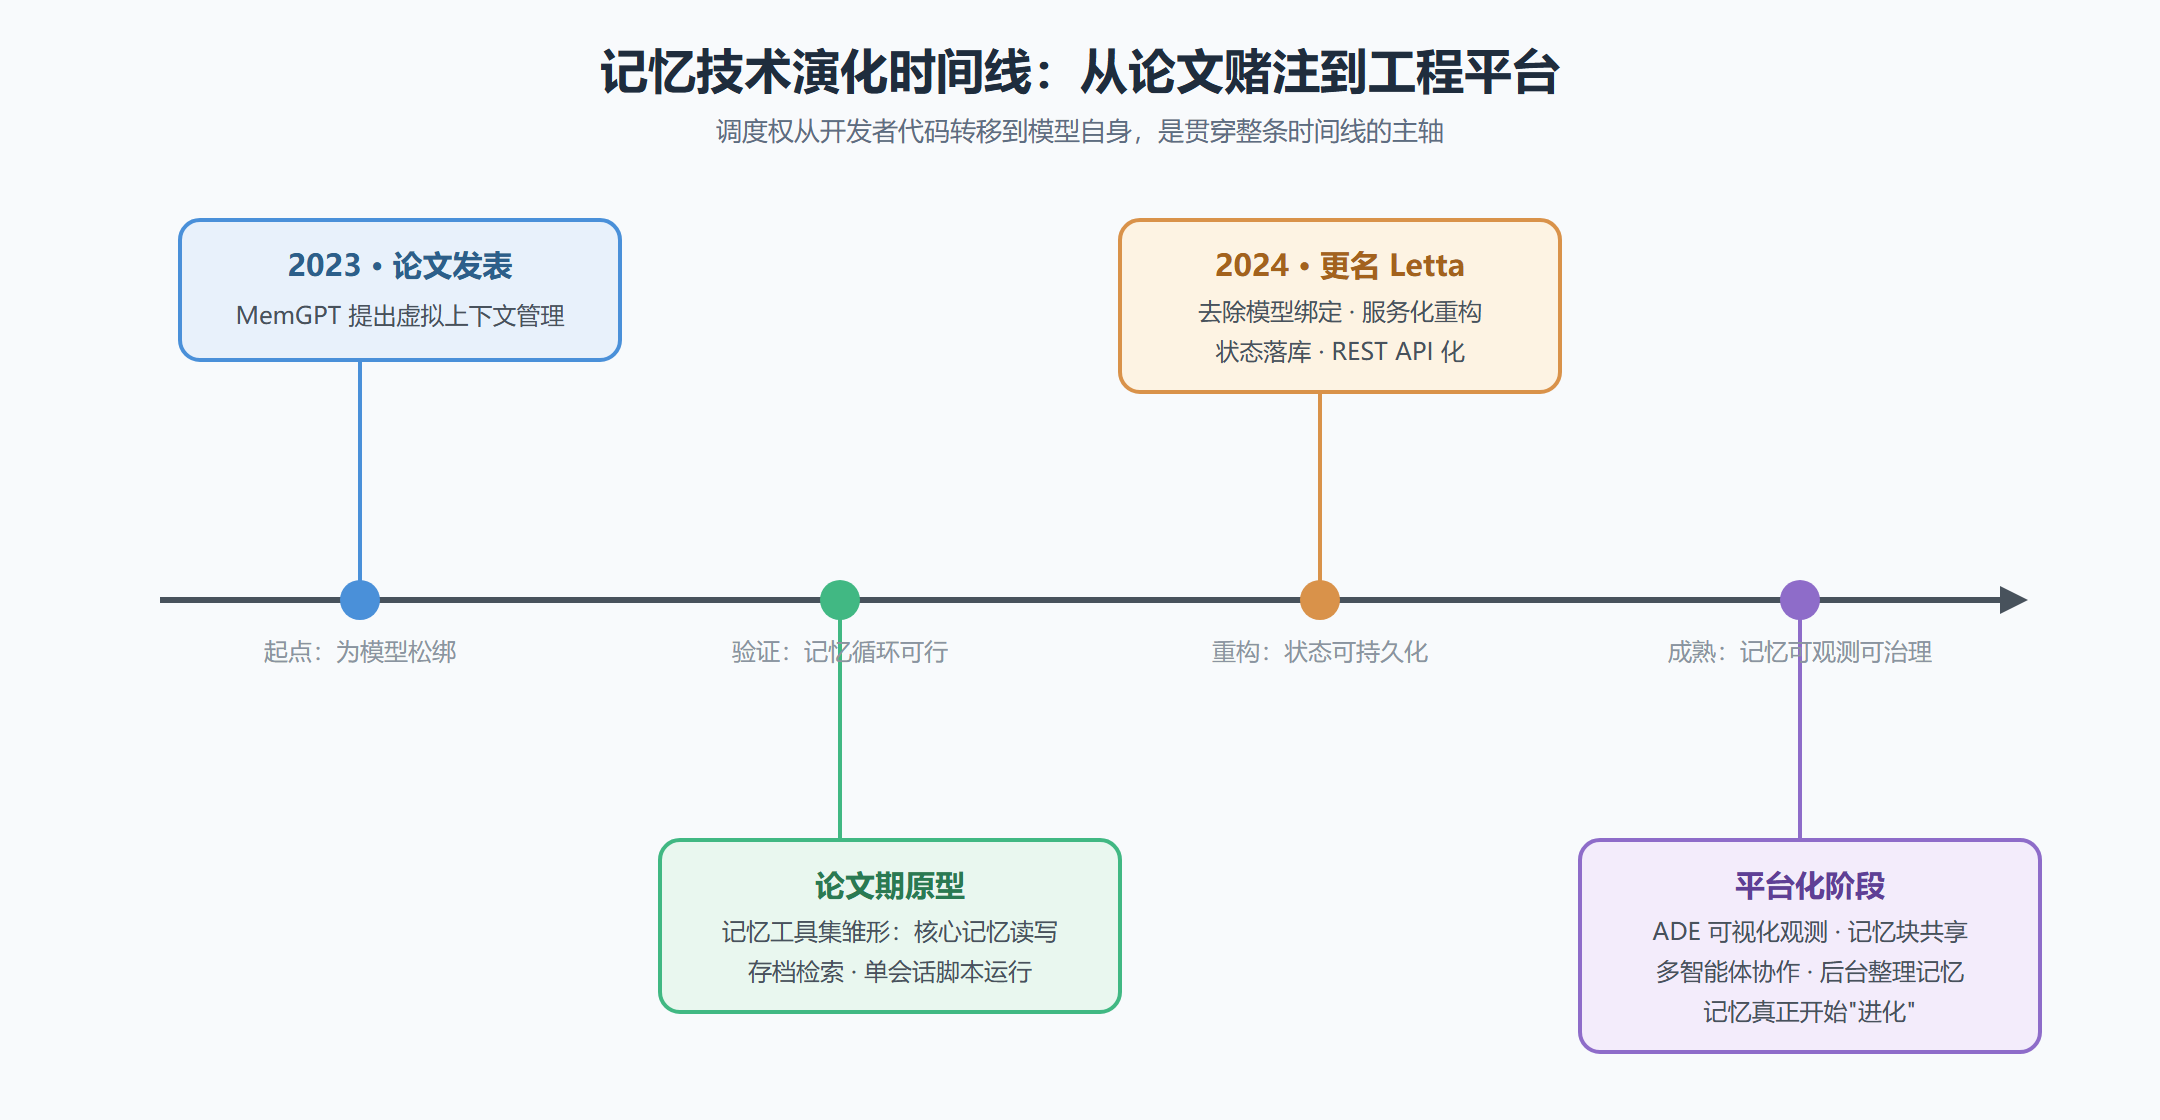
2024 年,MemGPT 项目宣布更名为 Letta。这次更名常被误读成单纯的商业动作,实际背后是三件结构性变化,每一件都值得单独看清。
第一件事:去掉模型绑定的暗示。 原名里的"GPT"字样让人误以为这套记忆架构绑定 OpenAI 模型,而论文方案的精髓恰恰是模型无关——只要模型具备基本的函数调用能力,记忆管理逻辑就能运转。更名后的 Letta 明确把"可插拔的推理引擎"写进产品定位:同一份智能体状态,底层可以是云端旗舰模型,也可以是本地部署的开源权重。记忆的可移植性由此成为卖点:换模型不换记忆。
第二件事:从脚本到服务。 论文阶段的 MemGPT 是一个研究代码库,跑在单次会话里,重启即失忆。Letta 把它重构为一个常驻的智能体服务器:状态存进数据库(从轻量的 SQLite 到生产级的 PostgreSQL),所有交互经由 REST API 完成,智能体成为可以被创建、查询、更新的网络资源。这个"服务化"跃迁,是从论文到工程的关键分水岭,第 2 章与第 3 章会反复回到这里。
第三件事:给记忆装上观察窗。 记忆系统调试的最大痛点是黑盒——你不知道模型为什么写了那条记忆。Letta 配套推出了 ADE(Agent Development Environment,智能体开发环境),把内心独白、记忆块内容、工具调用轨迹全部可视化,并允许开发者在界面上直接改写记忆块。这套白盒化的观测能力,在第 4 章会成为你的主要实验仪器。
图 1-1 从 MemGPT 论文到 Letta 平台的技术演化时间线
演化各阶段的形态对比
把三个阶段摆在一起看,能更清楚地看到"记忆"这个概念如何一步步变得工程化:
| 阶段 | 形态 | 记忆能力 | 主要局限 |
|---|---|---|---|
| 无状态时代 | 一次性 API 调用 | 无,历史靠应用层重放 | 窗口溢出、长对话失忆 |
| RAG 补救 | 检索拼装提示词 | 被动检索,模型无写入权 | 静态、无法自我修正 |
| MemGPT 论文 | 单会话研究脚本 | 模型自主读写分层记忆 | 重启即失忆,难部署 |
| Letta 平台 | 常驻智能体服务器 | 持久化、可视化、可共享的记忆块 | 需要运维数据库与服务 |
这张表也解释了为什么本册教程坚持"实验"视角:Letta 的每个部件都带着演化痕迹。你在第 2 章看到的分层存储对应论文期的主存与磁盘抽象,第 3 章的数据库迁移对应平台化的服务重构,第 5 章的共享记忆块则是平台化之后才长出的新能力。知道每个部件从哪个阶段来,就能预判它解决哪类问题、又在哪个场景下力不从心。
对使用者的三点影响
源流不是怀旧素材,它直接影响你今天怎么用这套框架。第一,如果你从 RAG 走过来,要完成一次心态转换:Letta 不是检索管道的替代品,而是把检索的决策权交给模型——存档存储底层同样用向量检索,但"查什么、什么时候查、查到后记不记"由模型在推理中自行决定。第二,如果你看重长期投入,更名后的架构意味着记忆状态独立于模型生命周期,今天用某家旗舰模型积累的智能体记忆,明天切换模型时原样保留。第三,如果你关心调试与审计,论文期的黑盒循环在 Letta 里已是白盒:每一步记忆读写都有迹可循,这是第 4 章 ADE 实验的根基。
本节要点回顾
- 源头:Letta 前身是伯克利 2023 年发表的 MemGPT 论文,核心赌注是把操作系统虚拟内存思想搬进大模型上下文管理。
- 机制:上下文窗口当主存、外部存储当磁盘,模型通过函数调用自主完成记忆换页,调度权从开发者代码转移到模型自身。
- 更名的三件事:去除模型绑定暗示、从脚本重构为常驻服务、配套 ADE 观测环境,分别对应定位、架构与调试三个层面。
- 演化脉络:无状态 → RAG 被动检索 → 论文原型自主读写 → 平台化持久记忆,每个阶段的局限都是下一阶段的出发点。
- 对实践的指向:记忆状态与模型解耦意味着可移植,白盒化意味着可调试——这两条会在后续章节反复兑现。
下一节我们把这个演化故事翻转为价值命题:持久化状态到底给智能体带来了什么不可替代的能力。