1.2 核心价值:给无状态模型装上持久状态
1.2 核心价值:给无状态模型装上持久状态
本节摘要:持久化智能体(Stateful Agents)的核心主张是把"状态"从应用层的临时变量提升为系统的一等公民。本节通过无状态与有状态两段请求的对比,讲清这一转变到底改变了什么:上下文不再是每次重放的历史包袱,而是可读写、可持久化、可编程的记忆空间。读完本节,你能准确说出"持久化"在 Letta 语境下的具体含义,以及它为什么是记忆进化的前提。
先对比两段请求
理解状态的价值,最直接的方式是把两种写法摆在桌面上比较。先看无状态应用的典型写法——手动维护历史,每次全量重放:
# 无状态写法:历史堆叠,越聊越重 history = [] def chat(user_input: str) -> str: history.append({"role": "user", "content": user_input}) resp = base_llm.chat(messages=[system_prompt] + history) # 每次都带上全部历史 history.append({"role": "assistant", "content": resp}) return resp
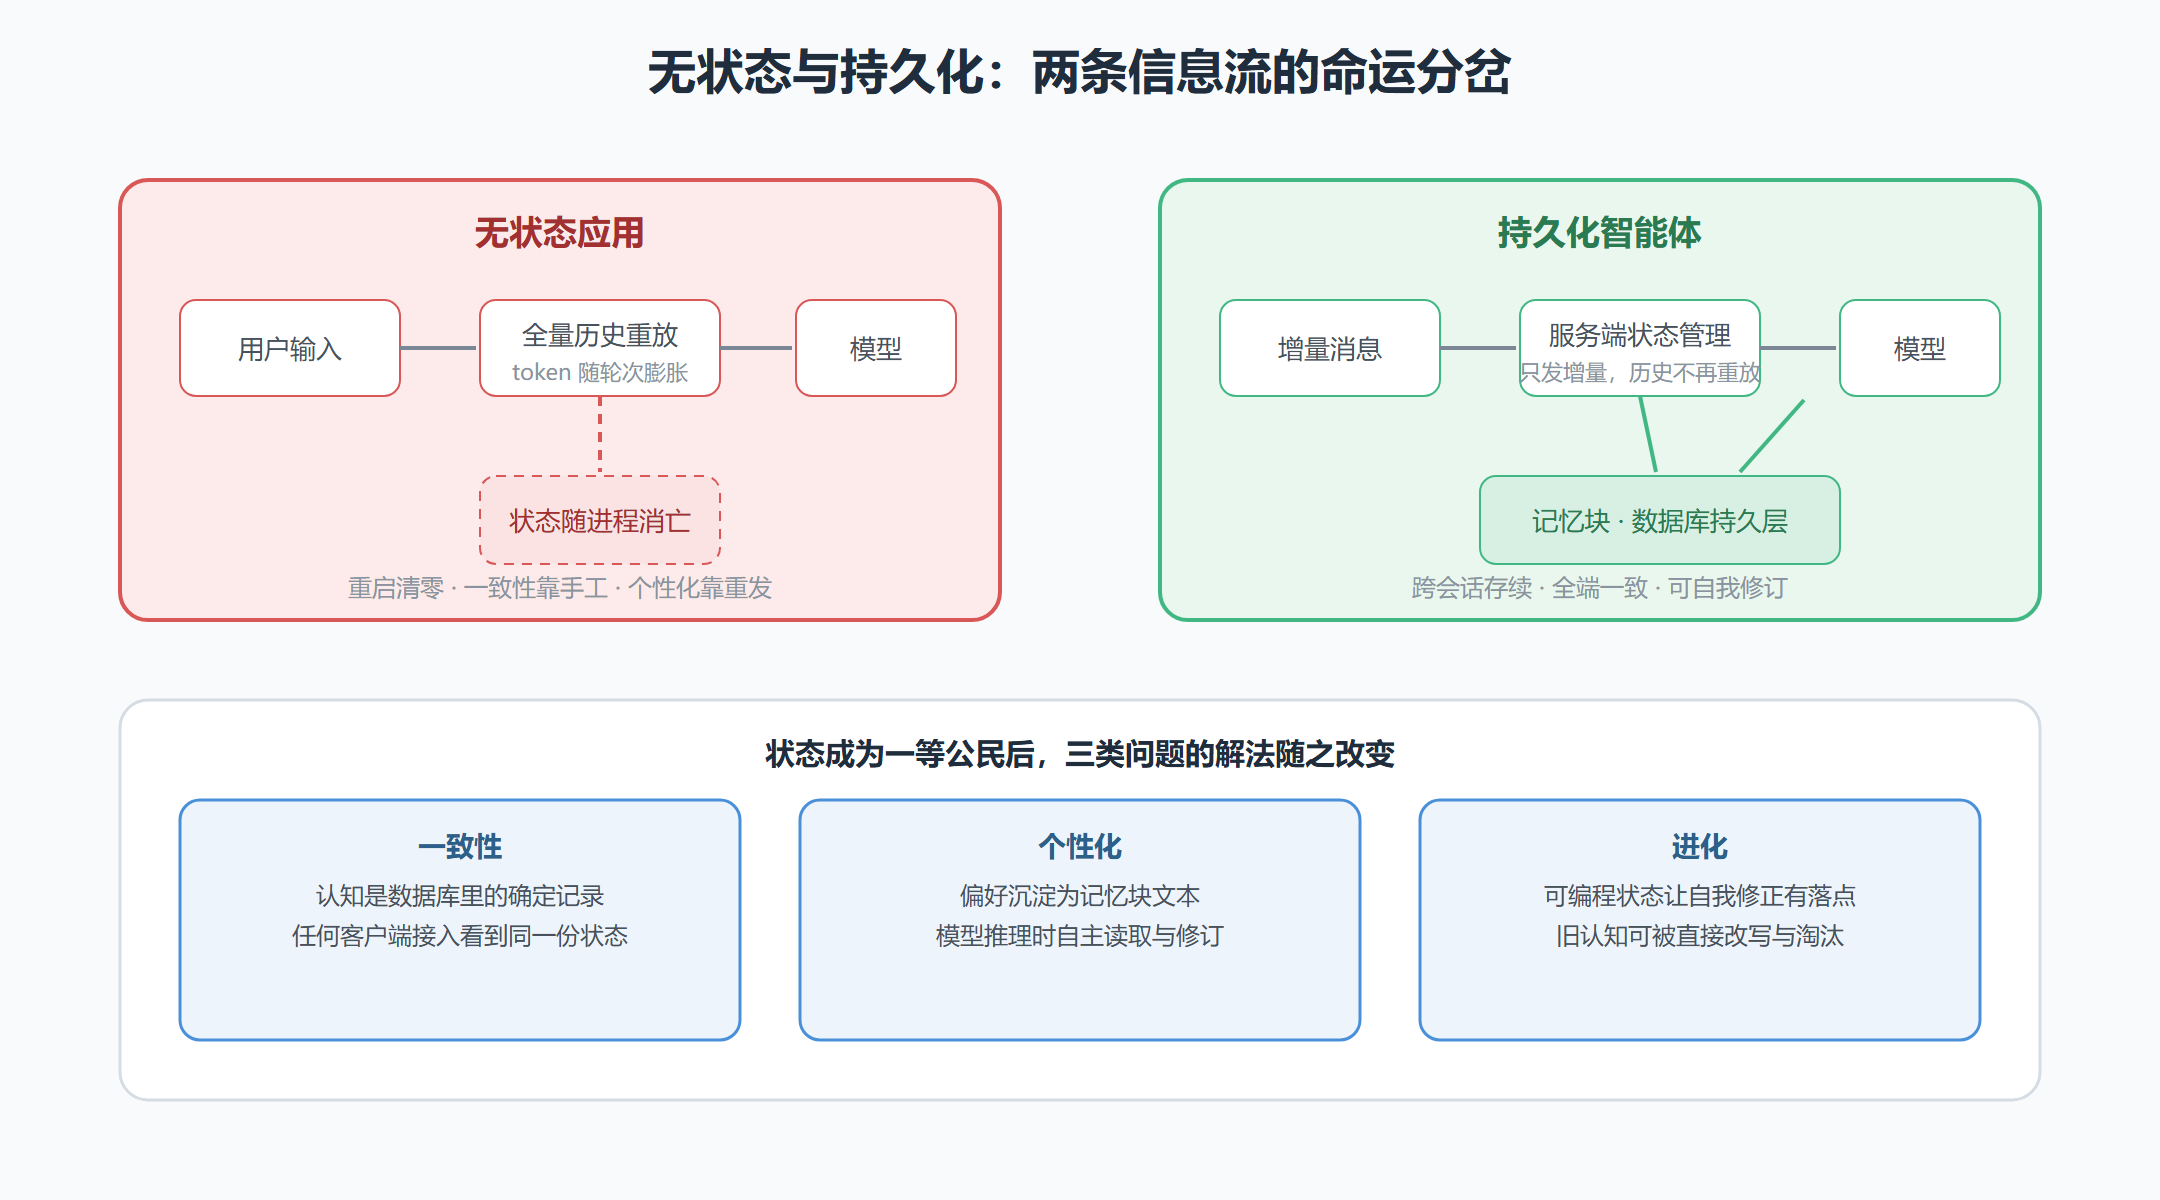
这段代码有两个注定崩塌的地方:其一,history 只活在进程内存里,服务一重启,用户三天聊出来的上下文清零;其二,历史越长,每次请求携带的 token 越多,成本线性上涨,而模型对超长上下文的注意力反而被稀释——研究者把这称作"迷失在中间"(Lost in the Middle):塞得越满,中段信息越容易被模型忽略。
再看 Letta 语境下的有状态写法:
from letta_client import Letta client = Letta(base_url="http://localhost:8283") # 创建智能体:初始记忆由记忆块定义,状态由服务端持有 agent = client.agents.create( name="assistant_with_memory", memory_blocks=[ {"label": "persona", "value": "你是严谨的项目助理,回答先给结论。"}, {"label": "human", "value": "用户是后端工程师,正在筹备内测发布。"}, ], model="openai/gpt-4o-mini", embedding="openai/text-embedding-3-small", ) # 对话只发增量消息,历史与记忆由服务端管理 resp = client.agents.messages.create( agent_id=agent.id, messages=[{"role": "user", "content": "发布计划有什么要调整的?"}], )
差别一目了然:对话请求里没有历史数组,没有拼接逻辑。状态被服务端持有与管理——它躺在数据库里,随每轮对话自动更新,跨会话、跨重启地存在。开发者从"历史搬运工"的位置上退了下来。
状态为什么值得一等公民待遇
把状态交给服务端持有,不只是少写几行代码的问题,它改变了三类事情的解法。
第一类:一致性问题。 无状态写法里,"模型知道什么"取决于你的历史数组塞了什么,塞多塞少全凭手感,两个服务实例的历史甚至可能不一致。持久化状态下,智能体的认知是数据库里的一条确定记录,任何客户端在任何时刻接入,看到的都是同一份状态。第 5 章讲多会话管理时会展开:这份确定性是跨任务协作的信任基础。
第二类:个性化问题。 个性化的本质是"交互历史改变了未来行为"。无状态架构里这只能靠把偏好写进每次的提示词,写多了窗口爆炸;持久化架构里,偏好沉淀为记忆块中的一行文本,模型在推理时自主读取、自主修订。用户三个月前说"我胃不好别推冰美式",三个月后智能体依然记得——不是因为每次都重发了这段话,而是因为它被写进了人类的记忆块。
第三类:进化问题。 这是最容易被忽视、却是记忆进化的根基:只有状态被持久化为可编程对象,"自我修正"才可能发生。模型发现旧认知与新事实冲突时,可以直接改写自己的记忆块;如果状态只是日志流,模型连"修改"这个动作都没有落点。
图 1-2 无状态应用与持久化智能体的信息流对照
持久化不是日志,而是可编程状态
有个误解值得单独澄清:持久化不等于"把聊天日志存进数据库"。日志是只追加的流水,写完只能读;而 Letta 持久化的状态是结构化、可寻址、可编辑的对象——记忆块有标签、有内容、有容量上限,模型和开发者都能对它执行读写。
开发者侧的读写通过 SDK 直接完成。比如查看并修改智能体对用户的认知:
# 读取全部记忆块 blocks = client.agents.blocks.list(agent_id=agent.id) for b in blocks: print(b.label, "=>", b.value) # 找到 human 块,直接改写其中一条认知 human_block = next(b for b in blocks if b.label == "human") client.agents.blocks.update( block_id=human_block.id, value="用户是后端工程师,内测已发布,当前进入故障复盘期。", )
这段代码揭示了一个在无状态架构里不存在的操作:在两次对话之间,开发者可以像改配置一样修改智能体的"认知"。模型侧的对应能力由记忆工具提供(core_memory_append、core_memory_replace 等),细节留给第 2 章展开——这里只需记住价值判断:记忆是可编程对象,这是进化得以发生的前提条件。
一个最小实验:感受状态的重生
在动手章节到来之前,可以先用一个思想实验体会持久化的分量。设想两段会话:第一段里用户告诉智能体"我搬到了上海工作";第二段发生在两周后,用户问"帮我推荐个出差去处"。在无状态架构下,第二段会话对用户的居住地一无所知,除非应用层又把历史重放了一遍。在 Letta 里,第一段会话中模型识别到居住地变更,调用记忆工具把 human 块更新为"居住地:上海";两周后的第二段会话恢复状态时,这份认知原样在场——推荐时自动避开用户所在的城市,或优先推荐从上海出发方便的目的地。
注意整个过程没有任何一处"应用层记得替模型传话"。认知的写入由模型在推理中自主完成,认知的读取由服务端在组装上下文时自动完成。应用的职责收缩为:创建智能体、发消息、读结果。这种职责收缩,正是框架价值的直接体现。
再把这笔账往成本的角度算一遍。无状态架构里,为了"记住",应用层要么全量重放历史(token 成本随对话时长线性攀升,一个聊了半年的老用户,单次请求成本可能是新用户的几十倍),要么自己做摘要压缩(摘要的质量与时机全是你的代码的责任)。持久化架构里,成本结构被分层了:常驻的核心记忆有硬上限,成本恒定可控;历史沉入数据库,只在被检索时才产生检索与少量上下文成本。成本从"随时间无界增长"变成"有界的常数加按需的增量"——对于要长期运营的产品,这条成本曲线的形状比它的绝对值更重要。
两个高频疑问:先答为快
关于持久化状态,初学者的疑问高度集中,这里先回答两个最典型的。
疑问一:状态放服务端,会不会比放自己手里更难控制? 直觉上"自己的代码管自己的数据"才踏实,但智能体场景恰恰相反——你自己管历史,管的是一坨不断膨胀的消息数组,控制手段只有"塞多少、怎么截";框架管状态,管的是结构化的记忆对象,控制手段是精确的读写接口、可视化的检查与修订。控制力不是"数据物理上在哪"决定的,而是"你对它有多少可用的操作"决定的。
疑问二:既然状态在数据库里,我能不能直接改数据库? 技术上可行,工程上禁止。数据库里的状态有框架层的约束与缓存语义(块的容量校验、上下文重组的触发时机),绕过框架直改,轻则改了不生效,重则状态与缓存不一致。正确姿势永远是走 SDK 或 ADE 的读写接口——它们就是为此而存在的。
本节要点回顾
- 无状态之痛:历史重放导致成本随轮次上涨、长上下文注意力稀释、重启即失忆,三类问题同源。
- 一等公民的含义:状态由服务端持有并存入数据库,结构化、可寻址、可编辑,而不是应用层的临时变量。
- 持久化不是日志:记忆块是可编程对象,开发者与模型都能读写,日志只是状态的一个子集。
- 三类问题的解法升级:一致性靠唯一状态源,个性化靠记忆沉淀,进化靠可修正的认知对象。
- 职责收缩:应用层退回到"创建、发消息、读结果",记忆管理交给模型与框架协同完成。
下一节把镜头拉近,逐项检验支撑这套价值主张的三大关键特性,看看每一项的收益与代价分别是什么。