2.1 状态化智能体的理论基础
2.1 状态化智能体的理论基础
本节摘要:状态化智能体的理论核心是一个由"上下文组装、模型推理、工具执行、状态持久化"四步构成的循环,以及"主上下文与外部存储"两级空间划分。本节建立这套抽象模型——它是理解本章其余各节的坐标系。读完本节,你能用一张图说清智能体一次推理中信息如何流动、状态何时改变、记忆为何不会无限膨胀。
别以为存了聊天记录就叫有状态
很多团队宣布自己"有状态"的依据是:聊天记录已经写进了数据库。可惜这只完成了状态化的一半——存进去只是记账,真正的考验是下一次推理时怎么用。全量重放?窗口撑不住,注意力被稀释。只带最近几条?久远的关键事实凭空消失。用相似度捞一把?检索代码永远猜不准模型此刻真正需要什么。
状态化的完整主张是两部分:状态要持久化(记账),更要有一套由模型参与调度的取用机制(花钱)。Letta 的全部理论架构,就是围绕"如何让持久化的状态在对的时刻进入上下文"展开的。本节先把这个机制的最小抽象立起来,后续三节再逐层填充细节。
一个四步循环:智能体的心跳
剥开所有工程外壳,Letta 智能体的每次响应都经历同样的四步循环。这个循环就像智能体的心跳,转一圈,状态就可能变一次:
- 上下文组装:服务端从数据库读出智能体状态,把系统提示词、核心记忆块、最近消息窗口按顺序拼装成本轮请求的完整输入。
- 模型推理:模型读到的不只是用户消息,还有它自己的记忆与身份设定。它生成内心独白,判断该直接回答,还是先调用工具。
- 工具执行:若模型发起了工具调用——读写记忆、检索档案、执行自定义函数——服务端校验参数并执行,把结果作为新的输入喂回模型。
- 状态持久化:本轮发生的全部变化(新消息、记忆修订、工具结果)写回数据库,成为下一轮循环的起点。
用一段示意代码把循环钉在纸上:
# Letta 推理循环的抽象骨架(示意代码,展示四步的衔接关系) def agent_step(agent_state, user_message): # 第一步:上下文组装 —— 记忆块在此进入提示词 context = assemble( system_prompt=agent_state.system, core_memory=agent_state.blocks, # persona 与 human 等记忆块 recent_messages=agent_state.in_context_window(), # 消息窗口 new_message=user_message, ) # 第二步:模型推理 —— 输出可能是文本,也可能含工具请求 while True: output = llm.generate(context) calls = extract_tool_calls(output) if not calls: break # 没有工具请求,直接收尾 # 第三步:工具执行 —— 记忆读写发生在这里 results = [execute(call, agent_state) for call in calls] context = context + results # 结果回填,模型继续推理 # 第四步:状态持久化 —— 变化落库,跨会话生效 persist(agent_state, new_messages=collect(), updated_blocks=diff()) return final_answer(output)
注意第三步与第四步的分工:工具执行改变的是内存中的状态副本,持久化才把它变成跨会话的事实。1.2 节强调"可编程状态是进化的前提",落实到运行时,就是这个循环赋予模型的重写机会。
两级空间:主上下文与外部存储
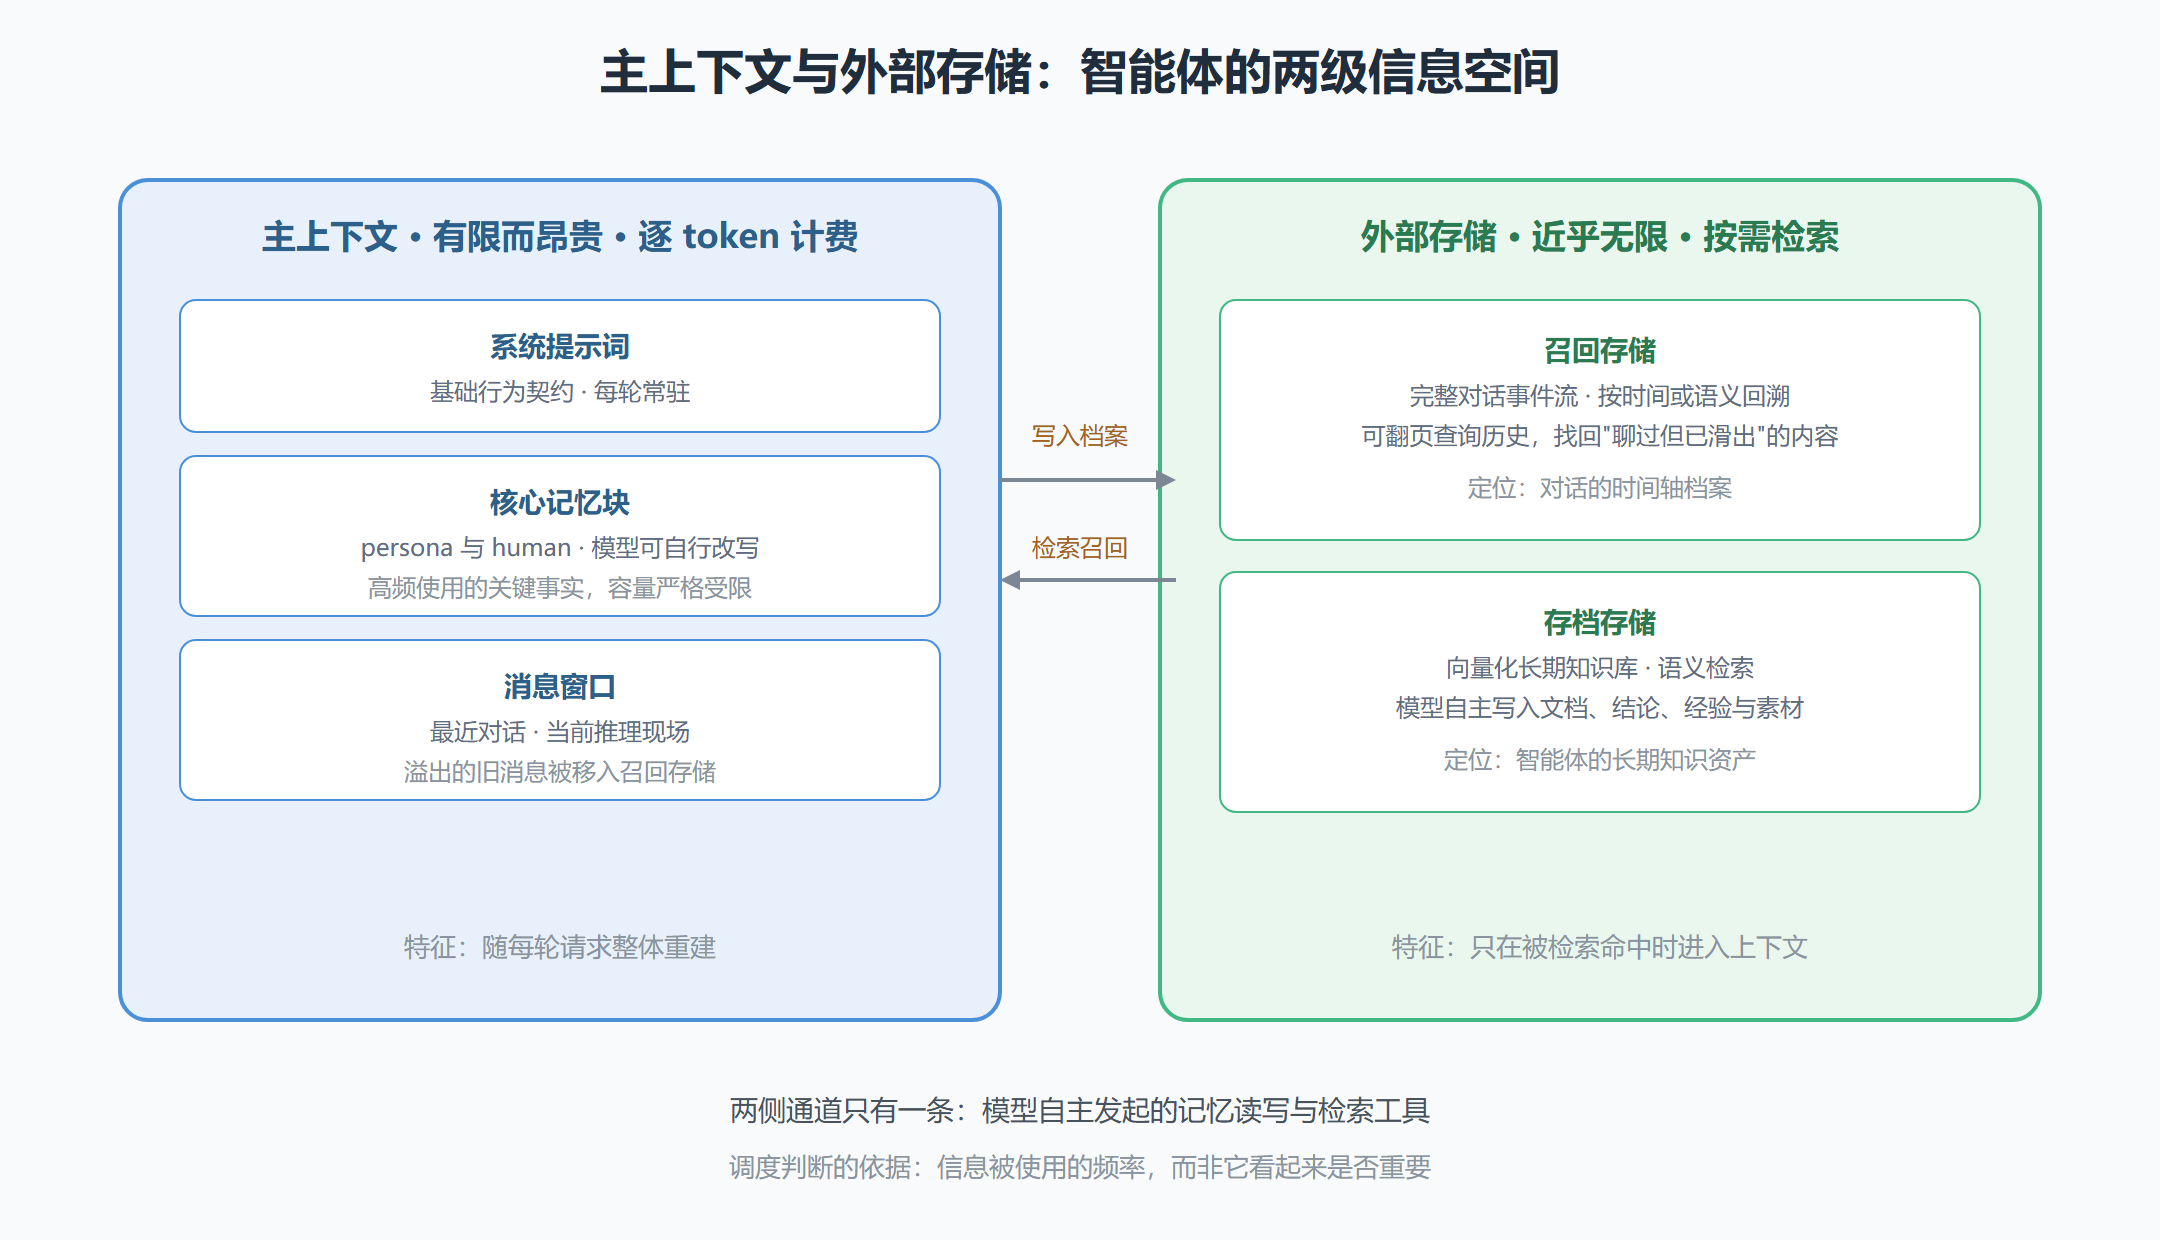
四步循环解决"何时调度",两级空间划分解决"放在哪"。Letta 把智能体的全部信息资产划入两个世界:主上下文(main context)是当前这轮请求里模型实际能读到的区域,空间有限、每个 token 都计费;外部存储(external context)是数据库里的区域,空间近乎无限、只在被检索命中时才消耗推理成本。
主上下文的构成是固定的三段:系统提示词定义智能体的基础行为;核心记忆块存放"必须时刻在场"的关键事实(关于自己的 persona、关于用户的 human);消息窗口存放最近若干轮对话,容纳当前的推理现场。外部存储同样分两库:召回存储保存完整的对话事件流,可按时间或语义回溯;存档存储以向量为索引,沉淀海量的长期知识。两边的通道只有一条——模型发起的检索与读写工具。这个设计直接继承自操作系统的主存与磁盘抽象,1.1 节论文源流中的赌注,落到工程上就是这条刚性边界。
两级空间的价值在于一个权衡公式:哪些信息"贵而常驻",哪些信息"廉而按需"。 判断标准不是信息的重要程度,而是被用到的频率——身份与核心偏好几乎每轮都要参与推理,值得常驻主上下文;一年前的会议纪要只在偶尔涉及时空档,放外部存储按需召回更划算。理解了这个权衡,你就理解了为什么 2.2 节的分层存储要那样设计淘汰逻辑。
图 2-1 主上下文与外部存储的信息流全景
循环里的状态快照
理论模型最后一课,是学会用"快照"的方式思考状态。把某个时刻智能体的全部状态拍下来,大致是这个样子(示意结构):
# 某智能体在某一时刻的状态快照(示意) { "persona": "你是项目复盘助理,先列事实再下判断。", "human": "用户是产品负责人,正在筹备季度复盘。", "in_context": ["消息 98", "消息 99", "消息 100"], # 消息窗口尾部 "recall_cursor": 100, # 召回存储已积攒的完整事件水位 "archival_docs": 1372, # 存档库中的知识条目数 }
这份快照解释了几个后续章节反复出现的现象:为什么改一行 human 块就能显著改变智能体行为(它整块常驻主上下文);为什么久远对话还能被找回(召回存储保留全部事件);为什么存档库可以无限增长而会话成本不涨(外部存储不占推理窗口)。第 4 章打开 ADE 时,界面上各面板显示的正是这份快照的实时视图——原理章的抽象模型,届时会变成你眼前的调试仪表。
循环的两种节奏:同步与流式
四步循环描述的是逻辑次序,工程实现上它有两种运行节奏,对应两类产品形态。同步节奏:客户端发一条消息,等服务端把循环完整跑完(可能包含多轮工具调用),一次性拿回最终回答与全部轨迹。实现简单、观测完整,适合批处理、评测与后台任务。流式节奏:客户端发起请求后即刻开始接收增量输出——模型的文字回答一段段推送过来,工具调用的发生也以事件形式实时通知。交互体验好,适合面向用户的产品界面。
同一套循环逻辑支撑两种节奏,是服务化架构的又一次红利:无论哪种节奏,状态的读写与持久化完全一致,你在实验环境验证过的行为,换到流式产品形态不会变形。选型的判断只看场景——人机对话用流式,机器对机器用同步,没有第三种答案。
关于理论模型的常见疑问
问:四步循环每轮都会走完四步吗? 不一定。循环的最短路径是"组装、推理、回答、落库"——模型直接回答,没有工具介入;最长路径可以有多轮"工具执行、结果回填、再次推理"的内部迭代。循环的步数由模型自主决定,你能在步骤轨迹里看到它每一步的选择。
问:状态快照会不会很大,每次组装都要全部加载吗? 不会。主上下文的三段构成物是有界的(系统提示词与核心记忆受容量约束,消息窗口固定条数),每次组装只加载这些有界对象加最新消息;外部存储从不整体加载,只有检索命中的片段才进入上下文。这正是分层设计的意义——上下文组装的成本恒定,不随记忆总量增长。
本节要点回顾
- 状态化的完整含义:持久化只是记账,取用机制才是关键——模型必须参与决定哪些状态进入上下文。
- 四步循环:上下文组装、模型推理、工具执行、状态持久化;工具执行改内存副本,持久化才成事实。
- 两级空间:主上下文有限而昂贵,承载系统提示词、核心记忆块与消息窗口;外部存储近乎无限,承载召回与存档两库。
- 常驻标准:信息按使用频率而非重要程度决定是否常驻,这是分层存储全部设计的出发点。
- 快照思维:把状态看作可拍摄的结构化对象,是后续调试与治理的基础视角。
下一节深入两级空间的内部,看三层记忆各自的结构、容量与淘汰逻辑——那台"记忆分页机"的机械细节。