2.2 分层存储:核心记忆、召回存储与存档存储
2.2 分层存储:核心记忆、召回存储与存档存储
本节摘要:分层存储是 Letta 记忆系统的机械结构:核心记忆常驻上下文、容量严格受限;召回存储是完整对话的时间轴档案;存档存储是向量化的长期知识库。本节拆解三层各自的结构、容量特征与信息流转规则,并讲清上下文压力下的"分页"如何避免窗口溢出。读完本节,你能为任意一条业务信息指出它该落在哪一层、以什么形态存在。
从物理内存层级借来的蓝图
计算机解决"快而小"与"慢而大"的矛盾,靠的是寄存器、内存、磁盘的层级结构:越靠近运算单元越小越快,越往外越大越廉价,层级之间靠缓存与换页机制衔接。Letta 把这张蓝图原样搬进了智能体:上下文窗口就是"内存"——快,但以 token 计价且容量有限;数据库就是"磁盘"——廉价近无限,但必须显式访问。三层记忆正是这个思路的产物,每一层对应一种信息的使用模式。
值得强调的是,分层不是简单的"大中小"分类,而是一套信息生命周期管理制度:新事实先进入哪层、什么时候晋升或降级、什么时候被淘汰,都有明确的路径。理解了生命周期,你就能解释一个智能体为什么会"记得三周前的小事、忘了昨天聊过的长文"——不是记性不好,是那类信息本就被制度安排在了会淘汰的层。
核心记忆:常驻的工作集
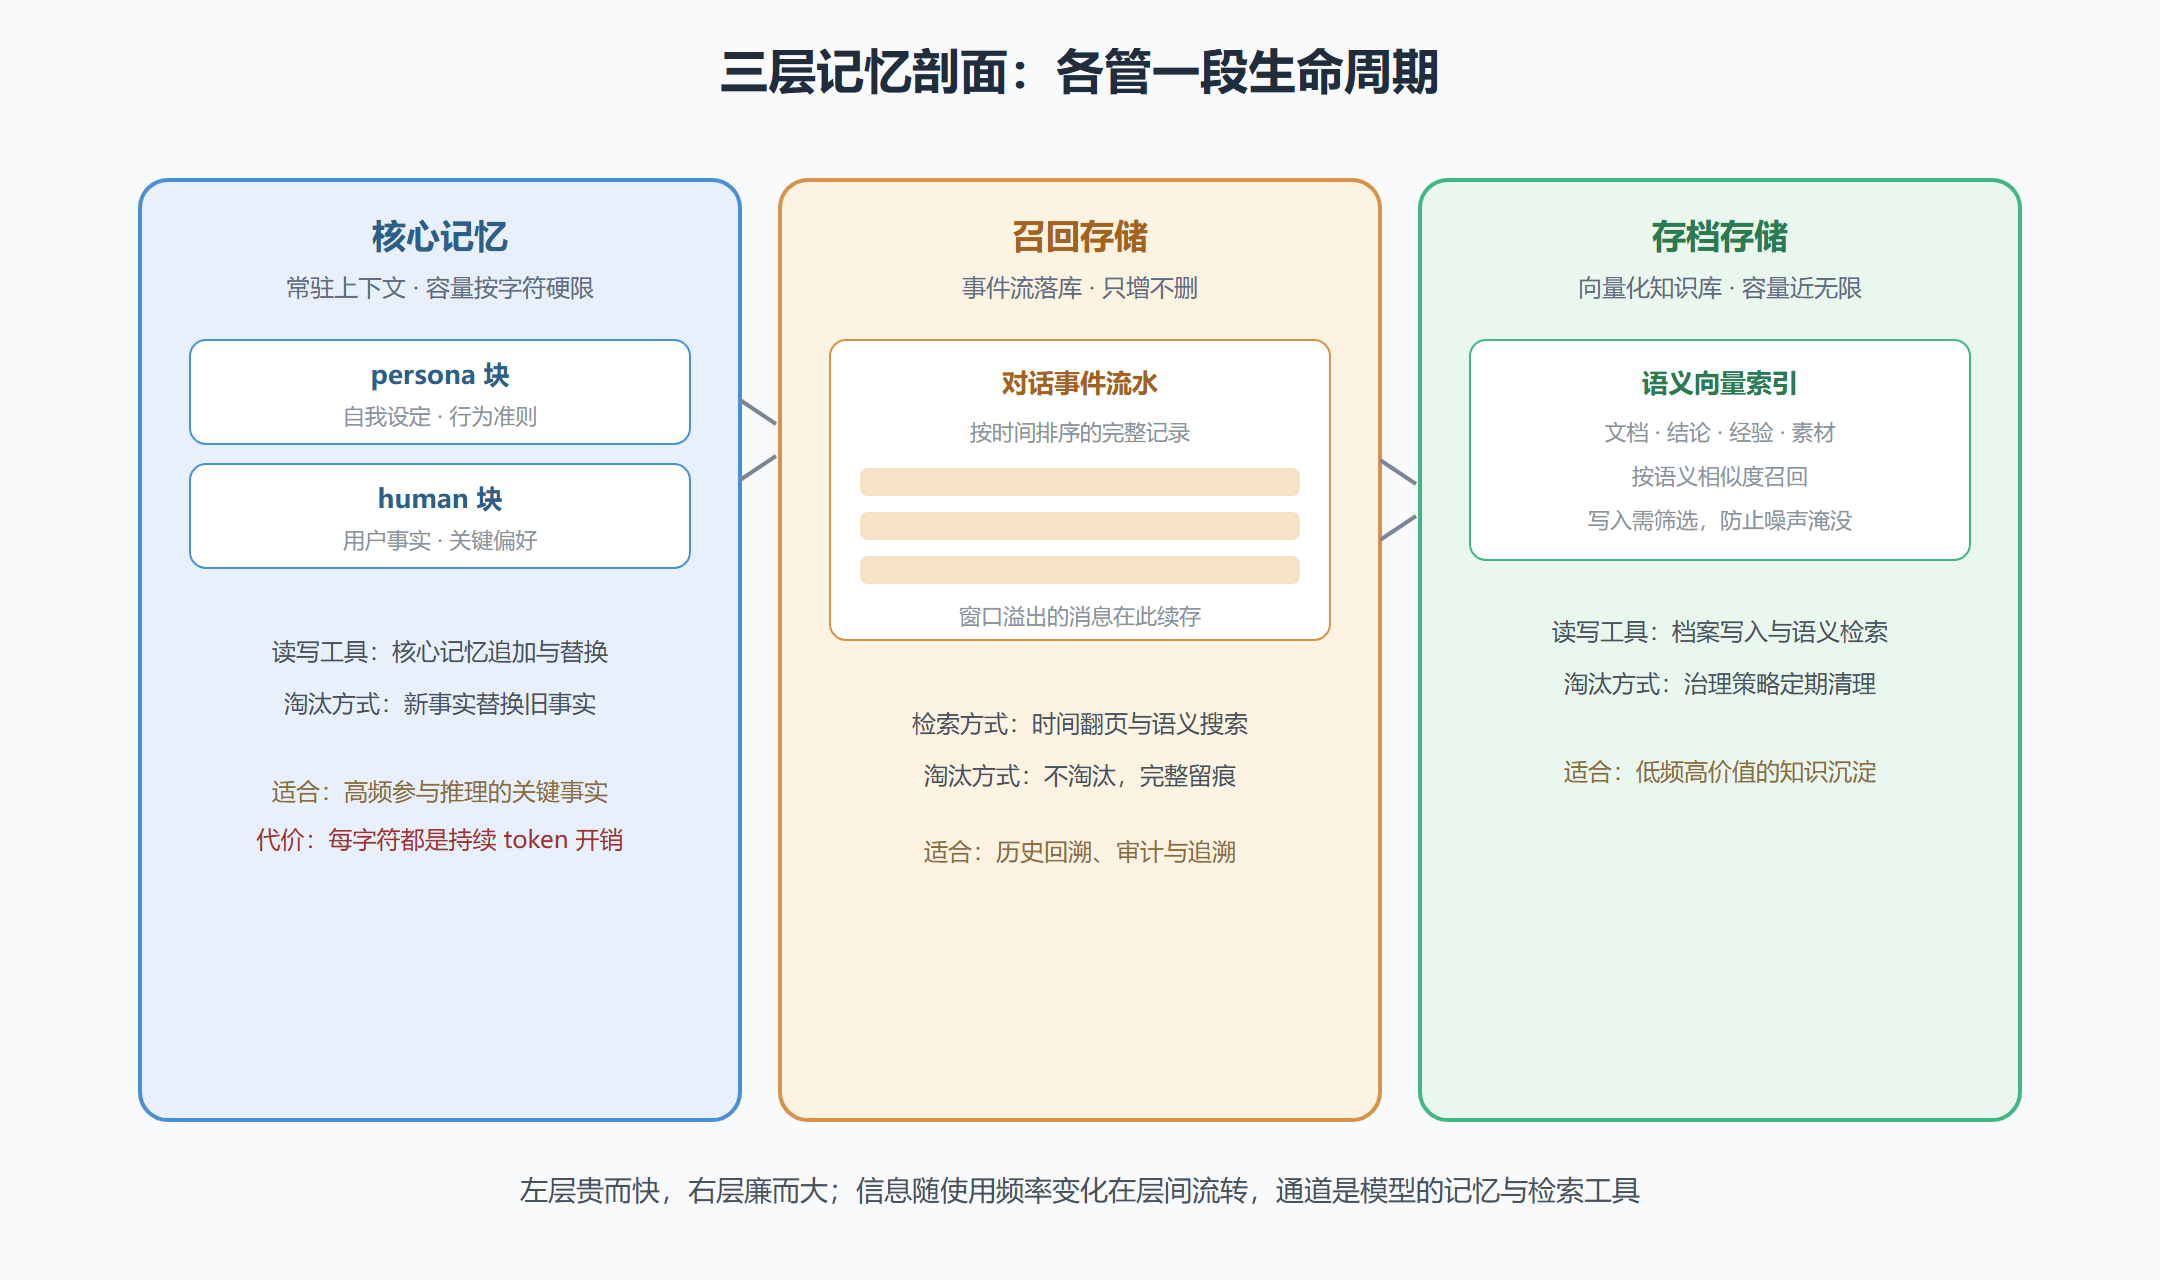
核心记忆(core memory)是唯一整块驻留在上下文窗口里的记忆,由一组记忆块构成。经典的两个块是 persona(智能体的自我设定:身份、语气、行为准则)与 human(对当前用户的认知:身份、偏好、关键事实)。块有三个属性:标签、内容、容量上限——上限以字符计,到顶了就写不进去,模型必须先做替换或压缩。
为什么容量要卡得这么死?因为这块记忆每轮推理都要整体进入提示词,放一行字就烧一行字的 token。硬上限逼着记忆保持"工作集"属性:只放高频使用的事实。一段健康的核心记忆,读起来应当像一张紧凑的备忘卡片,而不是流水账。
开发者的初始设定与运行时观察都围绕块展开:
from letta_client import Letta client = Letta(base_url="http://localhost:8283") agent = client.agents.create( name="tiered_demo", memory_blocks=[ # 两个经典块:内容务求精炼,它是每轮推理的固定开销 {"label": "persona", "value": "你是运维值班助理,汇报先说结论。", "limit": 5000}, {"label": "human", "value": "用户是 SRE 负责人,关注可用性与变更记录。", "limit": 5000}, ], model="openai/gpt-4o-mini", embedding="openai/text-embedding-3-small", ) # 随时可以查看块的当前内容与水位 for b in client.agents.blocks.list(agent_id=agent.id): print(b.label, len(b.value), "/", b.limit, "字符")
模型侧对核心记忆的修改走记忆工具(core_memory_append 与 core_memory_replace),机制在下一节展开。这里先记住容量规则:块是有限的席位,写入新事实的隐含前提是它配得上一个席位。
召回存储:对话的时间轴
召回存储(recall storage)是完整对话事件流的档案馆。每一轮用户输入、智能体回复、内心独白、工具调用结果,都以事件形式按时间顺序落库。它的检索方式有两种:按时间翻页——把窗口外的历史按顺序调回;按语义搜索——用一条查询在全部历史里找回相关片段(对应的内置工具是 conversation_search)。
召回存储解决的是"聊过但已滑出窗口"的尴尬。设想三周前用户随口提过某供应商的交付延迟,当时没写进核心记忆,如今谈论新订单时这份信息突然相关——时间轴一查即得。因为对话历史必须完整可回溯,这层的信息只增不删,也没必要删:它的存储成本远低于重新对话的成本。
存档存储:向量化的大脑外存
存档存储(archival storage)与前两层气质不同:它装的往往不是"对话里说过的话",而是智能体主动沉淀的知识资产——整份文档、一段分析结论、一次工具调用的结果摘要。写入走 archival_memory_insert,检索走 archival_memory_search,底层以向量表示支撑语义级查找:查询"上次关于付款条款的风险提示",能召回语义相近的那些段落,哪怕用词完全不同。
这层的容量近乎无限,但质量纪律比容量更关键。检索是按相似度排序的,档案里堆的若多是低质量条目,真正有价值的记忆就会被噪声淹没——工具返回若干条"查到了但没用"的结果,反而消耗模型的注意力。第 5 章的记忆治理会回头处理这个问题,此刻只需建立直觉:存档库是资产,不是垃圾桶。
图 2-2 分层存储的剖面:写入路径与淘汰路径
三层对照表:一张表选对归属
把三层的特性并排放好,遇到任何一条信息都能对号入座:
| 维度 | 核心记忆 | 召回存储 | 存档存储 |
|---|---|---|---|
| 驻留位置 | 上下文窗口内 | 数据库(事件表) | 数据库(向量库) |
| 容量特征 | 字符硬上限,极小 | 只增不删,随对话增长 | 近无限,按需扩容 |
| 成本特征 | 每轮推理持续计费 | 仅检索时计费 | 仅检索时计费 |
| 写入主体 | 模型与开发者 | 系统自动记录 | 模型自主写入为主 |
| 检索方式 | 无需检索,天然在场 | 时间翻页或语义搜索 | 向量语义检索 |
| 典型内容 | 身份设定、关键偏好 | 全部对话事件 | 文档、结论、经验 |
一个实用的归位口诀:每轮都要用的进核心,聊过就得找得回的进召回,值得沉淀但不必常驻的进存档。 三句话覆盖绝大多数情况。
上下文压力:窗口满了会发生什么
分层的最后一个环节是淘汰。当对话持续增长,消息窗口逼近模型上限时,Letta 触发一次"分页":把窗口中较旧的消息压缩成摘要,原文完整移入召回存储,摘要与核心记忆一起留在窗口里。这个过程对用户透明,但对理解智能体行为至关重要——被压缩的消息并没有消失,而是从"逐字在场"降级为"摘要在场、原文可查"。
这解释了一个经典的调试困惑:为什么智能体有时答不出"昨天详细说过什么",却能答出"上周提过的要点"。前者若已滑出窗口且未被召回,只剩摘要级的存在感;后者经过了压缩整理,要点反而醒目。遇到这类问题时,先查召回存储的事件流,再下"它忘了"的结论——多数时候不是遗忘,是降级。
本节要点回顾
- 分层蓝图:借自计算机存储层级——窗口快而贵,数据库廉而大,层间靠换页与检索衔接。
- 核心记忆:由带容量上限的记忆块组成,persona 与 human 是经典配置,只配容纳高频关键事实。
- 召回存储:完整对话事件的时间轴,只增不删,支持时间翻页与语义搜索,负责"聊过的都能找回"。
- 存档存储:向量化知识资产库,容量近无限,质量纪律重于容量,防止噪声淹没真记忆。
- 归位口诀:每轮要用的进核心,聊过要找得回的进召回,值得沉淀不必常驻的进存档。
- 分页机制:窗口逼近上限时旧消息压缩降级为摘要,原文移入召回存储——遗忘感多半是降级感。
下一节进入这套机器的动力舱:模型如何通过记忆工具安全地完成自我编辑,以及这条编辑链路上的每一道闸门。