2.5 存储层设计:SQLite 与 PostgreSQL 的持久化策略
2.5 存储层设计:SQLite 与 PostgreSQL 的持久化策略
本节摘要:分层记忆的物理载体是存储层。Letta 提供两条路线:零配置的 SQLite 单文件存储,与生产级的 PostgreSQL 配合向量扩展。本节从并发模型、向量检索、数据安全三个维度讲清两者的分界线,并给出判断自己该站在哪一边的决策方法。读完本节,你能解释"为什么本地实验好好的,上生产就要换库",并为第 3 章的环境搭建定下方向。
一个并发写入引发的惨案
先讲一个高发的翻车现场,它几乎浓缩了本节的全部内容。某团队本地实验一切正常:单进程、单用户、几十轮对话,SQLite 轻快得像没有数据库。上线第一周,三个业务方同时接入同一个智能体:客服机器人写会话记录,分析脚本批量写入存档知识,开发者在 ADE 里手动修订记忆块。某天下午开始,请求间歇性报错,日志里是数据库锁等待超时——单文件存储在并发写入下排起了长队,队尾的请求超时被拒。
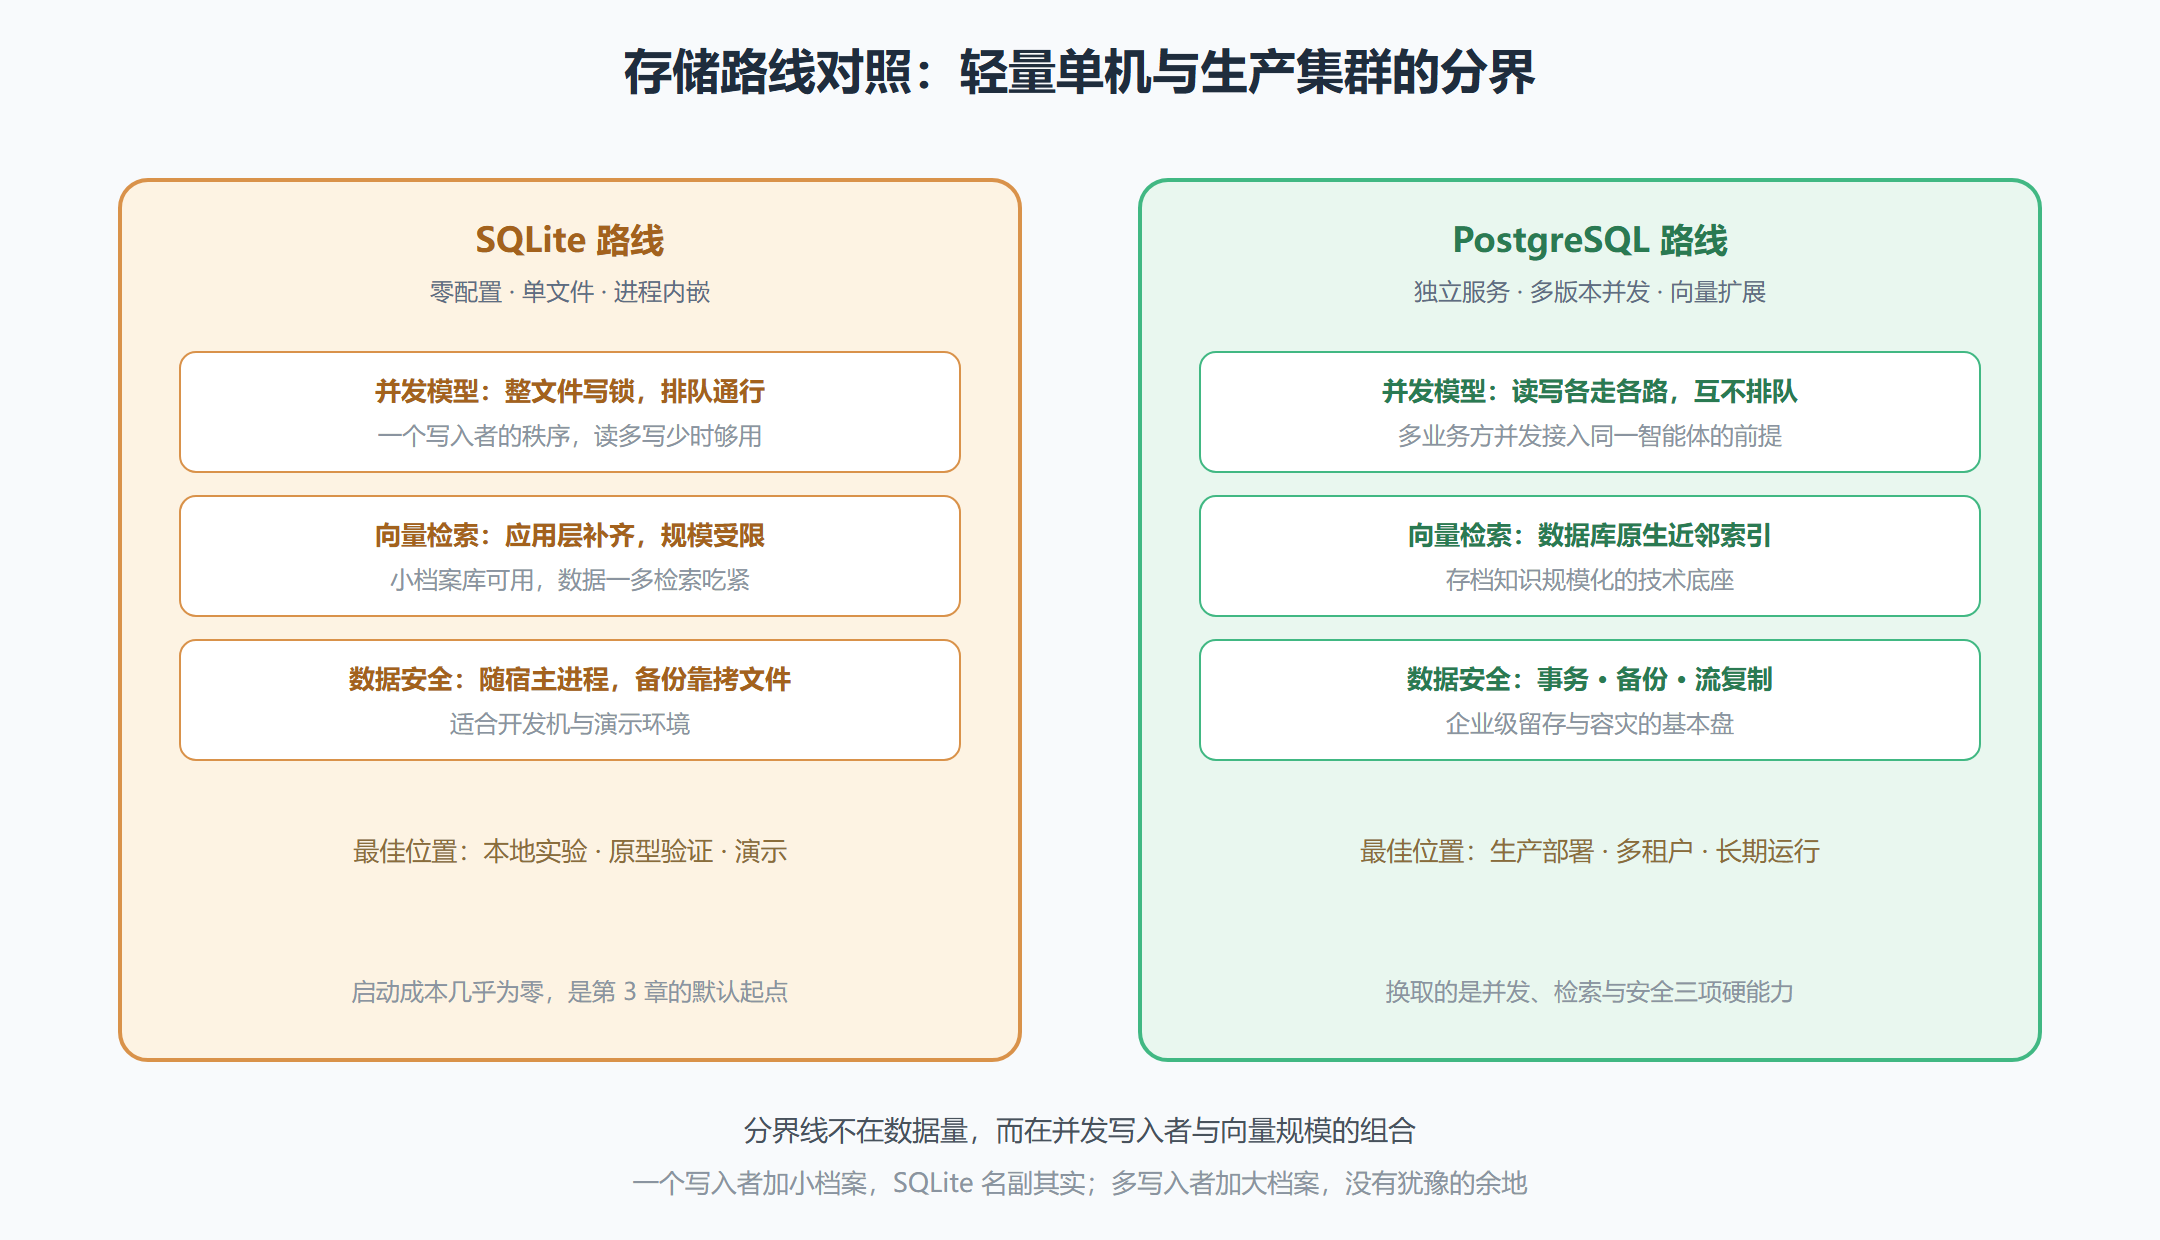
问题不在 SQLite 不行,而在它的适用边界:它以库的形式嵌在进程里,写入时对整个文件加锁,天生服务于"一个写入者"的秩序。PostgreSQL 则是独立的服务进程,多版本并发控制(MVCC)让读写互不阻塞:写者写自己的版本,读者读已提交的快照,互不排队。一个排队伍,一个各走各的路——这就是两类后端的本质分野,也是"实验能凑合、生产必须换"的根源。
Letta 到底往库里放什么
要比较存储策略,先得知道存的是什么。Letta 在存储层维护四类数据,每类对存储的要求不同:
| 数据类别 | 内容 | 访问模式 | 对存储的敏感点 |
|---|---|---|---|
| 智能体元数据 | 配置、模型绑定、工具挂载 | 低频读写 | 事务一致性 |
| 记忆块 | persona、human 及自定义块 | 模型推理中高频读写 | 并发写安全、容量字段 |
| 消息与事件 | 完整对话流、工具调用轨迹 | 高频追加、偶尔回溯 | 写入吞吐、时间排序 |
| 存档向量 | 知识条目及其向量表示 | 写入后按语义检索 | 向量索引与相似度算力 |
前两类是典型的关系型负载,任何数据库都能胜任;消息事件流的追加吞吐,SQLite 与 PostgreSQL 在中等规模下差距不大;真正的分水岭在第四类——向量检索。存档存储的核心操作是"给定查询向量,找出库中最相近的若干条",这要求存储引擎原生理解向量。PostgreSQL 阵营有向量扩展把向量类型与索引(如 HNSW 图索引)带进数据库,一行查询完成近邻搜索;SQLite 路线则要在应用层补齐这块能力,规模一小、数据一多,检索延迟与召回质量都开始吃紧。
图 2-5 两条存储路线的能力雷达与分界线
换库的成本与时机
分界线画清楚了,还要算换库的账。好消息是切换成本被框架吸收了大半:应用层代码不变,客户端无感知,变化只在服务端的连接配置——把指向本地文件的环境变量换成指向 PostgreSQL 的连接串,重启服务即完成迁移(具体操作在第 3 章实操)。数据本身也可迁移:内置的迁移工具会把既有智能体、记忆与历史搬进新库,实验阶段积累的记忆资产不作废。
时机的判断记住一个原则:在第一个真实用户接入之前换。 实验期用 SQLite 是合理的敏捷,但一旦有外部流量、有第二个人要同时访问、存档知识开始批量导入,就到了换库的节点。最糟的时机是事故之后——第 2 章开头那类锁等待故障,本可以在上线前的半天里避免。
走一遍检索的底层
最后把向量检索翻译成看得见的语句,帮助你理解"数据库懂向量"的实感。存档检索在支持向量扩展的 PostgreSQL 里,本质是这样一条查询:
-- 在存档表中找出与查询向量最相近的 5 条知识 SELECT content, embedding <=> '[0.13, -0.42, 0.07, ...]' AS distance FROM archival_passages WHERE agent_id = 'agent-xxxx-xxxx' ORDER BY distance LIMIT 5;
那对奇怪的操作符计算的是向量间的距离,排序后取最近的几条,就是 archival_memory_search 工具返回给模型的结果。之所以强调"数据库原生",是因为近邻搜索可以靠索引在百万级条目里毫秒级完成,而不必把全表读进应用内存逐条比对——数据规模越大,这个差别越是天堑。理解了这一层,你就明白存档存储的"容量近无限"是有条件的:它建立在存储引擎真的擅长这件事之上。
顺带把第 2 章的一个悬念在此收尾:2.2 节说存档"质量纪律重于容量",存储层的视角补上了后半句——容量近无限的前提是引擎扛得住检索负载,而质量纪律决定了值得索引的内容有多少。垃圾条目不仅稀释检索质量,还在持续消耗索引与存储成本。存储选型给了你能力上限,记忆治理(第 5 章)决定你把这个能力用在什么内容上。
关于存储选型的常见疑问
问:能不能一开始就直接用 PostgreSQL,跳过 SQLite? 当然可以,实验从生产同构的存储起步,能省掉一次迁移。选择先 SQLite 的唯一理由是起步摩擦更小——本地开发连数据库服务都不用起。两个方向的成本都低,按团队习惯选即可;真正要避免的是"明知要上生产还一路 SQLite 用到上线前夜"。
问:换库之后,向量检索的准确率会变吗? 会——通常变好。不同实现支持不同的索引结构与距离算法,检索的排序细节存在差异。迁移后的验证清单里,"存档检索抽测"一项正是为此设计:用固定的查询集在迁移前后各跑一遍,对比命中结果,差异显著就调整索引参数。
问:记忆数据需要单独备份吗? 数据库的常规备份策略直接覆盖它——智能体状态就是库里的普通数据表。值得单独想清楚的是保留策略:对话历史与存档知识涉及用户数据,留存多久、如何脱敏、如何响应删除请求,这些是治理问题而非技术问题,最好在上线前与合规同事对齐,而不是等用户来问。
本节要点回顾
- 本质分野:SQLite 整文件加锁、一个写入者排队;PostgreSQL 多版本并发、读写互不阻塞——这是换库的第一理由。
- 四类数据:元数据、记忆块、消息事件、存档向量,前两类谁都能存,后两类决定了后端的上限。
- 向量是分水岭:存档检索的毫秒级近邻查询依赖数据库原生向量索引,规模一大,应用层补齐无以为继。
- 切换成本低:配置换连接串、迁移工具搬数据,但时机应在第一个真实用户之前,而非事故之后。
- 选择口诀:本地实验用 SQLite 起步,真实流量、多方并发、档案规模化,三条中一条就上 PostgreSQL。
至此第 2 章的原理拼图完整:分层记忆、自我编辑闭环、服务化架构、存储底座。第 3 章把这套蓝图搬到你的机器上,开始真正的动手实验。