2.4 系统架构:Letta Server 与客户端解耦
2.4 系统架构:Letta Server 与客户端解耦
本节摘要:Letta 采用彻底的客户端-服务端架构:智能体是服务端数据库中的持久资源,一切交互经由 REST API 完成,CLI、ADE、Python 与 TypeScript SDK 都是协议对等的客户端。本节自顶向下拆解这条请求路径上的各个部件,解释解耦设计换来了什么、又要求什么。读完本节,你能画出从一次发消息到状态落库的全路径,并据此规划自己的部署形态。
为什么一定要有个 Server
先回答一个初学者最常问的问题:为什么不能像普通库一样 import 进来直接用,非要跑一个服务?答案藏在智能体的本质里。普通库的调用是无状态的,进程结束一切归零;而智能体的核心资产是必须跨进程、跨时间存活的状态——记忆块、对话历史、工具配置。状态要持久且可共享,就需要一个常驻的、统一管理数据的主人,这就是 Letta Server。
服务端一旦常驻,连锁的好处自然涌现:多个客户端可以同时接入同一个智能体(你的脚本在跑批,同事的 ADE 在观察,线上业务在收发消息,三方看到的是同一份状态);状态的一致性有了单一的仲裁点,不存在两个进程各改各的副本;升级与迁移只需动服务端,客户端无感。第 1 章讲"状态是一等公民",在架构上的直接体现就是:一等公民需要一个常住户口簿,Server 就是那个户口簿的管理机关。
请求的全路径:五段旅程
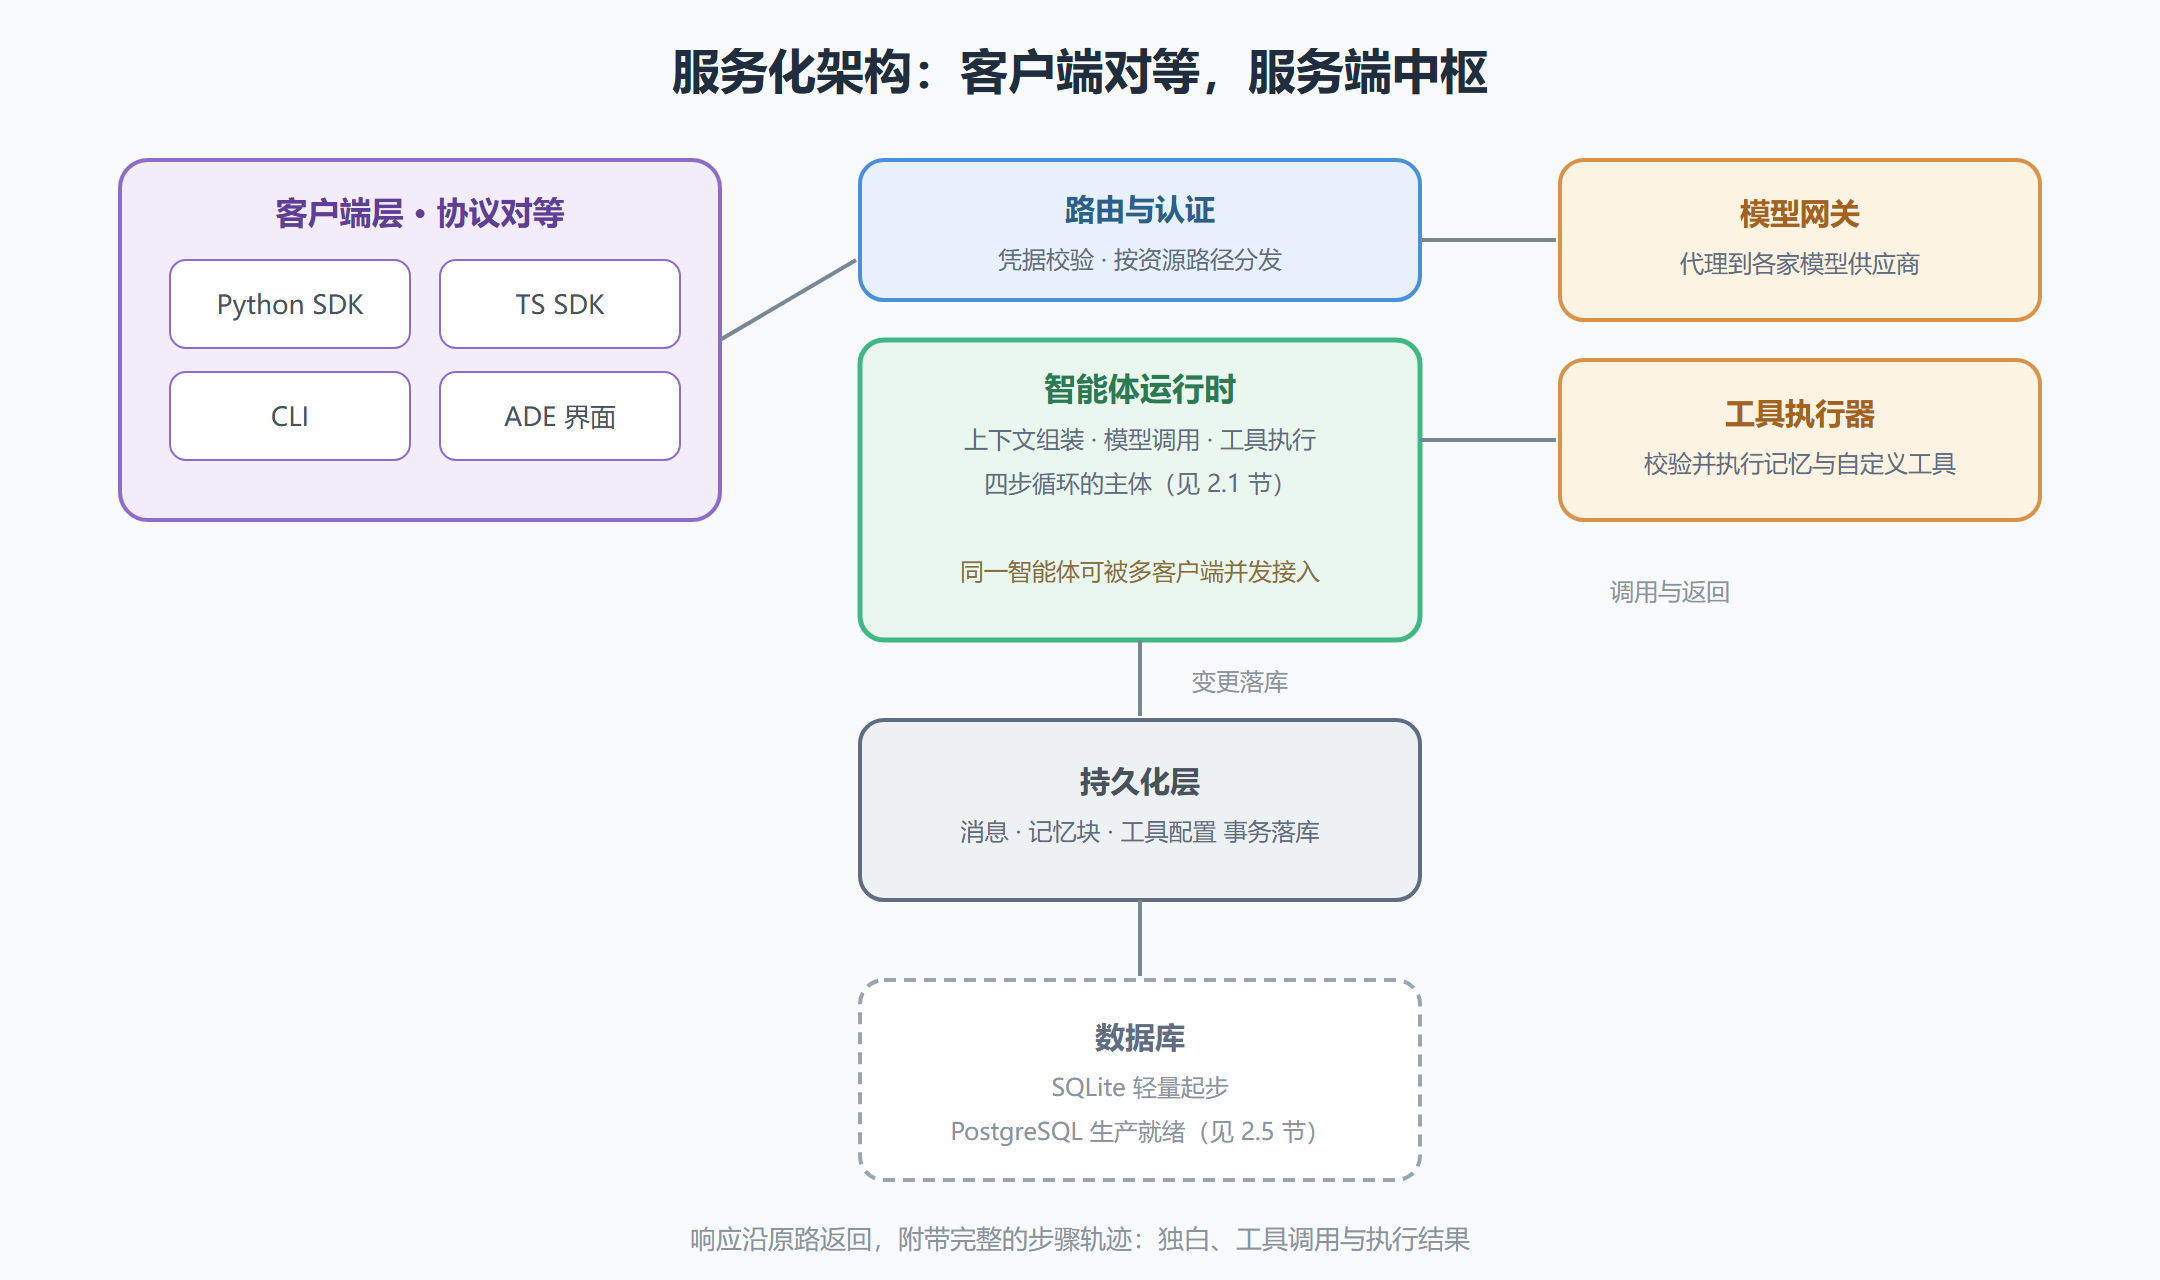
一条消息从发出到拿回响应,要经过五段旅程。理解这五段,排查问题时你就能定位故障发生在哪一段:
- 客户端封装:SDK 或 CLI 把你的调用翻译成符合协议的 HTTP 请求,携带认证凭据与结构化参数。
- 路由与认证:服务端校验凭据,按资源路径把请求分发到对应的处理模块——智能体、记忆块、工具各有各的路由。
- 智能体运行时:核心地带。加载该智能体的完整状态,执行 2.1 节的四步循环——组装上下文、调用模型、执行工具、组装响应。模型调用被代理到对应的供应商网关,工具调用在本节稍后的执行器里完成。
- 持久化层:循环中的一切变更——新消息、修订后的记忆块、工具结果——以事务方式写回数据库。SQLite 或 PostgreSQL 的抉择留给 2.5 节。
- 响应组装:把推理结果与完整的步骤轨迹(独白、工具调用、执行结果)打包返回,客户端拿到的不只是答案,还有全过程。
用一段代码把前两段具象化——值得注意的是客户端代码里没有任何状态管理逻辑,这是解耦的直接体现:
from letta_client import Letta # 客户端只是协议的翻译器:指向服务端地址,携带访问凭据 client = Letta(base_url="http://localhost:8283") # 发送消息:客户端不知道状态在哪、记忆怎么组装,只负责发与收 resp = client.agents.messages.create( agent_id="agent-xxxx-xxxx", messages=[{"role": "user", "content": "把这次评审的结论存档。"}], )
图 2-4 Letta 服务化架构:一条消息的五段旅程
智能体即资源:REST 语义的含义
解耦架构里最漂亮的一点,是智能体被建模成了标准的网络资源。创建一个智能体是一次资源创建,读它的记忆块是一次资源查询,改一块记忆是一次资源更新——所有操作都能用朴素的 REST 语义表达。这意味着两件事:其一,任何能发 HTTP 请求的语言都能接入,官方 SDK 只是便利封装,不是准入门槛;其二,运维世界的既有工具链——负载均衡、健康检查、API 网关——都可以直接作用于智能体服务,不需要为 AI 特殊发明一套。
资源化的另一个衍生品是多租户与隔离成为服务端的原生议题:不同团队共享同一台 Letta 服务时,智能体按组织与用户划分归属,记忆互相不可见。第 5 章讲多智能体协作时会看到,共享必须显式建立(比如共享记忆块),默认的边界是隔离——这个默认值对企业落地至关重要。
解耦的账单:你多付了什么
诚实起见,把解耦的代价也摆上桌。第一笔是运维成本:多了一个要跑的进程、一个要管的数据库,比起 pip install 后直接调用的单体库,部署复杂度实打实上去了——第 3 章整章都在偿还这笔成本。第二笔是延迟:请求走网络、状态读写走数据库,单次响应天然比进程内调用慢上一截;对延迟极端敏感的场景,这笔开销必须计入设计。第三笔是排障面:故障域从"一个进程"扩展为"客户端、网络、服务端、数据库"四段,好在 2.3 节的步骤轨迹加上服务端日志,基本能把问题钉到具体一段。
对照收益与账单,适用边界就清楚了:只要智能体需要长期存活、多方接入或集中治理,解耦是必然选择,账单值得付;反之,一个跑几分钟就结束的一次性任务,强行套服务化架构属于自找麻烦——先确认需求,再选架构。
部署形态的演进路径通常是三步:本地起服务跑实验(第 3 章的位置);搬进内网服务器或容器平台,加访问密码与专网隔离(小团队生产);多团队共享时再上多实例与集中数据库,由平台团队统一运维。三步对应的是完全相同的代码——变的只是部署环境与凭据管理。理解了这一点,你就明白为什么本册花一整章讲环境却几乎不谈"部署技巧":架构已经把部署的复杂度收敛成了运维问题,剩下的都是工程组织的常识。
关于架构的常见疑问
问:服务端会不会成为性能瓶颈? 分情况。服务端本身的开销主要是调度与数据库读写,单机支撑数十个活跃智能体绰绰有余;真正的压力通常在两处——模型供应商的响应速度(占一次响应的大头)与数据库的写入吞吐(换 PostgreSQL 解决)。架构层面的扩容手段(多实例加负载均衡)在智能体无状态接入、状态集中于数据库的设计下是顺手的,不需要为框架特殊设计。
问:为什么不把记忆管理做成嵌入式库,省掉服务? 1.2 节已经论证过状态的持久与共享需要常驻管理者,这里补一个工程视角:嵌入式形态下,"谁负责写入冲突、谁负责迁移升级、谁负责备份"全部下放给每个接入方,十个人接入就有十套隐患。服务端把这些问题集中收编一次,是复杂度的正确定价。
问:直连数据库做分析报表可以吗? 只读的分析场景(统计消息量、导出记忆快照)直接查库问题不大;但要清楚你在框架约束之外操作,写操作永远走 API——绕过框架的写入没有经过校验闸门,也没有触发上下文重组,出的错最难查。
本节要点回顾
- 服务端的必要性:跨进程、跨时间存活的状态需要一个常驻的统一管理者,这是架构的出发点。
- 五段旅程:客户端封装、路由认证、运行时循环、持久化、响应组装,排障时逐段定位。
- 资源化语义:智能体是标准网络资源,任何语言可接入,运维工具链可直接复用。
- 默认隔离:多租户下记忆互不可见,共享必须显式建立,这是企业落地的安全默认值。
- 解耦账单:运维、延迟、排障面三项成本,用长期存活与多方接入的收益去换。
下一节钻进架构的最后一层:同一套分层记忆,落在 SQLite 与 PostgreSQL 上分别是什么表现,分界线到底画在哪里。