3.1 两种点火方式:Pip 安装与 Docker 镜像
3.1 两种点火方式:Pip 安装与 Docker 镜像
本节摘要:把 Letta 跑起来有两条主路:Pip 装进 Python 环境的本地运行,与 Docker 镜像的容器化运行。前者轻快贴身、方便调试,后者环境自洽、天然隔离。本节讲清两条路线的安装步骤、启动验证与各自的适用场景,并给出第一个"服务已就绪"的验证请求。读完本节,你的实验台完成第一次点火。
两条路线的气质差异
选安装方式之前,先理解一个事实:Letta 不是跑在请求里的库,而是一个常驻的服务进程,它要独占一个端口、管理一份持久化存储、长时间运行。这个定位决定了两种安装方式的气质差异。
Pip 路线把框架装进你的 Python 环境:进程直接跑在宿主机上,依赖你的解释器版本与依赖库组合。它贴身——改代码、看日志、进调试器都是原生的体验;它也挑剔——Python 版本差半代、依赖冲突、系统缺组件,都可能变成启动报错。Docker 路线把服务连同它的全部依赖封进镜像:启动即运行,环境与你的宿主机完全隔离;代价是多一层抽象,改内部代码、直接查看运行日志都要绕经容器机制。
一条经验法则:学习和开发期用 Pip,交付和部署期用 Docker。 学习期你会反复改配置、试版本、查行为,贴身比隔离重要;部署期你关心的是"在任何机器上表现一致",隔离立刻价值千金。两者也不互斥——本机用 Pip 开发,服务器用 Docker 交付,是很多团队的真实工作流。
Pip 路线:四步点火
Pip 路线的完整流程如下,第一步的虚拟环境不可省略——它把框架依赖与系统 Python 隔开,将来卸载或升级都不留残骸:
# 1. 建立并激活独立虚拟环境(以 venv 为例) python -m venv .venv source .venv/bin/activate # Windows 下为 .venv\Scripts\activate # 2. 安装框架本体 pip install letta # 3. 配置模型密钥(以 OpenAI 为例,其他供应商同理) export OPENAI_API_KEY="sk-..." # Windows 下用 set 或 powershell 语法 # 4. 启动服务端,默认监听本机 8283 端口 letta server
看到日志里出现服务监听地址,点火就算完成。验证的方式不是肉眼看日志,而是发一条真实请求:
from letta_client import Letta client = Letta(base_url="http://localhost:8283") # 列出智能体:服务活着、数据库可读的最直接证据 print(client.agents.list()) # 首次启动返回空列表,这本身就是好消息
返回空列表而不是异常,说明服务、存储、API 三层全部贯通。至此实验台点火成功,1.2 节那段创建智能体的代码此刻就可以真跑通了。
图 3-1 两条点火路线的全流程对比
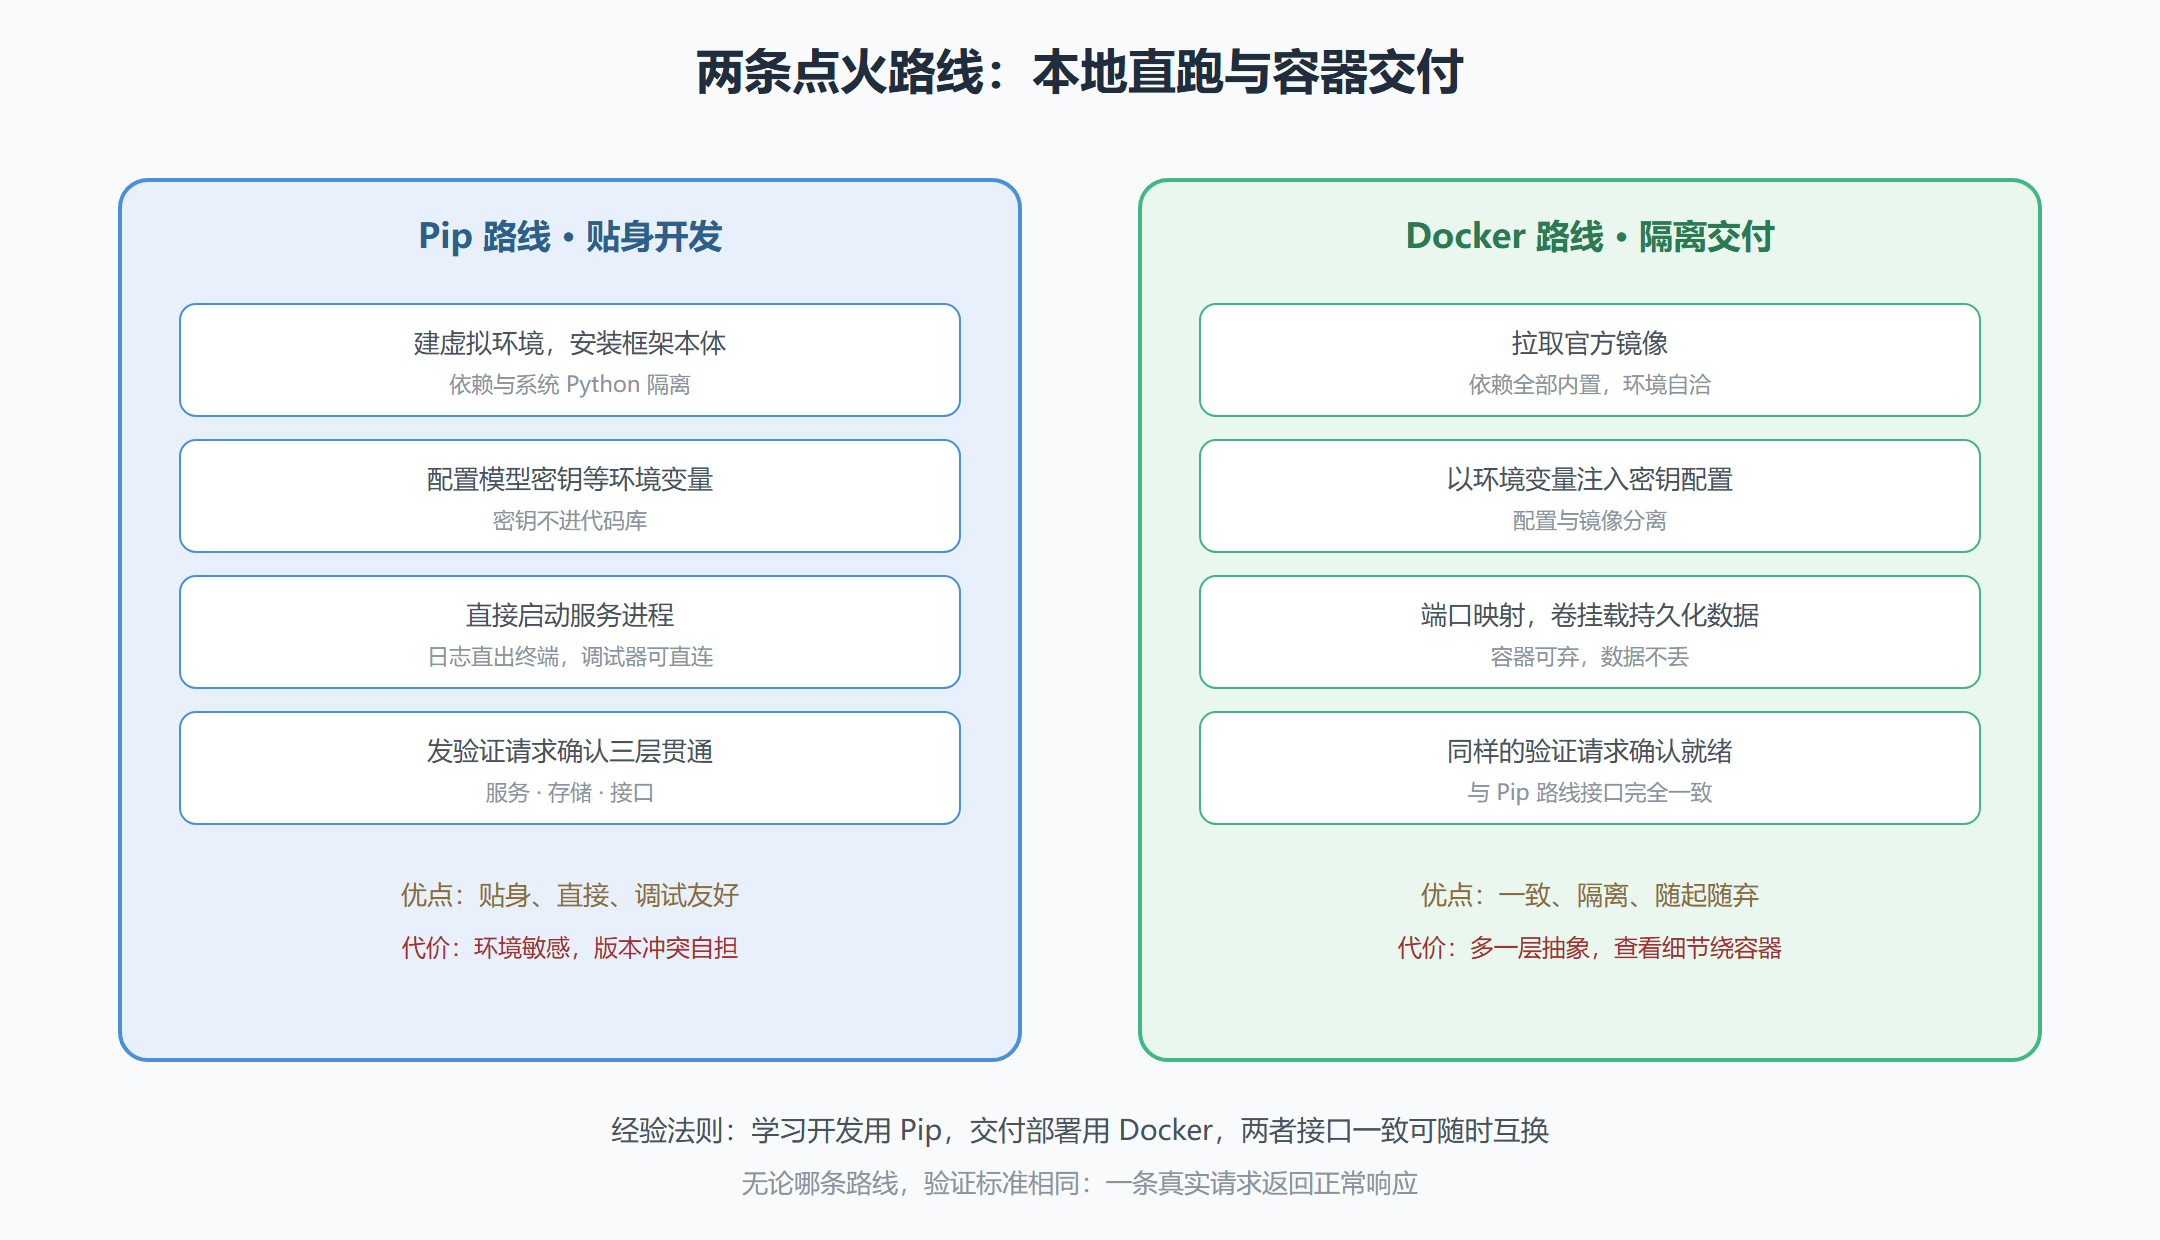
Docker 路线:一条命令的镜像启动
Docker 路线的最小启动只需要一条命令,但其中的每个参数都值得看懂——它们分别对应配置注入、端口暴露与数据持久化三件事:
docker run -d \ --name letta-server \ -p 8283:8283 \ -v letta_data:/root/.letta \ -e OPENAI_API_KEY="sk-..." \ letta/letta
三个关键参数各有深意。-p 8283:8283 把容器内的服务端口映射到宿主机,你的客户端代码访问宿主机端口即达服务;-v letta_data:/root/.letta 把数据目录挂载为命名卷——这一项最容易被省略,后果是容器一删数据全没,智能体的记忆随容器一起火化;-e 注入的环境变量与 Pip 路线完全同名,配置习惯两边通用。
容器起来后,验证方式与 Pip 路线一致:同样的客户端代码、同样的地址、同样的空列表响应。这种"接口一致、路线互换"的特性是架构解耦的又一份红利——2.4 节讲过客户端只认协议,至于服务跑在宿主机还是容器里,客户端无从知晓也不必知晓。
两个新手高发的启动故障
点火失败的剧本高度集中,这里预演两个最常见的。剧本一:端口被占。 报错信息通常直说端口已被监听。多数是之前起过的服务进程没退干净,找到旧进程结束它,或换一个宿主机端口映射。剧本二:模型连接失败。 服务本身起来了,第一次对话却报上游错误。八成是密钥环境变量没传进进程——Pip 路线常见于在另一个终端窗口 export、服务却在原窗口启动;Docker 路线常见于漏写 -e 注入。排解要领是先确认服务日志里认到了密钥,再谈对话功能。
两个剧本共享同一条排查心法:先定位是哪一层的问题,再动手。 端口问题死在"进程监听"这一层,特征是启动日志直接报错;密钥问题死在"上游调用"这一层,特征是服务正常监听、对话时才报错。看到报错先问自己"它发生在启动时还是对话时",这个习惯能把一半的启动类故障排除时间省下来。
💡 把"发验证请求"变成每次环境变更后的固定动作:改了配置、升了版本、迁移了数据库,都跑一遍那段创建与列出的代码。它花掉几秒,换回的是对实验台健康状态的确定性——这份确定性在第 5 章的复杂实验里会显得格外值钱。
Python 版本与依赖的两个暗坑
Pip 路线还有两个高频暗坑值得提前打预防针。暗坑一:Python 版本擦边。 框架对 Python 版本有明确的支持区间,用得太新(刚发布的大版本)或太旧都可能遇到依赖编译失败或运行时报错。虚拟环境创建后先确认版本在支持区间内,再动手安装。暗坑二:全局环境污染。 跳过虚拟环境直接往系统 Python 里装,短期能跑,长期的代价是依赖冲突——其他项目升级了某个共同依赖,你的实验台莫名其妙起不来。虚拟环境的十几秒成本,防的是数小时的排查,这笔账怎么算都划算。
Docker 路线的对应暗坑是镜像与数据卷的版本错配:升级镜像后,旧数据卷里的数据结构若与新版本不匹配,服务可能启动异常。升级前看一眼版本说明里的数据兼容性提示,升级后先跑那条验证请求再接入业务。
让点火状态可持续:重启之后
一次点火成功不难,难的是每次重启都成功。三个习惯让实验台的"活着"成为常态而非巧合。其一,启动方式文档化:把自己实际使用的启动命令(含全部环境变量与参数)写进项目笔记,下次照抄,不靠记忆重组。其二,数据与代码分离:数据卷或数据库服务独立于服务进程存在,容器可删、环境可重建、数据不动。其三,验证请求脚本化:把 3.1 节那段验证代码存成小脚本,每次重启后跑一遍——这几秒的仪式,换来的是"确认健康再开始工作"的确定性。
本节要点回顾
- 服务定位:Letta 是常驻服务进程而非请求内库,这决定了安装方式围绕"进程怎么跑、数据放哪"展开。
- 路线选择:学习开发用 Pip 贴身调试,交付部署用 Docker 隔离一致;两者接口一致、可随时互换。
- Pip 四步:虚拟环境、安装、配密钥、启动,缺一步都会在后面某处还债。
- Docker 三参:端口映射、数据卷、环境变量注入,数据卷最易被省略而酿成记忆火化事故。
- 验证仪式:以一条真实请求作为环境变更后的固定检查,维持实验台健康状态的确定性。
下一节处理点火之后的第一个重大决策:什么时候从单文件存储迁往 PostgreSQL,以及迁移怎么做到记忆一条不丢。