3.2 从 SQLite 迁移到 PostgreSQL
3.2 从 SQLite 迁移到 PostgreSQL
本节摘要:迁移的触发信号、准备工作、执行步骤与验证方法,本节完整走一遍。核心结论有两条:迁移的操作成本很低(配置换连接串加数据搬运),但时机选择很重要——第一个真实用户接入之前是最佳窗口。读完本节,你能独立完成一次"记忆零丢失"的存储升级,并建立迁移后的验证清单。
换胎的时机信号
第 2 章已经讲透两类后端的原理差异,本节只谈实操。动手之前,先确认你真的到了该换的时候——下面三类信号中任何一类出现,就值得排期迁移;一条都没有,SQLite 还能再陪你一阵。
信号一是多方并发:第二个人或第二个程序要同时访问同一个智能体。信号二是真实流量:智能体从实验玩具变成有人依赖的服务,可用性开始有承诺。信号三是档案规模化:存档知识从几十条增长到成千上万条,语义检索的延迟肉眼可见。三类信号本质都是 2.5 节那条分界线的现实投影——并发写入者变多,或向量检索变重。
提前识别信号还有个实用技巧:给你的实验记一笔"成长日志"。每次实验台的用法发生变化(多了一类写入方、档案批了一次量、有人开始把它当工具用),就在日志里加一行。信号往往不是突然出现的,而是慢慢渗进来的——有日志的人能在渗入期就看见它,没日志的人要在第一次锁等待报错时才与信号相遇。
准备:一个带向量能力的 PostgreSQL
迁移的第一步不是动 Letta,而是把新数据库立起来。生产上这通常由 DBA 或云服务完成;本地实验最方便的做法是用容器起一个自带向量扩展的 PostgreSQL 镜像,一步到位拿到向量能力。动手前顺手确认三件事:磁盘余量够新库写入(记忆数据不大,但日志会涨);端口不与既有服务冲突;容器重启策略按生产习惯设置——数据库可比应用服务金贵得多。下面这条命令在本地立起一个即用的库:
docker run -d \ --name letta-pg \ -e POSTGRES_DB=letta \ -e POSTGRES_USER=letta \ -e POSTGRES_PASSWORD=choose_a_strong_password \ -p 5432:5432 \ pgvector/pgvector:pg16
四个环境变量分别定义了库名、用户、密码与端口,与 3.1 节 Docker 路线的一贯风格相同:配置经由环境变量注入。用这个镜像而不是官方默认镜像,是本步唯一的讲究——它预装了向量扩展,省去手工安装扩展的步骤。库立起来后,记下连接所需的全部要素:主机、端口、库名、用户名、密码。
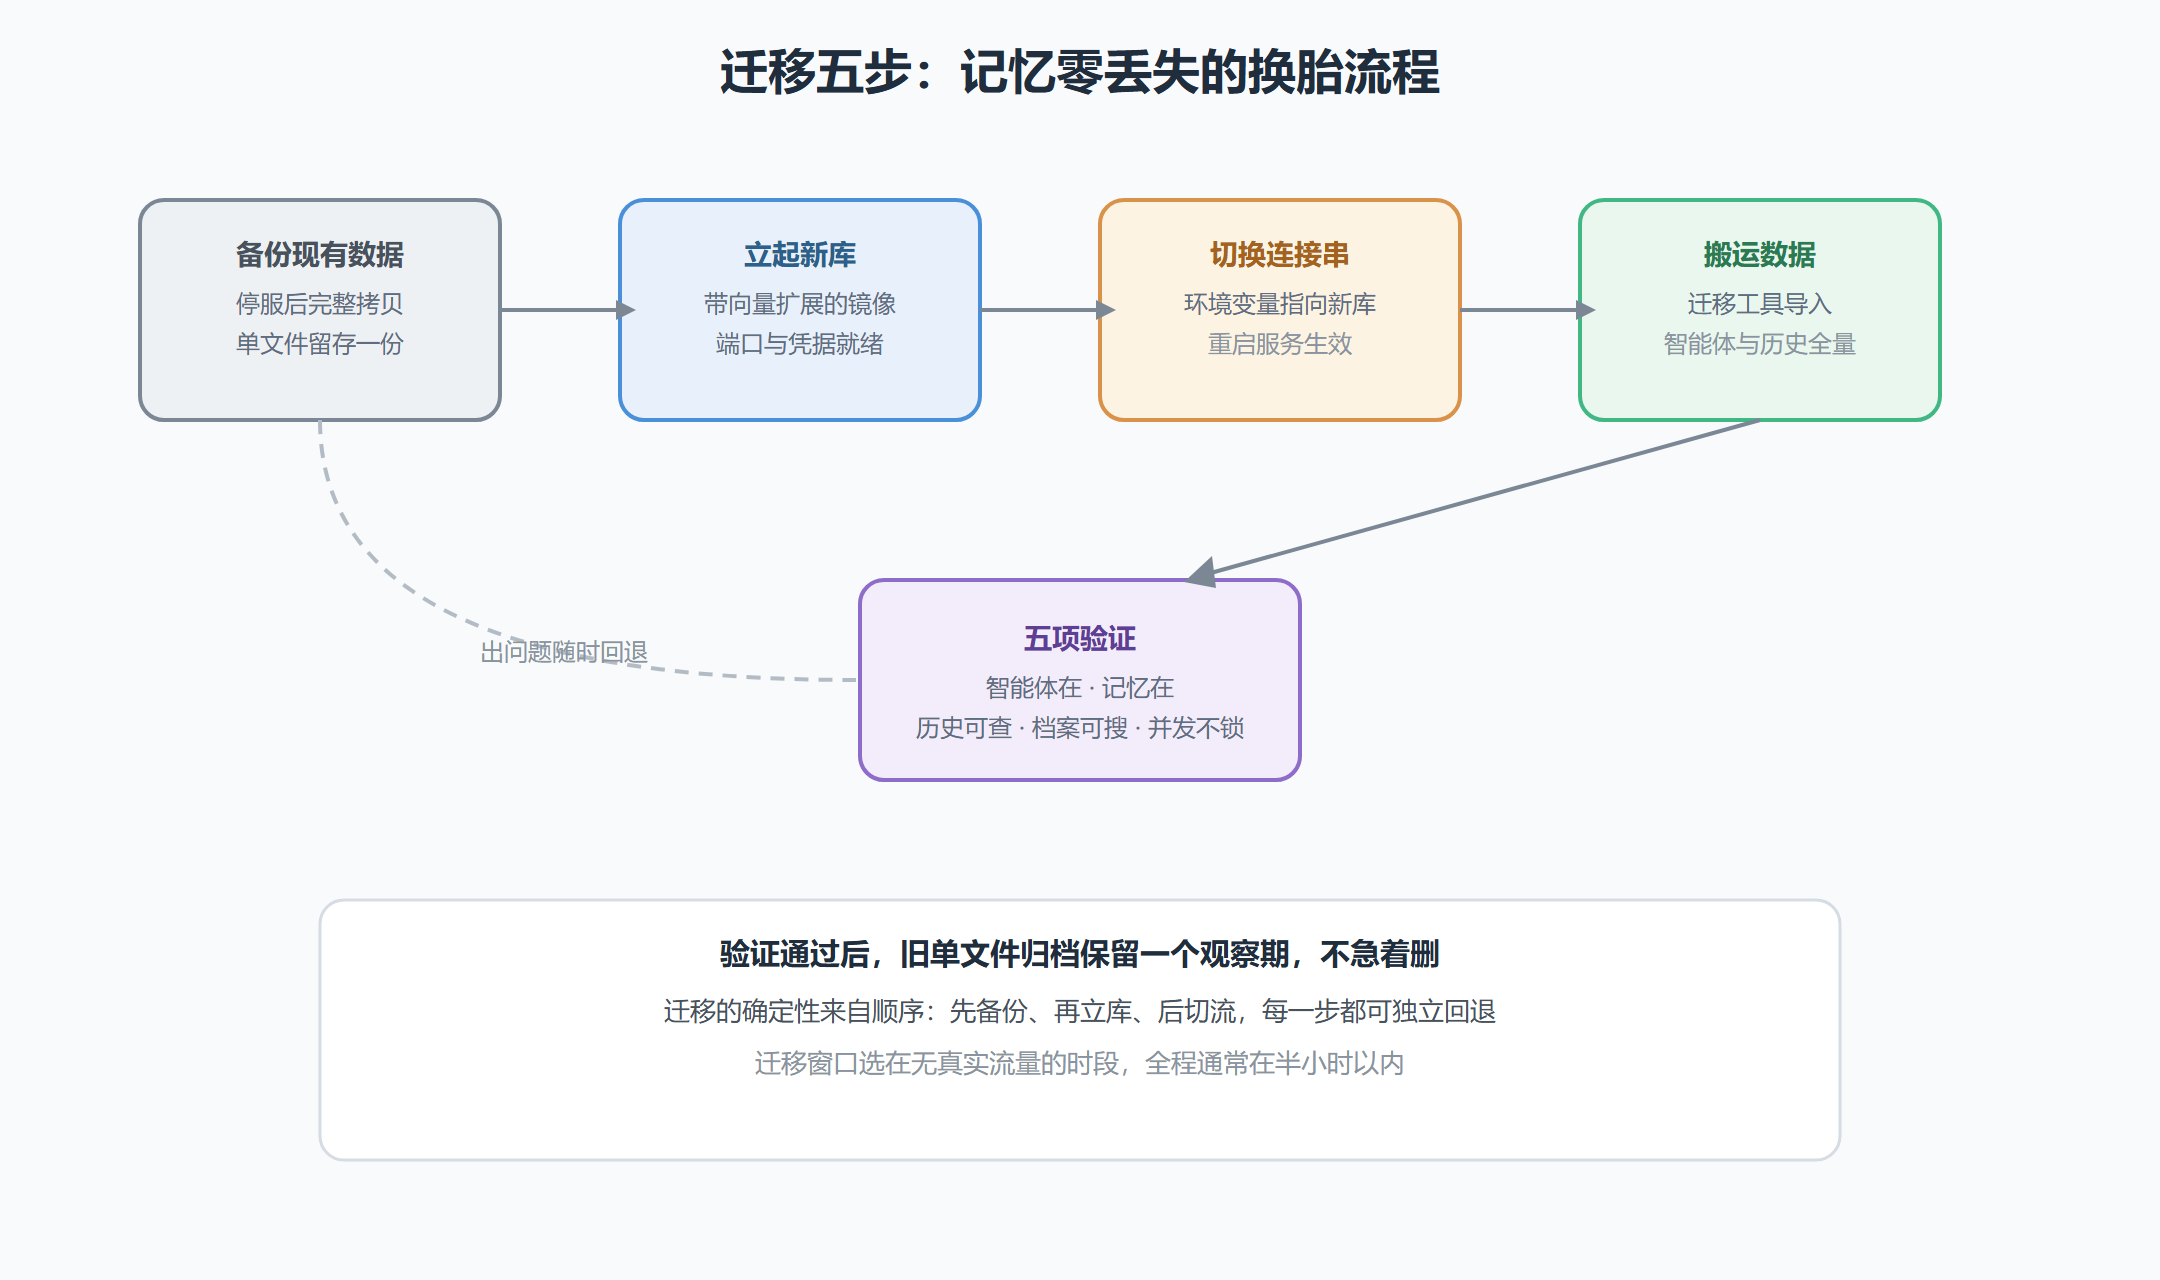
图 3-2 存储迁移路线:从单文件到数据库服务
执行:切换连接与搬运数据
新库就位后,迁移的主戏是两幕。第一幕切换连接:把服务端的存储指向从本地单文件改为 PostgreSQL 连接串,环境变量是唯一的开关:
# 连接串包含五要素:用户、密码、主机、端口、库名 export LETTA_PG_URI="postgresql+pg8000://letta:choose_a_strong_password@localhost:5432/letta" # 重启服务,服务端将以新库为存储 letta server
第二幕搬运数据:让框架把旧存储中的智能体状态、记忆块、对话历史与存档向量导入新库。搬运走框架自带的迁移机制,完成后再重启一次服务。整个过程没有手写的数据转换脚本——数据格式由框架负责,你的责任只在顺序:先备份、再切库、后搬运,每一步可独立回退。
验证:五项清单一个不能少
搬运完成的标志是命令退出,而非迁移正确。真正的验收靠五项检查,顺序执行:
from letta_client import Letta client = Letta(base_url="http://localhost:8283") # 验证一:智能体数量与名称与迁移前一致 agents = client.agents.list() # 验证二:抽一个智能体,记忆块内容完好 blocks = client.agents.blocks.list(agent_id=agents[0].id) for b in blocks: print(b.label, "=>", b.value[:50]) # 与迁移前记录的样本比对 # 验证三:历史消息可回溯 msgs = client.agents.messages.list(agent_id=agents[0].id, limit=10) # 验证四:存档语义检索有结果(前提是旧库里有档案) hits = client.agents.archival_memory.search( agent_id=agents[0].id, query="付款条款", limit=3, )
第五项不在代码里:并发检查。开两个终端同时向同一个智能体发消息,观察是否还出现等待与报错——这正是当初迁移的动机,验一遍才算闭环。五项全绿,迁移完成;任何一项异常,用开头的备份回退,排查后再来。⚠️ 最常被跳过的是验证四:档案向量在搬运中若因维度不一致而失败,日常对话完全看不出来,直到某天检索悄悄变空。
五项验证有个共同的前提:迁移前留好对照样本。 建议迁移前先记录一份"迁移前快照"——智能体清单及数量、每个智能体各记忆块的字数与首行内容、最近十条消息的摘要、存档检索三个常用查询的返回条数。快照花不了十分钟,却让五项验证从"感觉正常"升级为"逐项比对"。工程验证的可信度,从来取决于对照物的质量,而不是验证人的自信程度。
迁移中的三个高频疑问
问:迁移过程中服务要停多久? 迁移窗口 = 停写时间。本地实验无所谓;生产迁移建议选低峰时段,常规规模的记忆数据全程在半小时以内,其中大部分时间花在验证而非搬运。提前把验证脚本写好,窗口可以压得很短。
问:迁移会改变智能体的行为吗? 不应该。存储层对上层是透明的——同样的状态、同样的上下文组装逻辑。若迁移后发现行为变化,先查验证清单哪一项没过,再怀疑行为问题;经验上,九成的"迁移后行为异常"实为迁移不完整的副作用(比如档案搬运不完整导致检索结果变少)。
问:之后还能迁回去吗? 能,方向是对称的——把连接串改回本地存储、用迁移机制反向搬运。但你大概率不会想回去:换库的理由(并发、向量、安全)不会消失。回退方案的价值在于迁移当天的兜底,而非长期的双向自由。
迁移之后的两件小事
迁完别急着翻篇,两件收尾小事值得做。其一,旧的单文件归档保留一个观察期——它此刻就是你的回退方案,观察一两周确认新库稳定后再处理。其二,把新的连接串纳入你的配置清单管理(下一节的主题):连接串里躺着数据库密码,它的保存方式应该按密钥对待,而不是随手写进脚本或文档。这份对凭据的敏感,正是下一节要展开的正题。
第三件小事留给有余力的人:借这次迁移把存储监控顺手建起来。连接数、磁盘占用、慢查询日志——三项最基本的监控就足以让你下次在"用户报障"之前先看到异常。迁移日是基础设施意识觉醒的最佳时机,此时你比任何时候都清楚"存储是智能体的生命线"这句话的分量。
最后换个视角收束本节:迁移不是一次性的技术动作,而是实验台成长的里程碑——它标志着你的智能体从"个人的实验对象"变成"系统的生产资产"。从这天起,数据库的升级公告、容量水位、备份演练都与你有关。有人觉得这些是负担,换个角度看,这正是你的记忆实验真正开始产生"资产属性"的证据:值得被备份、被监控、被认真对待的数据,才谈得上长期进化。
本节要点回顾
- 时机信号:多方并发、真实流量、档案规模化,三类信号出现任何一类即排期迁移。
- 准备要点:新库必须自带向量扩展,本地用带向量能力的镜像一步到位。
- 执行顺序:备份、立库、切连接串、搬运数据,每一步可独立回退,顺序即安全。
- 五项验证:智能体在、记忆块在、历史可查、档案可搜、并发不锁——少验一项都是给未来埋雷。
- 收尾两事:旧文件留观察期,新连接串按密钥管理。
下一节把散落的环境变量收拢成一份清单:哪些必须懂、哪些可以缓,以及凭据管理的正确姿势。