3.1 解剖流水线总览:捕获、解析、呈现三段工序
3.1 解剖流水线总览:捕获、解析、呈现三段工序
本节给全书装一张"机箱内部图"。此前的章节把 Wireshark 当黑盒用,接下来三章(解析体系、过滤体系、统计工具)全部建立在流水线认知上:知道帧在哪一段被丢弃、在哪一段被翻译、在哪一段被染色,你才能理解每个功能为什么那样设计。本节先走一遍全程,后面三节逐站深入。
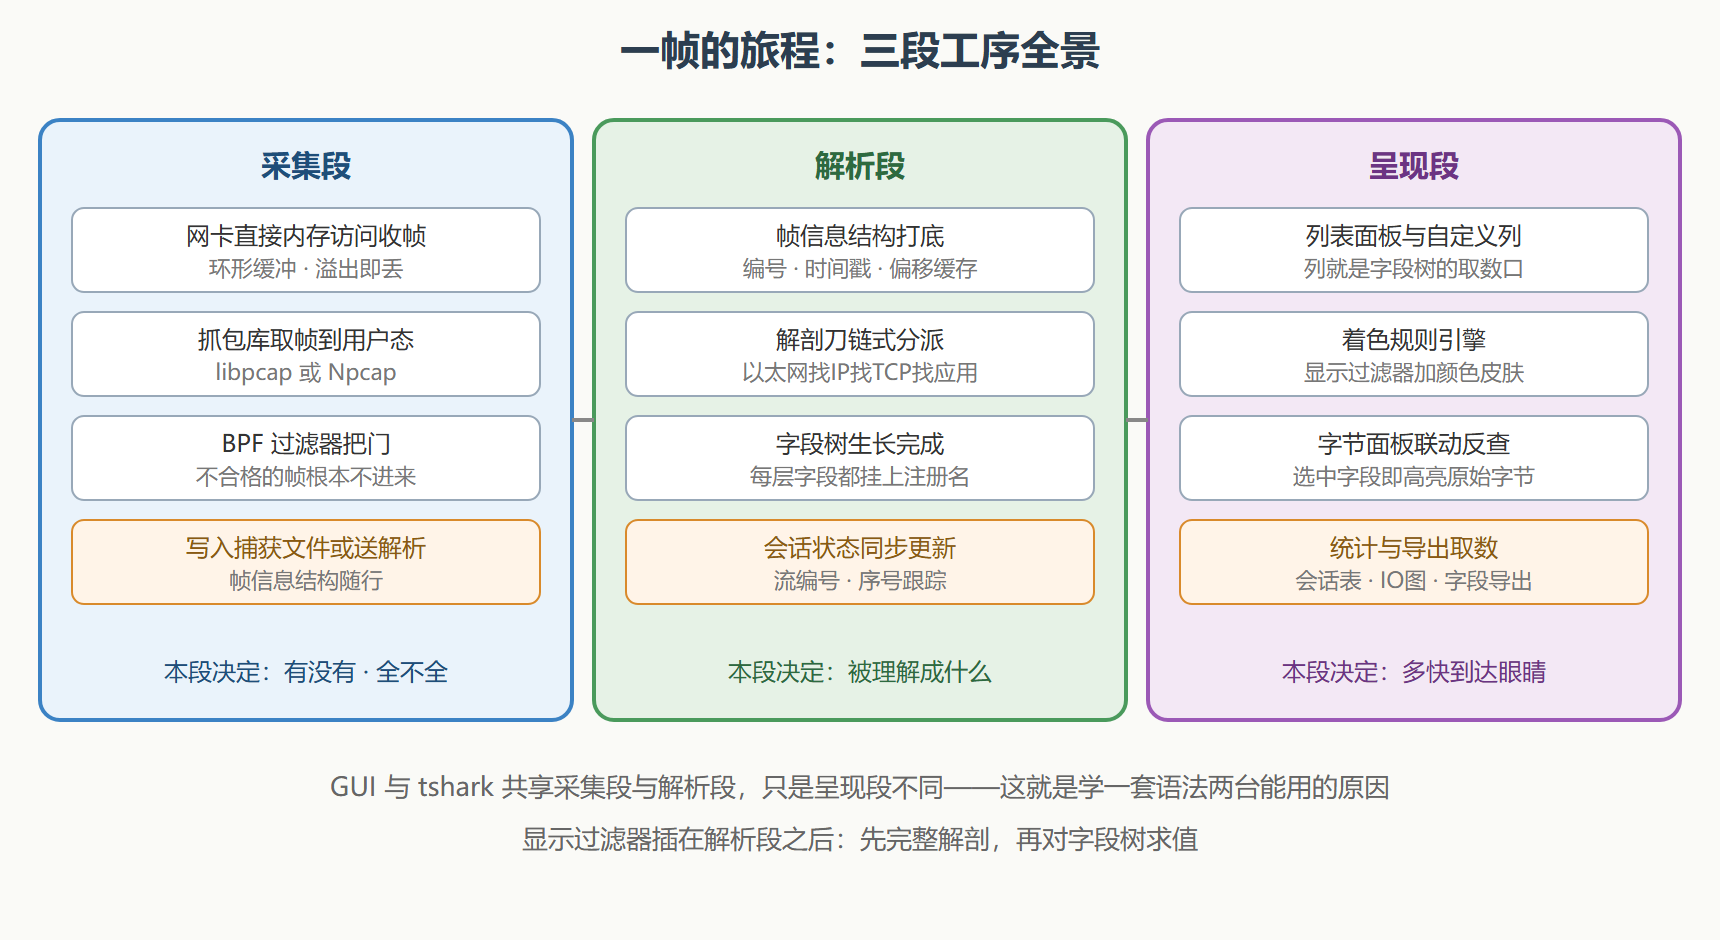
三段工序的走线
第一段,采集。 帧到达网卡,网卡用直接内存访问把它写进内核维护的环形缓冲,抓包库(Linux 的 libpcap 走内核数据包接口,Windows 的 Npcap 走自家驱动)从缓冲把帧复制到用户态,捕获过滤在这一步执行。这一段决定帧"有没有被拿到、拿得全不全"。
第二段,解析。 每帧被包上帧信息结构(编号、时间戳、各层偏移缓存),然后交给解析引擎。引擎从链路层解析器起手,逐层分派:以太网解析器读出类型字段,发现是 IPv4 就调 IPv4 解析器;IPv4 读出协议字段 6,就调 TCP 解析器——如此链式展开,最终长出一棵字段树。这一段决定帧"被理解成什么"。
第三段,呈现。 GUI 把字段树渲染成三块面板(列表、详情、字节),着色规则引擎拿显示过滤器给每帧上色,统计工具和导出功能也从字段树取数。这一段决定信息"以什么密度、什么颜色到达你的眼睛"。
帧信息结构:每帧的档案袋
解析段开始前,每帧已经带上一份档案——帧信息结构。用 tshark 直接观察它的字段:
$ tshark -r first.pcapng -c 2 -T fields -e frame.number -e frame.time_relative \ -e frame.len -e frame.cap_len -e frame.protocols 1 0.000000 74 74 eth:ethertype:ip:udp:dns 2 0.031402 90 90 eth:ethertype:ip:udp:dns
最后一列 frame.protocols 是流水线的"途经记录":这帧依次被以太网、IPv4、UDP、DNS 四把解剖刀处理过。排障时它是快速分诊工具——一眼看出这帧没走到 TCP(协议栈在这里断了),比展开详情树快得多。frame.len 与 frame.cap_len 相等说明没被截尾;一旦后者小,就要想起 2.1 节的快照长度。
同一引擎,两台机器
GUI 与 tshark 的关系值得单独强调:两者共享采集段与解析段,只在呈现段分家。这带来两个推论。其一,字段知识完全互通——你在 GUI 详情树里看到的每个字段名,就是 tshark 与显示过滤器的字段名(详情树里右键"作为过滤器引用"就是这个原理)。其二,性能特性也互通——GUI 大文件卡,本质是解析段和呈现段的工作量,tshark 同样要付出解析成本,只是不用渲染。
# 同一份数据,两台机器给出同构答案 $ tshark -r first.pcapng -Y "dns" -T fields -e dns.qry.name -c 2 www.example.org www.example.org # GUI:过滤器栏输入 dns,看到的就是同样的两帧
三段工序各自埋着什么雷
每段都有典型故障模式,先立个索引,后面各节细讲:
- 采集段:内核缓冲溢出(丢帧)、快照长度截尾(载荷不全)、镜像口超载(采集系统先于被测系统崩溃)——3.2 节。
- 解析段:端口误判(非标准端口上的私有协议被当别的协议解剖)、启发式失手、超大流的会话表膨胀——3.3 节与 8.2 节。
- 呈现段:名称解析拖慢滚动、列配置不当掩盖关键信息、着色规则过期失效——3.4 节。
💡 带着流水线看问题,很多"玄学"变成常识。例如"为什么显示过滤器比捕获过滤慢"——因为捕获过滤在帧进文件前用字节匹配就能裁决,显示过滤要等整棵字段树长完;"为什么改了列以后列表变快"——因为列减少意味着每帧的取数与渲染变少。机理清楚,调优就不靠背口诀。
用一遍流水线解释三个日常现象
机理地图铺开后,拿三个日常现象练一遍"流水线思维"。
**现象一:同一文件,两台机器打开速度差数倍。**流水线视角:差异大概率不在采集段(文件一样),而在呈现段——一台开着名称解析与十几列,一台是精简配置。3.4 节的三慢源就是这条差异的清单。处理:对照两台的面板配置,逐项对齐再比。
**现象二:过滤器 http 在一个文件里命中千帧,另一个文件零命中。**流水线视角:显示过滤作用于字段树——零命中说明解析段根本没长出 http 层。两种可能:流量真是 HTTPS(该用 tls 过滤);或 HTTP 跑在非标准端口、端口表没指对(3.3 的误诊场景,decode as 改判)。验证一行命令:
$ tshark -r odd.pcapng -Y "tcp.port==8080" -T fields -e frame.protocols | sort | uniq -c 1841 eth:ethertype:ip:tcp <- 只到 TCP:端口 8080 上没挂 HTTP 解析器
frame.protocols 显示止步于 tcp——分派链在这里断了,改判即可继续。
**现象三:Follow Stream 拼出的内容里夹杂乱码。**流水线视角:流重组(3.3 的会话状态)按序号拼字节,"乱码"通常是二进制载荷(压缩、图片、协议缓冲)进了流——重组忠实拼字节,不负责解释字节。要看纯文本对话,导出后按内容类型分开处理才是正解。
三个现象一个结论:流水线是排障的因果骨架——现象在呈现,原因常在采集或解析,沿着三段工序走,问题自己会归位。
常见疑问
**问:为什么有时候打开文件会提示"两遍解析"?**3.3 节讲过解析刀有状态:第一遍攒会话账本,第二遍用完整状态重新解剖,重传标记这类前后依赖的结论才齐。提示出现就接受它——多一遍解析换的是判定准确性。
**问:tshark 和 GUI 到底该常用哪个?**探索用 GUI(详情树、联动、着色是发现工具),重复用 tshark(脚本、批量、值守是生产工具)。第 5 章与第 7 章分别给了两边的完整姿势——选边站是没必要的,它们是同一台解剖台的两个操作面。
**问:流水线认知能直接换来什么技能?**最直接的三条:排修过滤器的底气(知道它在哪一段求值)、性能问题的第一反应(知道哪段最贵)、解析异常的排查方向(知道分派在哪断的)。这三条覆盖了日常使用中七八成的"玄学时刻",把"不知道为什么"变成"知道去哪看"。
**问:流水线里的"帧信息结构"我能直接操作吗?**能——它的字段就是 frame 点:frame.number、frame.time_relative、frame.len、frame.protocols。导出与过滤都直接可用(本章的会话示例已经用过)。把它理解成"每帧的档案袋"即可,无需深究内部实现。
**问:三段工序里哪段最容易成为瓶颈?**绝大多数场景是呈现段(渲染与名称解析),其次是解析段(文件巨大时),采集段反而最少出问题——前提是 2.1 节的配置正确。这个排序决定了调优的先后:先关呈现段三开关,再考虑分片与预筛。
结案要点
- 三段工序:采集(有没有、全不全)、解析(被理解成什么)、呈现(多快到达眼睛)。
- 帧信息结构是档案袋:
frame.protocols一列即可分诊协议路径,cap_len小于len即截尾。 - GUI 与 tshark 同引擎异呈现:字段名、性能特性、过滤器语义完全互通。
- 显示过滤器插在解析段之后:这解释它的表达力,也解释它的开销。
地图在手,下一站进入采集段内部——内核环形缓冲如何接力、丢包如何自救。