3.2 捕获引擎内幕:内核缓冲、混杂与监听
3.2 捕获引擎内幕:内核缓冲、混杂与监听
3.1 节把采集段一笔带过,本节把它的机盖掀开:内核与用户态之间的接力怎么跑、环形缓冲为什么会溢出、混杂模式与监听模式差在哪。这些机理是 2.1 节"丢包自救五步"的底层解释,也是 8.2 节高码流调优的理论基础。看懂本节,你面对"采集质量"问题时就有了因果链而不是口诀。
一次接力的解剖:帧如何穿过内核
网卡收到帧后并不惊动 CPU 逐帧处理,而是用直接内存访问把帧整批写进内核预留的环形缓冲区(ring buffer);应用侧的抓包库再从环形缓冲把帧复制到自己的用户态缓冲。整条链是三级接力:
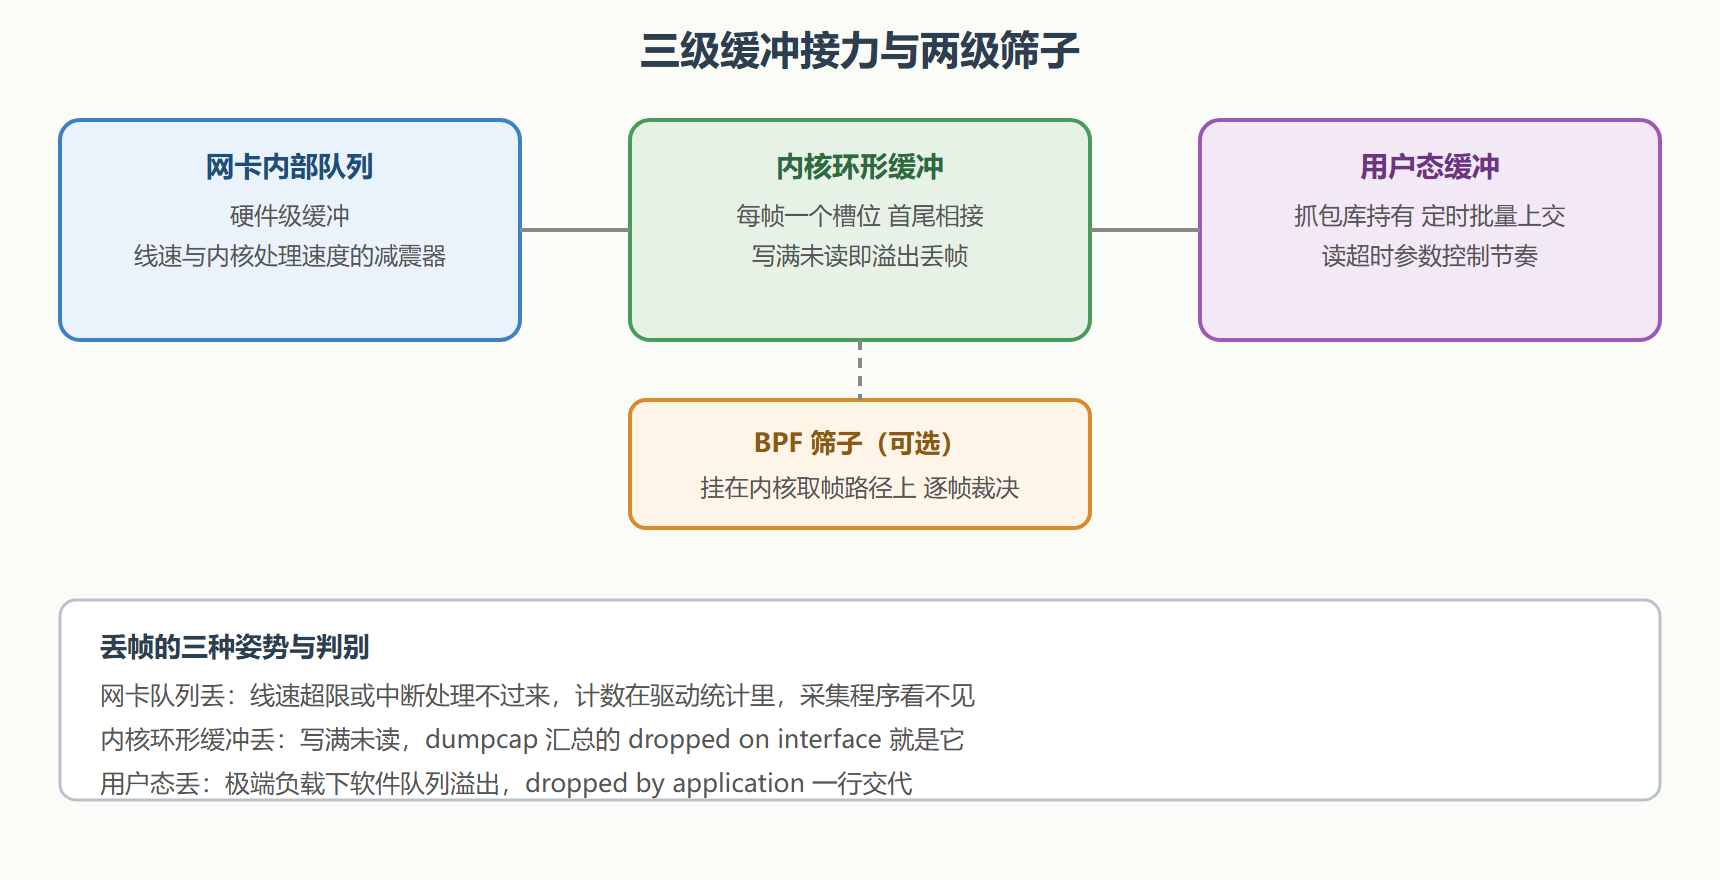
接力的每一级都可能丢:网卡队列丢在驱动统计里,内核环形缓冲丢在采集汇总里,用户态丢在应用计数里。Wireshark 状态栏的 "Dropped by kernel / by application" 分别对应后两级。看懂分级,"丢包自查"就从玄学变成查账。
Linux 上可以直接查看与调整网卡的环形缓冲参数:
$ ethtool -g eth0 Ring parameters for eth0: Pre-set maximums: RX: 4096 Current hardware settings: RX: 256 # 把接收环形缓冲调到上限,缓解突发丢帧 $ sudo ethtool -G eth0 rx 4096
当前值 256 远低于上限 4096——这是很多发行版的默认状态,突发流量下就是丢帧的第一嫌疑人。
读超时与批处理:为什么时间戳不等于到达时刻
用户态取帧有个"读超时"参数(Wireshark 捕获选项里的 buffer timeout,毫秒级):攒批可以提高效率,但攒得越久,帧从到达到被取走的延迟越大。注意这影响的是"取帧延迟",时间戳本身由内核在帧到达时刻打上,精度基本不受影响。真正的精度差异来自时钟源:老格式 pcap 固定微秒,pcapng 可以声明纳秒(2.2 节的 IDB 选项)。排障里毫秒级的结论用默认精度足够;只有高频交易类场景才需要计较微秒以下的抖动。
混杂模式与监听模式:一字之差,两个世界
两者都常被翻译成"监听",实际是不同的开关:
- **混杂模式(promiscuous)**作用于有线网卡:接受"到达本机但不发给自己"的帧。典型场景是接在镜像口上——交换机把别人的帧复制过来,混杂模式负责不挑食。
- **监听模式(monitor)**作用于无线网卡:脱离与热点的关联,直接收听空口无线电,连 802.11 管理帧、重传前的原始帧都能看到。无线勘验(比如分析漫游掉线)必须用它。
# 无线网卡切入监听模式(Linux) $ sudo iw dev wlan0 set monitor none $ sudo ip link set wlan0 up # 确认:tcpdump 列表里接口名后出现 monitor 标记 $ sudo tcpdump -L wlan0
切换后连接会断(这是特性不是故障),用完记得切回托管模式。Windows 上监听模式依赖驱动支持,Npcap 部分网卡可用,实战中无线上位机勘验更常用 Linux。
内核旁路:当环形缓冲也不够快时
极端线速场景(整条万兆链路全抓)下,三级接力本身就是瓶颈,业界的答案是把解析路径搬进内核:扩展伯克利包过滤器(eBPF)程序在内核里直接聚合统计,只有摘要出内核;或者专用采集卡硬件时间戳。这类方案在第 9 章的可观测性趋势里还会出现——对多数读者,记住边界即可:千兆以下的常规排障,调好环形缓冲与筛子就到顶了,别过早引入旁路方案。
给自己划一条判断线:当且仅当"丢包率在调优后仍影响结论"时,才考虑旁路。常规运维里这个阈值很难触发——多数"必须全量"的执念,在算清"真正相关的流量占比"后会自行瓦解。真正的少数场景(运营商级链路、交易所网络)有专门团队与预算,不在本册的射程内。
⚠️ 把"采集机"和"分析机"分开是高流量场景的黄金守则。采集机上只跑 dumpcap(不做解析、不滚动渲染),分析在别处做。GUI 一边抓一边实时解析几十万帧,是"采集质量"事故里最常见的人祸。
排查实录:一次"内核丢包"的完整自救
把机理落成一次完整排查。案情:千兆镜像口采集,状态栏出现 "Dropped by kernel: 1287" 且数字持续增长。
# 第 1 步:确认丢的哪一级(应用级还是内核级) # GUI 状态栏两行计数:dropped by kernel / dropped from buffer # 本例是 kernel 级 → 内核环形缓冲溢出,进入第 2 步 # 第 2 步:看网卡侧有没有一起丢 $ ethtool -S eth0 | grep -E "rx_missed|rx_dropped|rx_no_buffer" rx_missed: 40213 <- 网卡队列也在丢!问题在更上游 rx_dropped: 0 rx_no_buffer: 0 # 第 3 步:先解网卡队列(免费的优化先做) $ sudo ethtool -G eth0 rx 4096 # 从默认 256 调到硬件上限 $ ethtool -S eth0 | grep rx_missed rx_missed: 40218 <- 增速骤降:每秒新增从千级降到个位 # 第 4 步:镜像口流量确实超预期,下筛子减量 # 本案只用抓两个网段,BPF 直接写网段 $ sudo dumpcap -i eth0 -f "net 10.0.3.0/24 or net 10.0.8.0/24" \ -b filesize:262144 -b files:8 -w mirror.pcapng Packets: 2881412, Dropped: 0 <- 两级丢包归零,采集质量达标
四步的顺序是关键:先定位丢在哪一级(决定改哪里),再做免费优化(队列参数),最后才动刀减量(筛子)。顺序颠倒的典型事故是"一上来就加捕获过滤",结果把需要看的流量也筛没了。
常见疑问
**问:为什么 GUI 抓着抓着就卡,dumpcap 就不会?**GUI 一边采集一边解析渲染,解析段抢占了取帧节奏(3.1 节流水线的资源竞争);dumpcap 只采集不解析,把帧搬出内核后立刻回去取下一批。这就是 2.1 节"采集与分析分离"的机理版答案。
**问:时间戳精度到底够不够用?**看案型:排障的毫秒级结论、微秒级抖动观察,默认精度都够;金融高频场景才需要计较纳秒与内核时钟源(pcapng 的分辨率选项,2.2 节)。多数人焦虑精度,其实该焦虑的是丢包。
**问:怎么确认"卡顿是采集端造成的"?**对表法:同一故障在两处采集(一处在故障路径上、一处不在),两份文件的时间戳与丢包统计对比——采集端问题只出现在其中一份。这个"双点位对表"的思路也是 2.2 节跨点位合并的前提,一条技巧两处使用。
**问:缓冲调到最大就一定更好吗?**不一定——缓冲越大,突发耐受越强,但取帧延迟与内存占用也随之上升;极端情况下"深缓冲"会把你关心的毫秒级毛刺平滑掉(帧都攒在缓冲里)。常规排障用默认加一档(两倍到四倍)即可,别无脑拉满。
结案要点
- 三级接力:网卡队列、内核环形缓冲、用户态缓冲,每级都有自己的丢帧计数位置。
- ethtool -g 查环形缓冲:默认 256 对突发流量是隐患,调到硬件上限是零成本优化。
- 时间戳打在内核到达时刻:攒批影响延迟不影响时间戳;精度看格式与内核时钟源。
- 混杂管有线、监听管无线:一个收"发给别人但到达本机"的帧,一个收听整个空口。
- 采集与分析分离:高流量下这是采集质量的第一保证。
采集段的机盖装回去,下一节进入全书的技术枢纽——解析器如何把字节长成字段树。