4.3 双重机器学习与现代估计
4.3 双重机器学习与现代估计
本节摘要:双重机器学习(DML)用 Neyman 正交矩条件与交叉拟合两件武器,让倾向得分和结果模型都可以交给高容量机器学习器,同时保持 √n 收敛与有效置信区间。本节讲清朴素"先预测后回归"的正则化偏倚从何而来、正交化如何消除一阶偏倚、交叉拟合如何切断过拟合回路,并给出 AIPW 的公式与概念实现。
朴素做法坏在哪
高维协变量下自然想法:用任意 ML 模型估倾向得分 m̂(Z)=E[Y|X,Z],或者估结果表面再插值。问题出在正则化与模型选择的代价。任何 ML 估计器为了控制方差都要收缩(L1、早停、树剪枝),收缩留下的近似偏倚以快于 1/√n 的速度进入第二阶段,最终效应估计的偏差不再被抽样噪声淹没——置信区间覆盖真实值的比例严重失真。这个现象叫正则化偏倚或"植入偏倚",样本越大反而越明显,因为抽样噪声降下去了,系统性偏差浮上来。
第二个坑是自家数据过拟合:用同一样本训练干扰参数估计器( nuisance,指那些不关心但必须控制的量)又代入构造效应估计,残差里残留着对自身噪声的拟合,导致推断失效。
两件武器:正交与交叉拟合
Neyman 正交。把效应估计写成一个矩条件,使它对干扰参数的估计误差不敏感到一阶。以部分线性模型 Y = τ·X + g(Z) + U、X = f(Z) + V 为例(g、f 是高维干扰函数),构造正交化的矩条件:
ψ(Y, X, Z; τ, g, f) = (Y − g(Z) − τ·X) · (X − f(Z))
关键是残差对残差:Y 的残差(去掉 Z 对 Y 的解释)乘 X 的残差(去掉 Z 对 X 的解释),对 τ 求期望为零的方程对 g、f 的小误差只产生二阶影响——一阶偏倚被正交化消掉了。这就是 FWL 定理(回归中"先各自去除协变量再互相回归")的因果推断版,配上机器学习估计 g、f 后仍然保持推断性质。
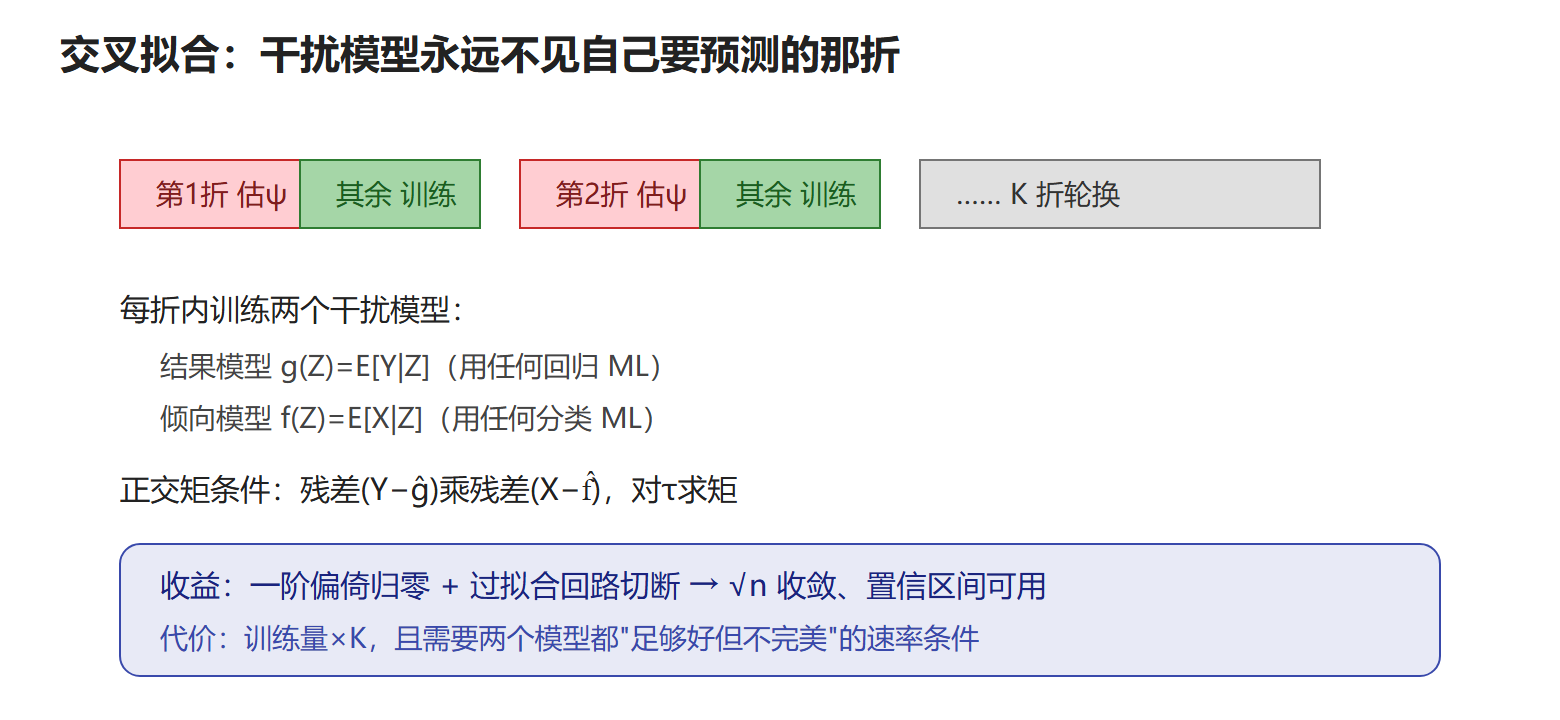
交叉拟合。把样本分 K 折(常用 5),对每一折:用其余 K−1 折训练 ĝ、f̂,再在这一折上代入构造 ψ。这切断了"用自己的噪声估计自己"的回路。两件武器合起来,DML 估计器达到 √n 一致且渐近正态,置信区间照常构造。Chernozhukov 等人 2018 年的系统化论文给出了一般框架。
图:DML 交叉拟合流程
AIPW:双重稳健的增广估计器
DML 家族里实践首选是增广逆概率加权(AIPW,又称双重稳健估计器):
τ̂_AIPW = (1/n) Σ [ m̂₁(Zᵢ) + Xᵢ(Yᵢ−m̂₁(Zᵢ))/ê(Zᵢ) − m̂₀(Zᵢ) − (1−Xᵢ)(Yᵢ−m̂₀(Zᵢ))/(1−ê(Zᵢ)) ]
其中 m̂₁、m̂₀ 是两组的结果回归。它的"双重稳健"性质:倾向模型或结果模型任一个正确设定(另一个错),估计仍一致;两个都错才偏。在交叉拟合与速率条件下,AIPW 还达到半参数有效界——同假设下方差最小。概念实现:
# 概念流程:AIPW + 交叉拟合(示意) from sklearn.model_selection import cross_val_predict from sklearn.ensemble import GradientBoostingRegressor, GradientBoostingClassifier # 交叉拟合预测:模型从不预测自己的训练折 g1 = cross_val_predict(GradientBoostingRegressor(), Z[X==1], Y[X==1], cv=5) # 同理对全样本预测 m1(Z), m0(Z) 与 e(Z)(此处省略两处重复调用) psi = m1 - m0 + X*(Y-m1)/e - (1-X)*(Y-m0)/(1-e) # 逐项对齐样本后求均值 tau = psi.mean(); se = psi.std(ddof=1)/np.sqrt(n)
⚠️ 即便双重稳健,e 的极端值仍会让方差炸裂(权重 1/ê 项)。_overlap 权重、修剪 ê 到 [0.01, 0.99]、或改用 targeted maximum likelihood(TMLE,另一种双稳健框架,用 clever covariate 做一步靶向更新)是三条常用止血带。
CATE 视角:效应异质性的入口
DML 还提供了一条估计条件效应 τ(Z) 的便捷通道:先用上述流程得到每个个体的正交化残差乘积项,再把它作为"伪结果"对 Z 回归(因果森林、BART、梯度提升都行)。这就是"两阶段:去偏→学异质"的标准范式,EconML 的 DML 与 CausalForestDML 都建立在它上面。细节留到第 5.1 节,此处只需知道:DML 的正交项不只能估平均,也是异质性估计的原材料。
FAQ 与实现要点
问题:DML 里干扰模型用多少容量合适?
理论要求"足够好但不完美":预测误差以快于 n^(-1/4) 的速率收敛即可,随机森林、梯度提升、适度正则的网络都在此列。实践中更重要的旋钮是折数与随机性:折数 5 足够;每次报告最好用不同随机种子重复几遍,估计值跳动大说明干扰模型不稳定,结论要打折。
问题:AIPW、TML、DML 三者什么关系?
三者都属"双稳健"家族。AIPW 用逆概率项增广结果回归;TMLE 在同样构件上做一步靶向更新(对稀有结局与小样本更稳);DML 是用任意 ML 构件 + 交叉拟合实现上述估计的一般框架。选型经验:罕见结局用 TMLE(IPW 型估计在稀疏格子里方差爆炸),常规表格数据 AIPW/DoubleML 顺手,高维特征 DML 默认。
干扰模型容错的直观演示
正交化的收益可以用一个退化实验感受:当干扰函数 g(Z) 是强非线性而结果模型只用线性拟合时,朴素两阶段估计的偏差不会随样本缩小;同样设定下,把残差化后的正交矩作为估计目标,偏差立即以 √n 速率收敛到零。两者差的不是拟合能力——哪怕把 g 换成完美模型,朴素法对倾向侧的误差仍敏感;差的是"估计目标对干扰误差的导数"是否为零。这个导数视角也解释了为什么 AIPW 叫"增广":它在 IPW 上加的那一项,恰好把 IPW 对结果模型误差的一阶导数抵消掉。
本节要点回顾
- 朴素两阶段的病:正则化偏倚(快于 √n)+ 自拟合过拟合,置信区间失真。
- 正交化:残差乘残差的矩条件把干扰误差的影响压到二阶,FWL 的因果版。
- 交叉拟合:K 折隔离训练与代入,切断过拟合回路;两者合得 √n 收敛。
- AIPW:双稳健(任一模型对即一致),交叉拟合下半参数有效;防极端权重三条路。
- 下一节:当处理由"规则门槛"决定时,断点回归提供另一种局部识别。