4.4 断点回归:规则门槛处的因果识别
4.4 断点回归:规则门槛处的因果识别
本节摘要:断点回归(RDD)利用"处理由评分是否越过门槛决定"的规则:门槛两侧紧邻的个体在可交换性上近似随机,比较两侧结果即可识别局部因果效应。本节讲清两种设计(精确与模糊断点)、连续性假设、局部线性估计与带宽选择、McCrary 密度检验与协变量平滑性检验。
规则制造的"自然随机化"
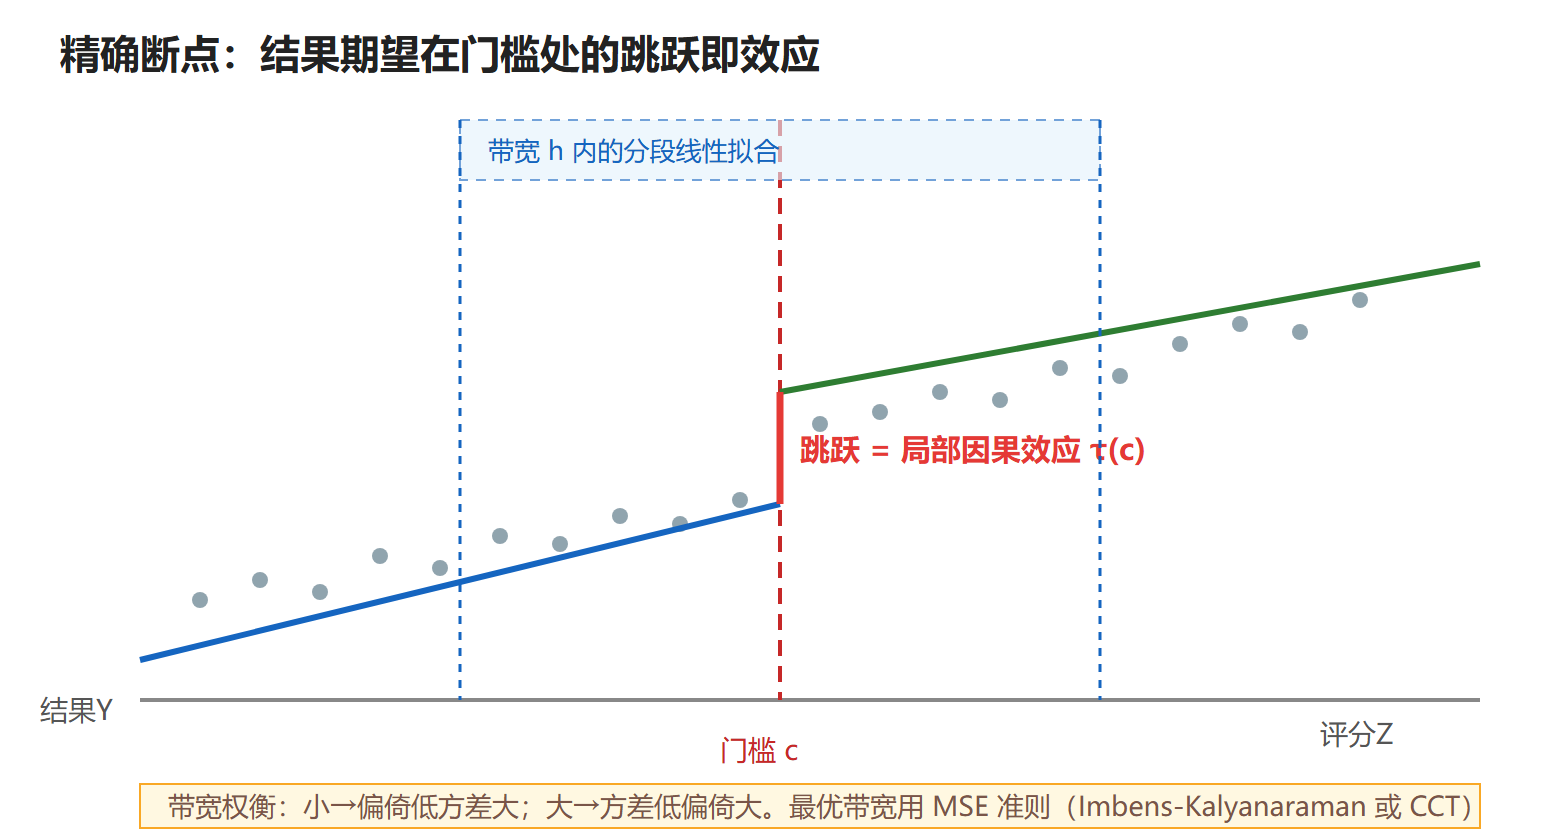
大量制度按分数划线:考试过线才录取、年龄满 18 岁才可购买、污染指数超阈值才限行、销售额达门槛才返点。划线规则有个因果推断视角的美妙性质:分数恰好 59.9 与恰好 60.1 的两个人,在一切未测特征上几乎无差别——毕竟没人能把自己精确控制在总分小数点后一位。门槛两侧的"硬币"由评分的微小随机波动抛出。这就是精确断点回归(SRD):处理 X = 1{评分 Z ≥ 门槛 c},识别量是门槛处的局部平均处理效应:
τ(c) = E[Y | Z=c⁺] − E[Y | Z=c⁻]
即结果关于评分的条件期望在门槛处的左右跳跃量。
**模糊断点(FRD)**处理"过线只是提高概率"的情形:过线者不一定都接受处理(如推荐信过线后部分人仍放弃手术)。此时门槛是处理的工具变量(第 4.5 节的 IV 语言),效应由"结果的跳跃"除以"处理概率的跳跃"估出:τ_FRD = [E(Y|c⁺)−E(Y|c⁻)] / [E(X|c⁺)−E(X|c⁻)]。这个比值形式被称为wald 估计量,模糊断点是最早也最干净的工具变量场景之一。
图:断点回归的局部线性估计
核心假设与三类诊断
连续性假设:E[Y(0)|Z] 与 E[Y(1)|Z] 在门槛处连续——所有其他因素都平滑穿过门槛,只有处理在跳跃。它无法直接检验,但有两个代理检验构成 RDD 的可信度地基:
诊断一:评分密度连续性(McCrary 检验)。 若个体能精确操控自己的评分(复读生把自己卡在及格线上方一分),门槛左侧会异常稀疏。画出评分的直方图并检验密度在门槛处无跳跃,等价于检查"没有人精准落点"。
诊断二:协变量平滑性。 前测协变量(性别、基线收入、过往成绩)的条件期望应在门槛两侧无跳跃。若某个前测变量也"跳",说明跳跃的不是一个处理而是整个人群结构,识别告吹。
诊断三(设计层面):不许有其他政策在同门槛生效。 多重断点(不同地区门槛不同)时可以分别估计再汇总,但两个政策叠在同一门槛上则效应无法分离。
估计与带宽
主流做法是门槛两侧分别拟合局部线性(一阶)回归,跳跃量即效应。多项式全局拟合已被反复证明危险(高阶多项式在边界产生伪跳跃,Runge 现象),除非有明确理由,阶数不超过二。带宽 h 的选择决定偏倚—方差交换:经验法则与自动选择器(CCT、IK)给出 MSE 最优带宽,且推断时用鲁棒偏倚修正标准误。敏感性分析的标配是画效应随带宽变化的曲线,看结论是否稳。
一个数值化的直觉:设门槛两侧各 0.5 分范围内有 800 人,结果变量标准差 10,真实效应 2。局部线性估计的标准误大约在 10·√(1/400+1/400)≈0.7 上下——效应 2 能被稳定识别。但若真实效应只有 0.5,同样样本就力不从心。RDD 估的是门槛处的局部效应,外推到远离门槛的人群需要额外的同质性论证,这是它相对全样本方法的范围代价。
概念实现
# 概念流程:SRD 局部线性估计(示意) import numpy as np Z, Y = score, outcome # 评分与结果 c, h = 60.0, 5.0 # 门槛与带宽 mask = np.abs(Z - c) <= h d = (Z >= c).astype(int) # 门槛右侧即处理 # 交互回归:Y ~ 1 + Zc + d + Zc*d,Zc = Z - c(中心化避免共线) Zc = Z[mask] - c; dm = d[mask]; Ym = Y[mask] X = np.column_stack([np.ones(mask.sum()), Zc, dm, Zc*dm]) beta, *_ = np.linalg.lstsq(X, Ym, rcond=None) print("效应估计 =", round(beta[2], 3)) # dm 的系数即门槛处跳跃
模糊断点把 d 当工具:第一阶段回归 d 对 Zc(跳跃 beta2 除以处理跳跃),两阶段合并即 Wald 比值。
FAQ 与自检清单
问题:怎么判断该用精确还是模糊断点?
看越过门槛后处理概率的跳跃。全有全无(过线必处理)是精确;概率从 30% 跳到 70% 是模糊。诊断图:处理率对评分的局部线性图,门槛两侧的跳跃即第一阶段。模糊断点别忘了第一阶段跳跃除尽(它就是 IV 的第一阶段,同样要做强度检查)。
问题:RDD 结果会受"局部性"多大限制?
它估的是门槛附近人群的 LATE。若决策关心远端人群(比如录取线附近效应小、但高分段效应大),需要论证效应函数的平滑外推或补多点断点(不同省份不同线)拼出整条剂量反应。报告里写清"效应属于谁"是 RDD 论文的职业道德。
问题:审稿人最常要的三张图?
评分密度图(McCrary)、协变量平滑图(前测变量逐一画断点)、带宽敏感性曲线(效应随带宽的稳定带)。三张齐了,设计的可信度就立起来了大半。
模糊断点的数值示例
接正文 FRD 公式给一组数:过线后接受处理的概率从 0.45 跳到 0.85(第一阶段跳跃 0.40);结果发生率从 22% 跳到 30%(结果跳跃 8 个点)。FRD 效应 = 0.08 / 0.40 = 0.20——对"因过线而真的改变了处理状态的人"(compliers,占过线者的八成半)效应 20 个点。注意它既不是"全人群效应"也不是"处理组效应",解释时必须带上 compliers 定语。第一阶段跳跃 0.40 相当强(类比 IV 的 F 检验),若跳跃只有 0.05,同样的结果跳跃会给出荒谬的 1.6 效应——模糊断点的第一段永远先于第二段检查。
本节要点回顾
- 识别逻辑:规则门槛两侧的个体近似可交换,结果期望的跳跃即局部效应;模糊断点 = 门槛作工具变量的 Wald 比值。
- 连续性假设:不可直接检验,靠评分密度(McCrary)与前测协变量平滑性两个代理诊断支撑。
- 估计纪律:局部线性 + 最优带宽 + 偏倚修正标准误;拒绝高阶全局多项式。
- 范围限定:只估门槛处的 LATE,外推需另行论证。
- 下一节:门槛之外找外生变动源的通用工具——工具变量。