3.3 SSA 的构造算法
3.3 SSA 的构造算法
本节摘要:构造 SSA 只需回答两个问题:phi 插在哪些块(置放),每个 phi 的参数叫什么名字(重命名)。置放由支配边界(Dominance Frontier)精确刻画:变量 x 的定义点 d 的支配边界,就是"必须为 x 摆一个 phi"的候选块集合。本节先定义支配与支配边界,再给出 Cytron 两遍算法的完整流程,配合一个 5 块 CFG 手算一遍,最后讨论最小 SSA、剪枝 SSA 在置放阶段的取舍。读完你应当能在纸面上对任意小规模 CFG 构造出正确的 SSA。
3.2 讲清了 phi 的语义,本节解决"phi 长在哪"。把插多了(浪费)与插少了(分析失真)都排除掉的钥匙,是控制流图上"谁支配谁"这个纯结构性概念——它不涉及任何变量的值,只看路径。
一、支配关系:先于任何数据的结构事实
若从入口走到块 y 的每一条路径都必经块 d,就称 d 支配 y(记作 d dom y)。每个块支配自己;若 d 支配 y 且 d 不等于 y,称严格支配。把"最近"的支配者挑出来:y 的直接支配者 idom(y) 是严格支配 y 的块中离 y 最近的一个。所有 idom 边连起来,得到一棵以入口为根的支配树——树上 y 的全部祖先恰好是 y 的全部支配者。
支配关系有个比直觉更快的算法事实:支配树可以近线性时间构造(Lengauer-Tarjan 的 union-find 实现或 Cooper/Harvey/Kennedy 的迭代法),这是 SSA 构造整体近乎线性复杂度的底气。第4章还会回到支配树,那里用它识别循环;这里只需要"支配树把支配关系变成 O(1) 查询"这一条。
有了支配还不够,phi 的位置由支配边界刻画。块 n 的支配边界定义为:
DF(n) = { y | 存在 y 的前驱 p:n 支配 p,且 n 不严格支配 y }
用话讲:y 是"我管得住我的来路、却管不住它自己"的块——控制流从 p 跨进 y 的那一刻,摆脱了 n 的管辖。凡是变量在 n 处有定义、控制流又可能绕开 n 汇合的地方,就该有一个 phi。
二、置放:迭代支配边界算法
Cytron 算法的第一遍是置放。对每个有定义的变量 x,把其所有定义点放进工作表,反复做"把 phi 放进定义点的支配边界,phi 本身也是新定义"的迭代:
输入: CFG, 每个变量的定义点集 Defs for 每个变量 x: W = Defs(x) # 工作表:已知定义点 placed = {} # 已插入 phi 的块 while W 非空: 取出 n for y in DF(n): if y 不在 placed: 在 y 入口插入 x 的 phi placed += y if y 不在 Defs(x): # phi 也是定义 W += y # 继续向外传播
两点关键。其一,phi 插入后它自己成了新定义点,要继续向它的支配边界传播——这一步保证嵌套汇合不会漏摆。其二,这只摆"必要的"位置:minSSA(最小 SSA)到此为止,对"某条路径上根本不会再使用 x"毫无察觉;剪枝 SSA(pruned SSA)会先做一次活跃变量分析(第4章),只在 x 在 y 出口仍活跃时才摆 phi。折中方案 semi-pruned 只对"跨基本块活跃"的变量置放,省掉全局活跃分析,是工程上最常用的档位。
图:支配边界手算——phi 应该落在哪里
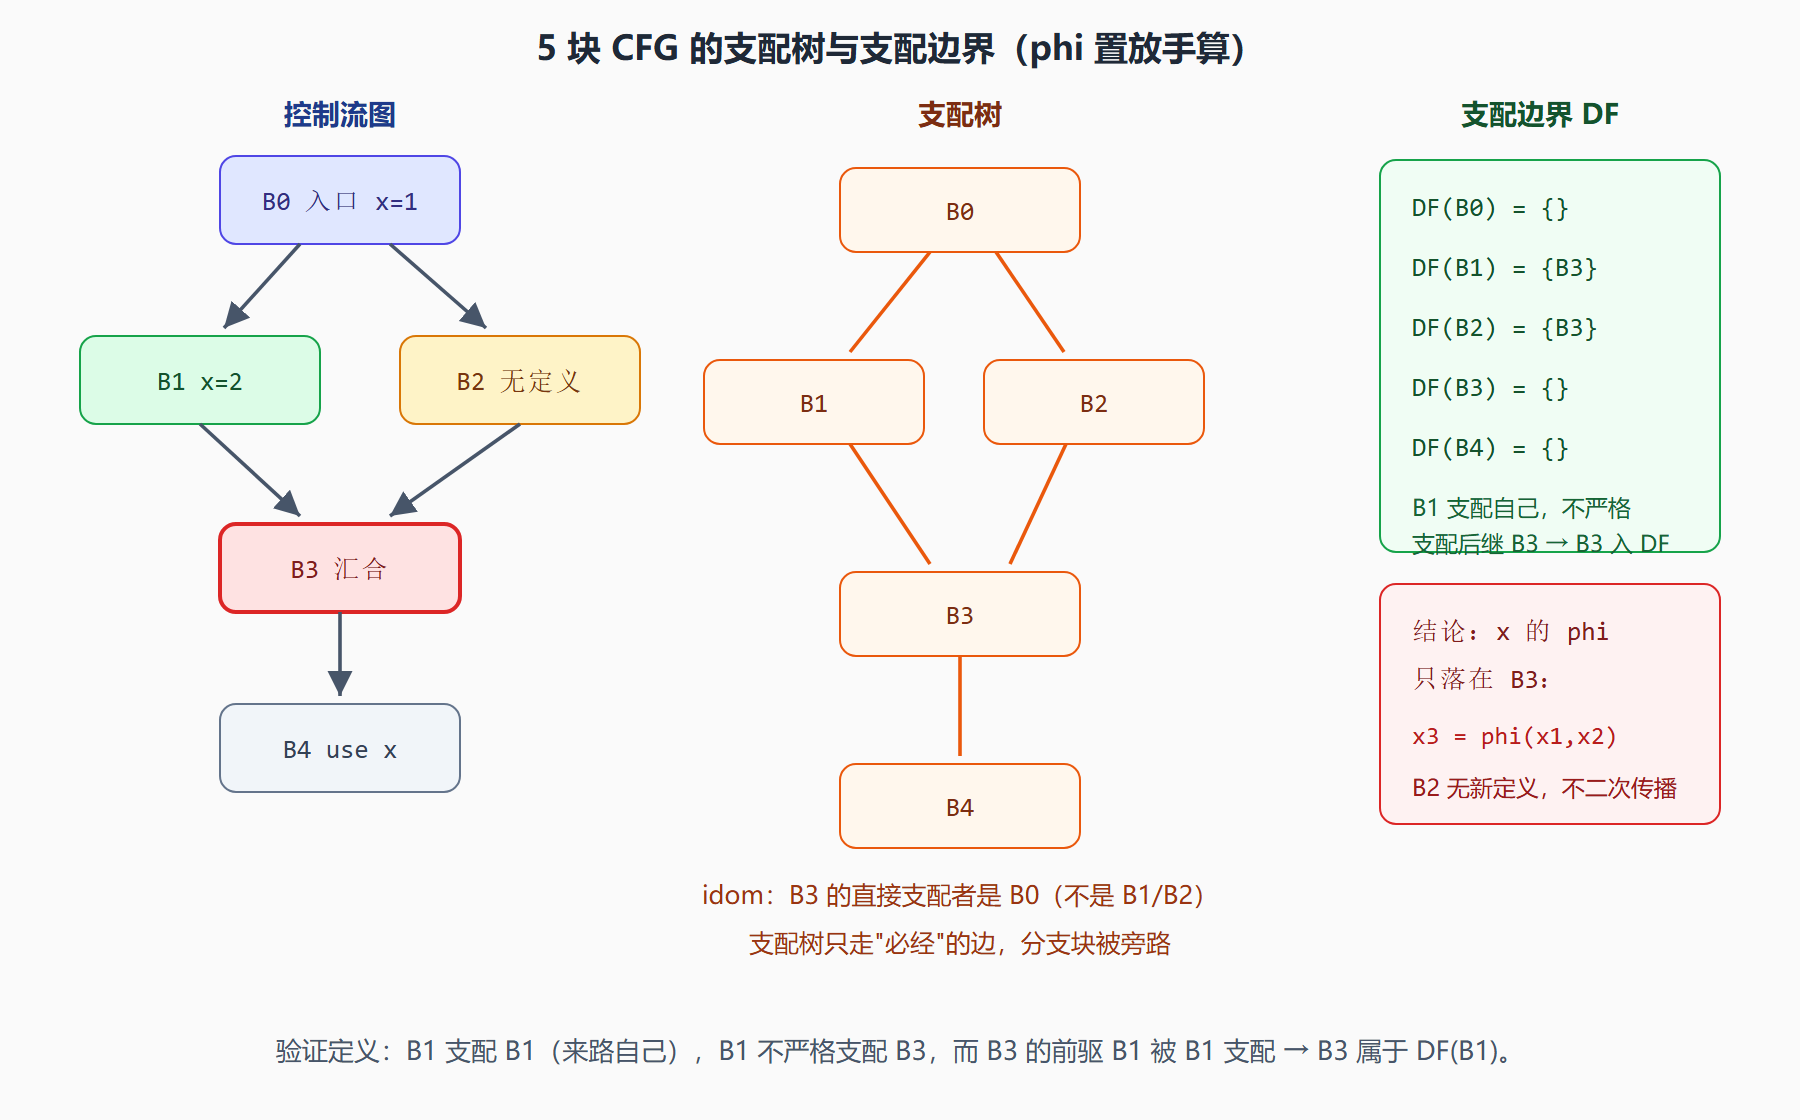
手算一遍上图:x 在 B0、B1 有定义。从 B0 出发,DF(B0) 为空——B0 支配所有块,任何汇合都逃不出它的管辖,phi 不必摆。从 B1 出发,DF(B1)={B3},摆 x = phi(x0, x2);这个 phi 是新定义,查 DF(B3) 为空,传播停止。B2 没有定义,不触发。最终恰一个 phi,与 3.2 的手写结果一致。
三、重命名:支配树上的一趟 DFS
置放完成后,每个"老名字"的 phi 已就位,第二遍把它们全部改名成带版本号的新名字。算法沿着支配树做深度优先搜索,随身带一个名字栈表:
Rename(b): for 每条指令 i in b: # phi 也是指令 for 每个被 i 使用的名字 x: x 替换为 top(x) # 用栈顶当前版本 for 每个被 i 定义的新名字 x: v = 新版本号(x) 生成 x_v;push(x, v) for 每个后继 s of b: # 补 phi 参数 b 在 s 的前驱序号 k for s 中关于 x 的每个 phi: 第 k 个参数填 top(x) for 每个子结点 c in domtree(b): Rename(c) for 本块 push 过的每个 x: pop(x) # 回溯时撤销
为什么走支配树而不是 CFG?因为"当前可见版本"的存活范围恰好是支配关系圈出的区域:从定义点出发,沿支配树能到的块一定经过定义点,版本不会看错;而 DFS 回溯时的 pop 恰好把版本变化限制在支配子树内。若沿 CFG 遍历,一个块可能被多条路径以不同栈状态访问到,就得引入合并逻辑——支配树把这个麻烦彻底消掉了。
四、工程取舍与易错点
- 置放密度与精度的三角:minSSA 免分析但含死 phi(死代码删除会清掉,但中间阶段白算);pruned 需要一次全局活跃分析;semi-pruned 用"跨块活跃"这个便宜近似,实际编译器(如 LLVM 的构造 pass)多用后者或其变体。
- 关键边问题:多前驱汇合块配多后驱分支块,直接插入会导致 phi 无处安放或参数错位——通用解法是在关键边中间劈一个空块。劈块也顺带修复了"phi 只能放块入口"的表达限制。
- 易错点:DF 表算错方向。常见错误是把"n 的后继中 n 不支配的块"算进 DF(n)。正确口径永远围绕"n 支配 p(某个前驱),但不严格支配 y"——来路受控、去向失控。
- 易错点:phi 参数按前驱次序对号。重命名补参数时按"b 是 s 的第几个前驱"填入,一旦块的次序在后续 pass 里被重排而没有同步更新 phi 参数序号,程序就悄悄错了——这是 SSA 上做块重排时最经典的 bug 来源。
本节要点回顾:
- 支配/严格支配/直接支配者:支配树把必经关系变成可快速查询的结构;
- 支配边界 DF(n):n 支配某前驱 p、但不严格支配 p 的后继 y,y 属于 DF(n);
- 置放算法:定义点沿支配边界迭代传播,phi 自身也是定义点;
- 重命名:沿支配树 DFS,栈顶即当前版本,回溯弹栈;
- 三档 SSA:min、semi-pruned、pruned,按"愿不愿意先做活跃分析"取舍。
下一节看这套标准形式在实践中长出的几个变体,以及它们各自服务谁。