6.3 运维与可见性:全局可视
6.3 运维与可见性:全局可视
设备批量上线后,运维的主战场转向"看住它"。本节是第 6 章的收口,也是全册对照主线在运营层面的对撞:单点排障对全局可视。承上:可见性平台消费的正是 3.2 节探测机制产出的体检单与 4.3 节策略命中的统计;启下:第 8 章的 AIOps 自愈,是把本节"人看数据"升级为"机器看数据"的下一站。读完本节,你应当能给可见性平台列验收清单,并复述一次故障的标准化定位流程。
排障半径的差异
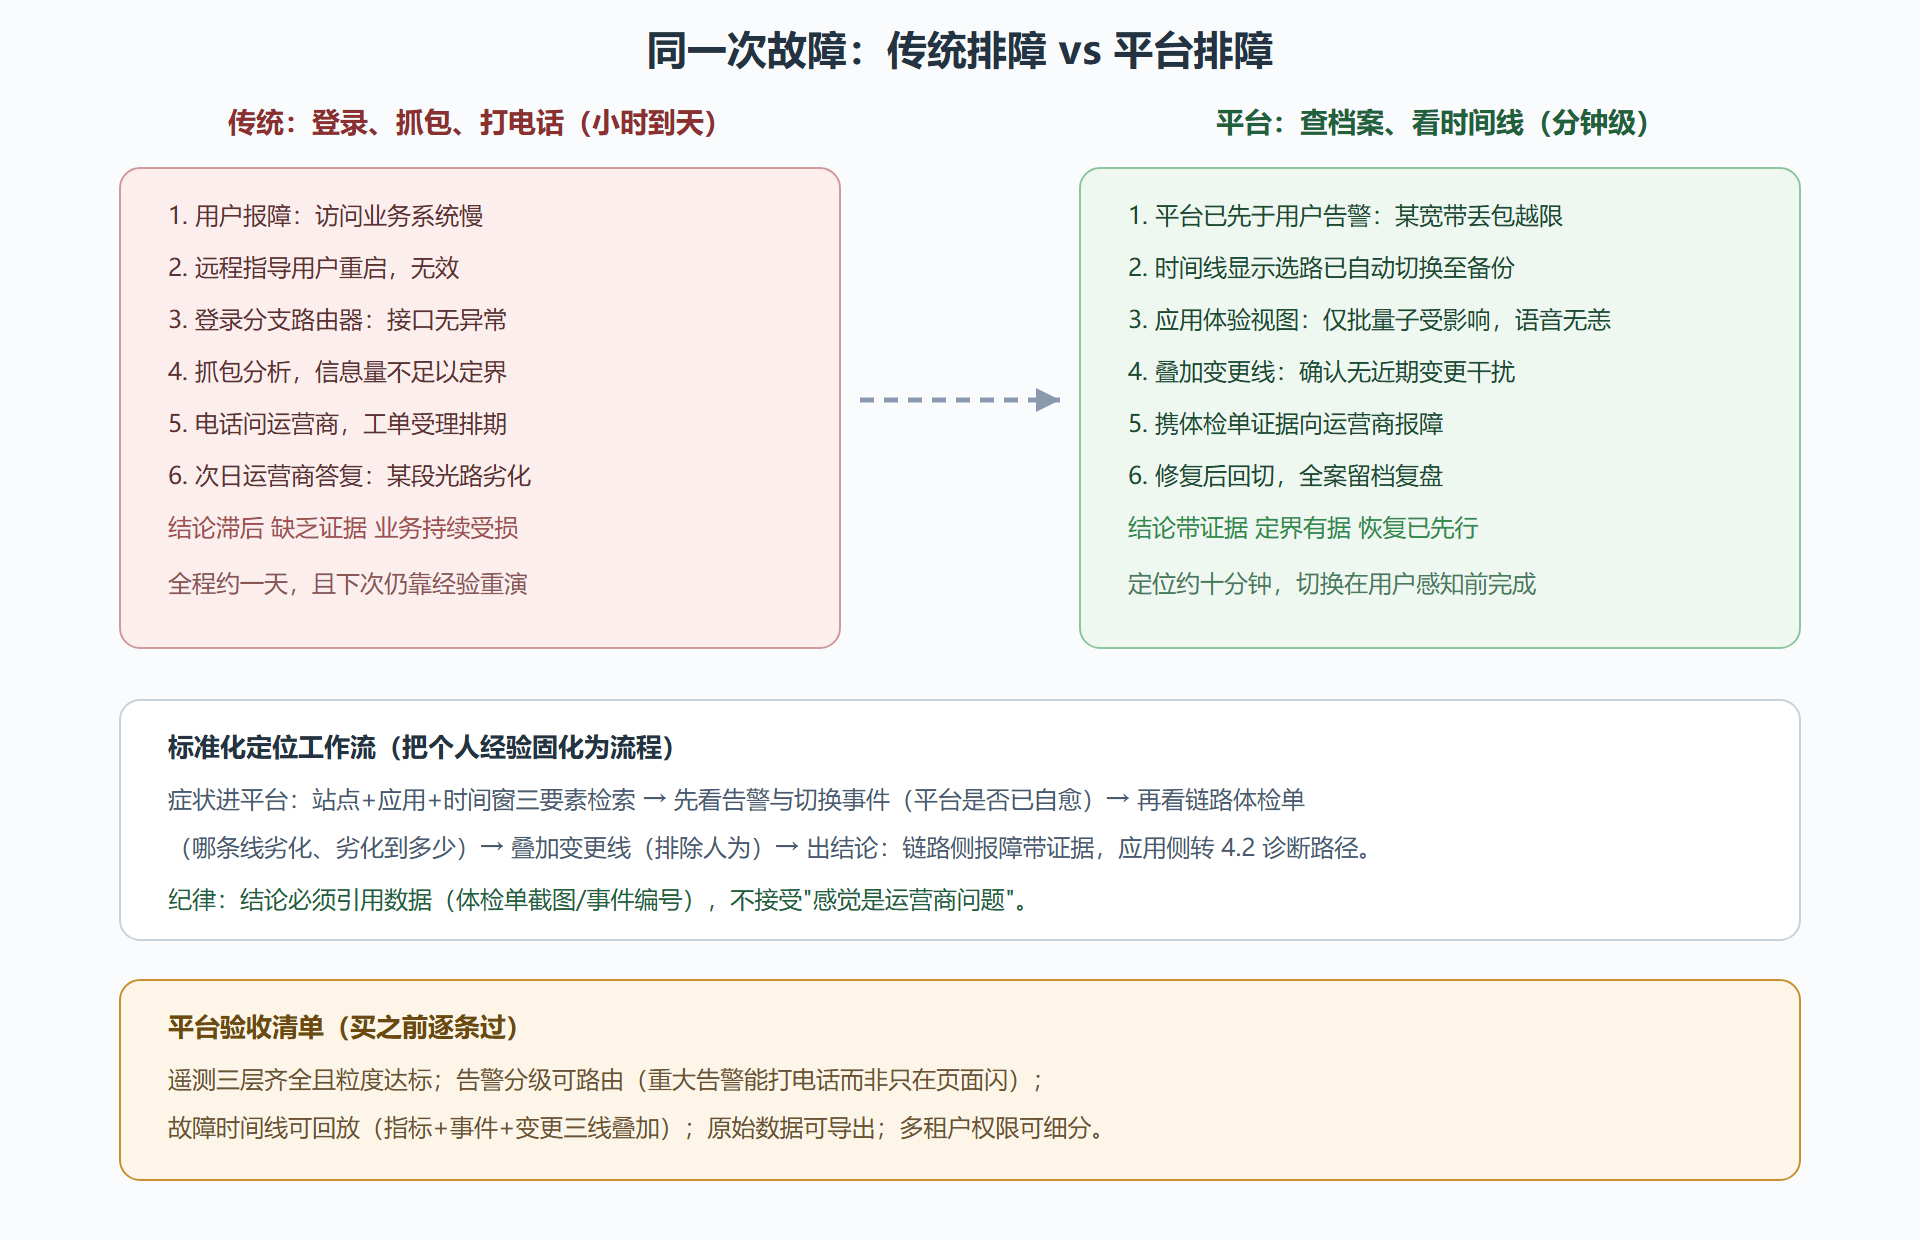
传统 WAN 排障的半径是"一台设备加一个用户":用户说慢,工程师登录分支路由器看接口、抓包、打电话问运营商,结论往往以"运营商链路问题,已报障"收尾,全程数小时甚至数天。SD-WAN 的排障半径是"一张网加一条时间线":用户说慢,平台先回答三个问题——哪个应用、哪个站点方向、哪条链路,故障那一刻的体检单与选路动作全程留痕,多数案例在分钟级完成定界。半径差异的本质不是工具更花哨,而是数据从产生那一刻就被结构化留存:链路指标带时间戳、选路决策带依据、策略命中带计数——排障变成查档案,而不是猜谜。
遥测的三层清单
平台的原料是三层遥测,验收时逐层核对:
| 遥测层 | 内容 | 典型粒度 | 排障用途 |
|---|---|---|---|
| 链路层 | 时延、抖动、丢包、带宽利用率 | 秒到分钟 | 断链与劣化定界 |
| 隧道层 | 隧道状态、切换事件、加密统计 | 事件级 | 选路是否按预期动作 |
| 应用层 | 应用识别命中、体验评分、会话统计 | 分钟级 | 用户 complaint 的对账 |
三层之外还要核两个"有没有":变更记录有没有——每次配置与策略变更的时间、执行人、影响站点,故障时间线必须能叠加变更线(大量"故障"实为变更引发);原始数据能不能导出——平台内看图只是及格,能按时间范围导出原始指标做离线分析才算好用。
图:单点排障对全局可视:同一次故障的两种经历
应用体验视图:把指标翻译成业务语言
可见性平台有一个最值得投入配置的功能:应用体验视图。它把技术指标翻译成业务方能理解的评语——不是"丢包率 0.8%",而是"视频会议体验:良好,偶有卡顿风险;跨区文件共享:偏慢,建议错峰"。配置这个视图的过程本身就是一次口径对齐:每个应用组要定义"体验差"的判定线(用哪个指标、什么阈值),而这个判定线必须与业务方共识——口头共识不算,要在平台里落成配置并让业务方确认。视图上线后有两个意外的收益:业务方的报障从"网络是不是又断了"变成"体验视图显示某某应用降级",定位沟通的成本大幅下降;管理层看月报也有了业务视角的指标,网络团队的绩效不再只用"没出事"来衡量。工具塑造沟通,沟通反过来定义工具该长什么样。
告警治理:比数据更难的是噪音
可见性平台的头号失败原因不是缺数据,是告警噪音:链路抖动、探测毛刺、模板误配都会产生告警,一周下来运维对告警脱敏,真事件被淹没。治理三招:分级——按影响面(全网/区域/单站)与类型(断链/劣化/安全)分优先级,重大告警接入电话或即时消息,其余进工单;聚合——同一根因的派生告警折叠成一条(上游光路劣化引发的下游站点告警归并);基线化——告警阈值跟随各站点的历史基线而非全局统一值(3.2 节"阈值用基线校准"的原则在告警侧同样成立)。平台上线后的第一月,建议固定做一次"告警复盘":统计告警量、误报率、平均确认时长,据此调阈值与分级。
每月十分钟的例行巡检
可见性平台除了"出事时用",还应固定一个"没事时看"的例行动作。每月十分钟的巡检清单:看趋势——全网链路质量指标的三个月趋势线,找慢性劣化(丢包基线缓爬、时延均值缓升的链路,趁没到阈值先处理);看异常清单——本月自动切换与降级事件的汇总,单站点超过三次就值得专项检查;看容量——各链路峰值利用率是否逼近限顶值,提前扩容;看配置健康——模板版本是否一致、有没有站点漂移出标准配置;看告警治理——本月告警量与误报率是否在治理目标内。十分钟的固定巡检与 8.1 节的自动化先行清单天然衔接:巡检发现的问题里,规律性的部分逐步交给规则自动化,人的注意力留给真正的例外。可见性平台的成熟用法就是这套"例行加例外"的双层结构。
从可视到自愈:留一个接口
本节的终点是"人看数据、人做决策",第 8 章的 AIOps 会把决策也自动化。衔接点在数据结构:如果平台的遥测、事件、动作记录是结构化且带因果标注的(哪个事件触发了哪个切换、结果如何),自愈系统就能直接在这份数据上训练;如果档案是散落的截图与工单,自愈就无从谈起。所以验收平台时多问一句:你们的事件记录带不带动作与结果字段——这一问的价值要到两年后才会显现。
平台选型的演示脚本
采购可见性能力时,厂商演示基本都是"一切正常的仪表盘",看不出深浅。准备一套压力演示脚本,让对方在你的场景里证明能力,四个场景足够分辨产品成色。场景一:拔链路。 在演示环境切断主链路,看告警出现速度、自动切换事件记录、恢复后的回切与全程时间线完整性。场景二:制造慢。 用限速器把某链路压到 30% 丢包,看平台能否在应用体验视图里先于用户告警,并给出方向级定位(哪条链路、哪个应用组、影响几个站点)。场景三:翻旧账。 要求回放"三天前下午的那次告警"的完整时间线(指标、事件、变更三线叠加)——考察数据留存与回放能力,这是排障档案的核心。场景四:问联动。 现场演示从"云端沙箱判定恶意"到"边缘阻断"的联动计时(5.1、5.3 节的必问项)。四个场景的表现,比任何功能清单都诚实。
问题:用了平台,值班人员要学多久?
这是被严重低估的验收项。平台的学习成本不在看图(图都差不多),在工作流迁移:过去的排障动作(登设备、看接口计数)全部作废,新的动作(查时间线、看体检单、按应用检索)需要肌肉记忆。验收时加一个测试:给一名没用过该平台的值班工程师、一份一页纸的操作卡,让他处理一个模拟告警——十分钟内能按卡定位到"哪条链路、哪个应用、影响面多大"的平台算合格。做不到的平台,功能再多也只是管理层的大屏玩具,不是值班工具。配套地,操作卡要在上线头三个月里反复修订,把每一次"值班卡住了"的地方补进去。
本节要点
- 排障半径的差异源于数据留存方式:结构化留痕让排障变成查档案,而非登录猜谜。
- 遥测三层(链路、隧道、应用)加两必备(变更记录、原始导出)构成平台验收底线。
- 标准化工作流:三要素检索、先看自愈、再查体检单、叠加变更线,结论必须引用数据。
- 告警治理三招:分级、聚合、基线化;上线首月固定做告警复盘。
- 平台数据带动作与结果字段,是未来 AIOps 自愈的前置条件,验收时就要问。
至此运维线走完:模式定了、开通自动化了、故障看得见了。下一章把这套机制搬到云端——云分支与多云互联。