2.2 DSPy 的核心组件
2.2 DSPy 的核心组件
本节摘要:给出 DSPy 组件体系的全景图:Signature(IO 契约)、Module(可组合执行单元)、Optimizer(编译器)、Metric(优化目标)与 LM/RM(模型底座),说明各组件的职责边界与协作方式。本节是全册的心智地图——先见森林,第 3 章起再逐棵看树。
核心结论先行
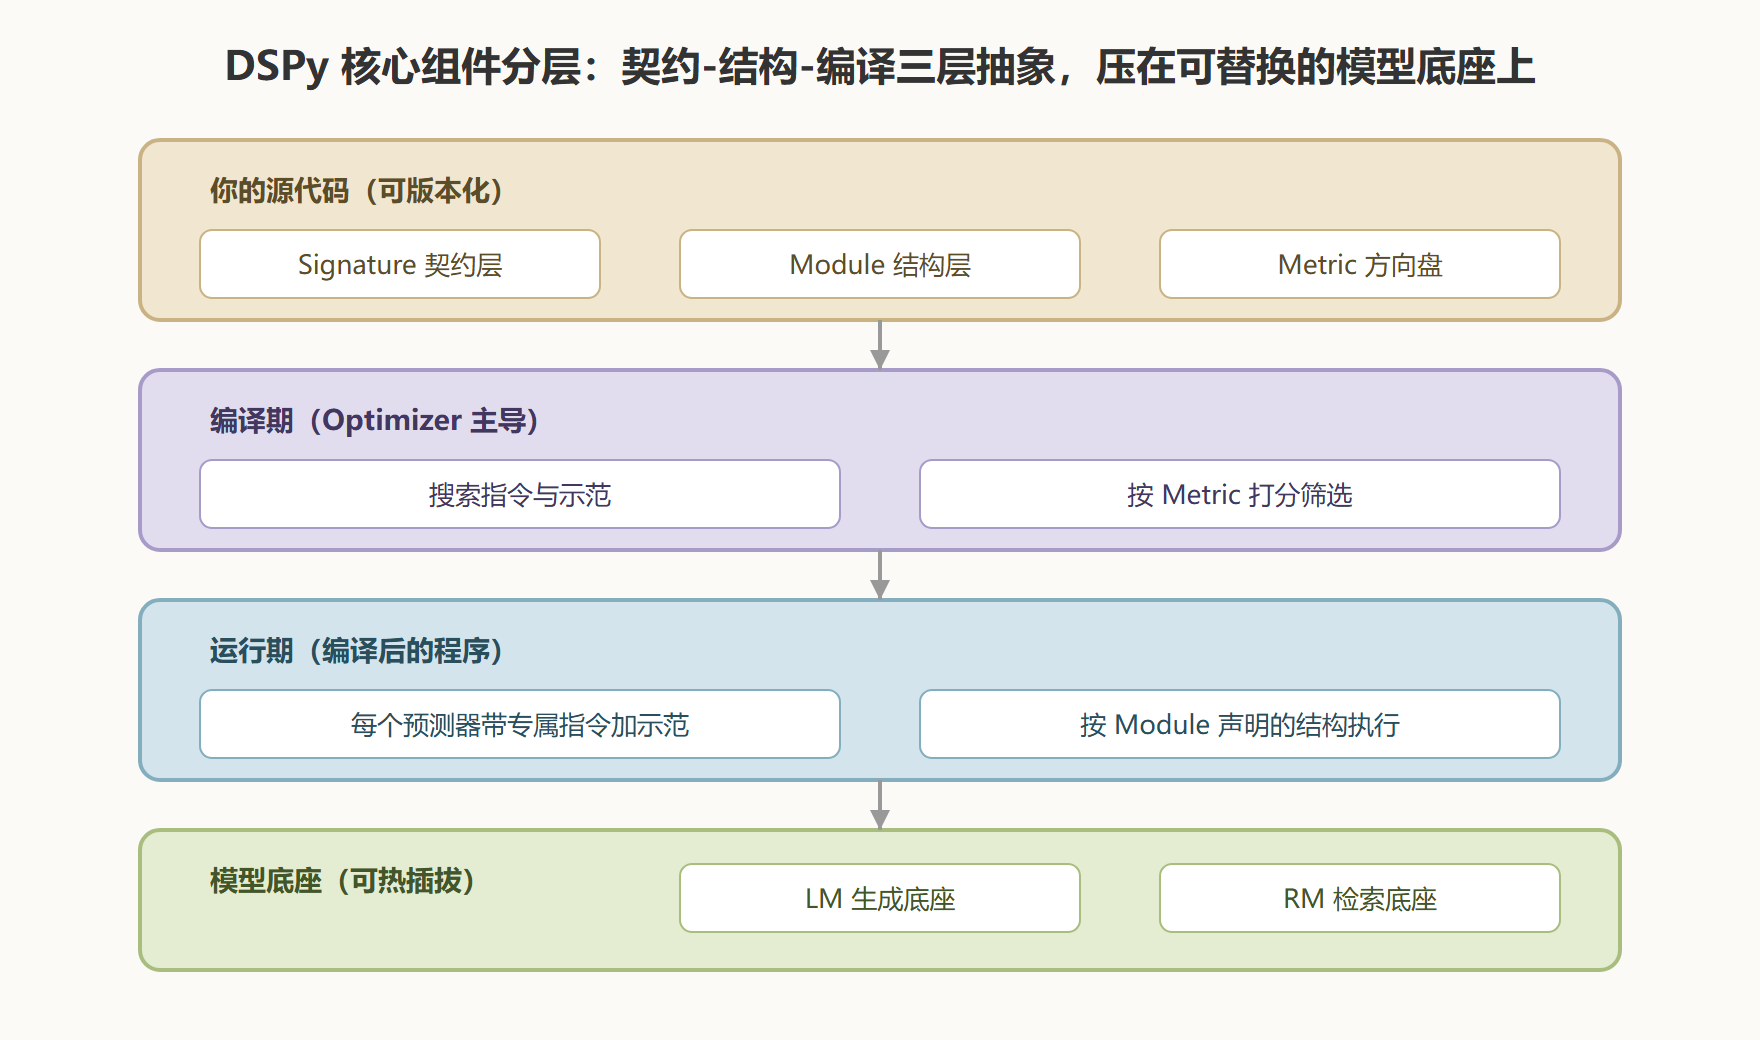
DSPy 的组件体系可以用一句话穿起来:程序由 Module 组成,Module 用 Signature 声明契约,Optimizer 拿着 Metric 当方向盘,把程序加数据编译成高质量的提示词产物,底层 LM 随时可换。 记住这句话里出现的五个名词,组件地图就有了骨架。下面逐个展开,重点讲职责边界——组件之间"谁不管什么"往往比"谁管什么"更能帮你看清设计。
Signature:契约层
签名回答"这一步交换什么信息"。它声明输入字段、输出字段和一句任务描述,不写任何实现。question 进 answer 出是签名,context 加 question 进、带引用的 answer 出也是签名。签名的价值在于把"任务定义"从散落的字符串提升为可被框架理解的类型化结构:编译器靠签名知道每个预测器需要什么、产出什么;模块嵌套时靠签名做接缝匹配;序列化保存程序时靠签名还原行为。第 3 章第 1 节会专门讲签名的写法细节,这里只需要建立"契约层"的定位。
Module:结构层
模块回答"程序分几步、怎么组合"。内置模块覆盖常见行为形态:dspy.Predict 是最朴素的直接预测;dspy.ChainOfThought 让每步自带推理段;dspy.ReAct 结合推理与工具调用;dspy.ProgramOfThought 让模型生成代码再执行取结果;dspy.Retrieve 负责接检索源拿证据;dspy.MultiChainComparison 把多条推理路径汇总对比。模块可以互相嵌套组成任意有向结构——检索接生成、生成接校验、校验不过回溯重试,都是常规组合。模块层的红线是:只管结构,不管提示词内容。哪怕你在 forward 里只做一次 Predict 调用,里面实际发给模型什么指令,你写的代码说了不算,编译器说了算。
Optimizer:编译层
优化器回答"提示词从哪来"。它消费程序、训练数据和指标,产出编译后的程序——每个预测器都带上了学出来的指令与示范。家族成员按策略分几档:LabeledFewShot 只搬运人工标注示范,最便宜;BootstrapFewShot 用程序自身跑出的轨迹自举示范;BootstrapFewShotWithRandomSearch 在自举之上叠加候选程序搜索;MIPROv2 把指令优化与示范选择联合做贝叶斯搜索;BootstrapFinetune 干脆把编译产物固化进权重。选型逻辑与参数调法是第 4 章的主戏。
Metric:方向盘
指标回答"往哪个方向算好"。它可以是一个普通 Python 函数(比如比对答案子串的 exact_match),也可以复杂到调用另一个大模型当裁判(LLM judge)。指标还承担教学信号:编译器在自举时会用指标过滤"答案对但过程歪"的轨迹。指标失真,编译就失真——这是全册会反复回响的一句话。
组件协作全景(表格)
| 组件 | 职责 | 你写什么 | 它不管什么 |
|---|---|---|---|
| Signature | 声明单步 IO 契约 | 字段与任务描述 | 提示词文本、执行顺序 |
| Module | 组织步骤与控制流 | 组合哪些内置模块、forward 逻辑 | 每步的实际指令与示范 |
| Optimizer | 搜索指令与示范 | 选策略、给预算参数 | 程序结构(结构是 Module 的事) |
| Metric | 定义"什么叫更好" | 评分函数或裁判配置 | 如何改进程序(只给信号) |
| LM / RM | 提供生成与检索底座 | 模型名、密钥、检索源配置 | 任务逻辑 |
表里最后一列值得多看一眼。职责边界的清晰化正是 DSPy 相对早期"全家桶脚本"的进步:改任务逻辑不动编译器,换模型不动程序,调搜索策略不动指标——四个维度正交,才能独立演进。
正交性还有一个常被验证的检验方法:问自己"这个组件换掉之后,其他几个要不要跟着改"。Signature 换一套(任务变了),Module 可能要重排、Optimizer 不用动、Metric 要重写——因为契约变了;LM 换一家,四个组件全都不用动——因为底座被隔离了。哪种改动会波及多少组件,波及范围的大小就是耦合度的度量。手工范式里"换个模型"之所以伤筋动骨,正是因为所有东西糊在一起、耦合度拉满;组件化把这个耦合度拆到了每层可独立替换的粒度,这才是"框架"二字相对于"脚本合集"的实质差异。
组件命名演化速查
组件体系是演化出来的,名字换过好几轮,读旧资料时常被绊倒。一张速查表备着:
| 现名 | 旧名或前身 | 变化说明 |
|---|---|---|
| Optimizer | Teleprompter | v2.0 更名,遥控隐喻让位于优化隐喻 |
| dspy.LM | 底层 driver 体系 | 统一的模型配置入口,供应商前缀协议化 |
| Signature | 提示模板的稳定部分 | 从模板字符串中抽取的契约层 |
| Module | dspy.Module(未变) | 语义微调:从模块库强调为可组合单元 |
| Metric | 评分函数 | 从可选参数升格为编译强制输入 |
| MIPROv2 | MIPRO | 提案流程重构,新增小批量评估与 auto 档位 |
表里的规律值得点破:演化方向全部朝向"关注点进一步分离"——命名在分离(Teleprompter 到 Optimizer),职责在分离(Metric 从可选到必填),配置在分离(LM 统一入口)。识别这个方向,你就能预测框架未来的改动大概率落在哪里:凡是还混杂着多种关注点的角落,都是下一轮演化的候选区。
图:三层抽象与底座的分层架构
各组件的演化出身
这套组件不是一次设计出来的,而是演化中逐层沉淀的。契约层(Signature)源自早期 DSP 里"每步提示模板"的结构化拆解——发现模板里真正稳定的只有字段与任务描述,可变的是措辞,于是把稳定部分抽成签名。结构层(Module)来自 PyTorch 的启发:把"组合神经网络层"的组合模式平移到"组合提示词调用"。编译层(Optimizer)的前身 Teleprompter 在 1.1 节已经讲过,更名代表范式确认。指标层最朴素也最晚被制度化——早期版本指标是可选的,实践很快证明没有指标的编译等于盲飞,于是它成了几乎所有编译入口的必填参数。理解每层的出身,能帮你判断"哪些设计是本质的、哪些是过渡形态"——框架还会演化,但"契约-结构-编译"这个骨架短期内不会变。
本节要点回顾
- 一句话地图:Module 组程序、Signature 定契约、Optimizer 做编译、Metric 给方向、LM/RM 当底座。
- 职责边界:模块只管结构不管提示词内容;优化器只管搜索不改结构;指标只给信号不做改进。
- 正交性是关键收益:任务逻辑、搜索策略、质量标准、模型选择四个维度解耦,各自独立演进。
- 演化出身:契约层来自模板拆解、结构层来自深度学习框架的组合思想、编译层由遥控器更名而来、指标层从可选变必填。
- 通向下一节:组件各自就位后,还需要一条把它们串起来的工作流——那就是编译式开发流程,下一节的主角。