2.3 提示词编译的工作流程
2.3 提示词编译的工作流程
本节摘要:把一次完整的 DSPy 编译流程从头走到尾:定义程序、准备数据、定义指标、调用编译器、评估产物、迭代修正。每一步给出可运行的最小代码与运行结果样例。读完本节你就能动手编译自己的第一个程序,后续章节的深入讲解都发生在这条流程的某一步上。
为什么编译需要一条固定流程
手工调优没有"流程"可言——想到哪改到哪,因为它的优化对象(提示词文本)随时可改,也就随时在改。编译范式不同:优化对象变成了搜索空间,搜索空间必须有明确的搜索目标(指标)、搜索素材(数据)和搜索起点(程序)。这三样东西缺任何一样,编译器都动不了。这不是框架强加的形式主义,而是把"优化"当正经事做的最低要求——传统机器学习里训练模型也离不开数据集、损失函数和模型结构这三件套,提示词编译只是把它们换了个名字:训练集对应示范来源,指标对应损失函数,程序结构对应网络架构。
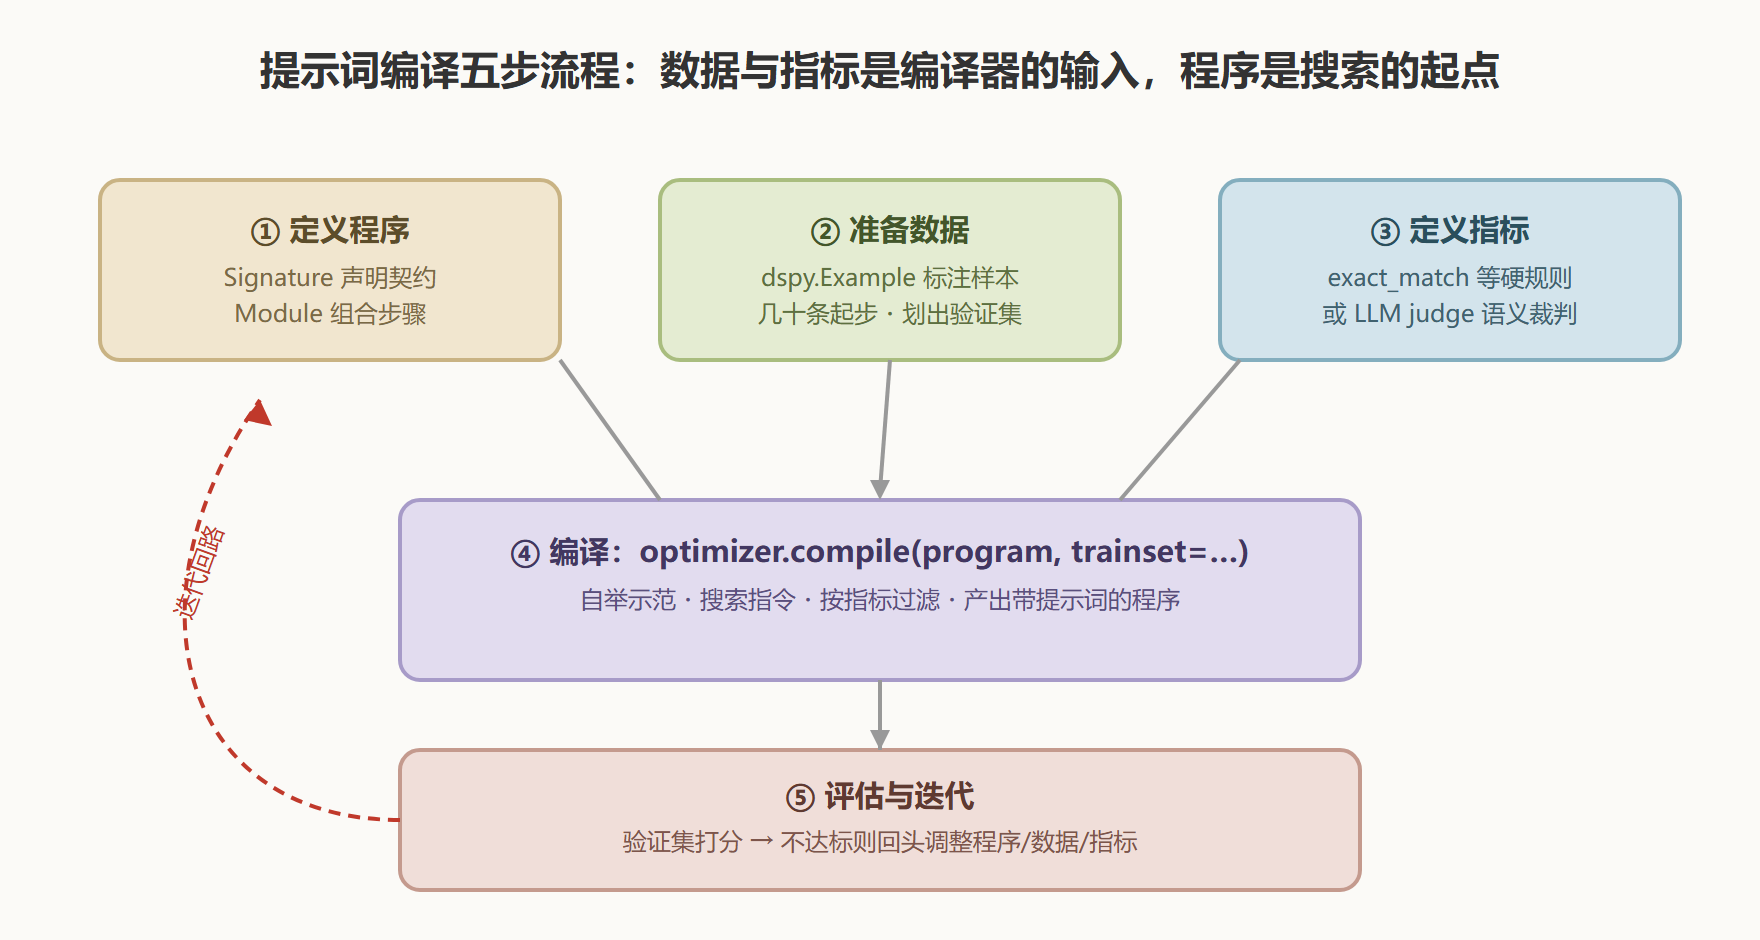
理解了这个对应关系,流程五步就顺理成章了。第一,定义程序:用 Signature 和 Module 把任务结构写清楚。第二,准备数据:整理少量带标注的 dspy.Example,几十条就能启动,几百条更稳。第三,定义指标:给"什么叫好答案"一个可计算的判断。第四,编译:把程序、数据、指标交给优化器,让它去搜索。第五,评估与迭代:在独立验证集上给编译产物打分,决定是收工还是回头调整前三步。
图:DSPy 编译式工作流程
五步流程的最小实现
下面这份代码把五步全部串起来,可以直接改造复用。任务是检索增强问答:检索器从本地文档集合里捞证据,生成模块基于证据作答。
import dspy # ---- 第 1 步:定义程序 ---- class GenerateAnswer(dspy.Signature): """基于检索到的上下文回答问题,答案保持简短。""" context = dspy.InputField(desc="与问题可能相关的若干段证据") question = dspy.InputField() answer = dspy.OutputField(desc="一到五个词的短答案") class RAG(dspy.Module): def __init__(self, k: int = 3): super().__init__() self.retrieve = dspy.Retrieve(k=k) self.generate = dspy.ChainOfThought(GenerateAnswer) def forward(self, question): context = self.retrieve(question).passages return self.generate(context=context, question=question) # ---- 第 2 步:准备数据 ---- trainset = [ dspy.Example(question="瑞士的首都是哪里?", answer="伯尔尼").with_inputs("question"), dspy.Example(question="珠穆朗玛峰在哪个大洲?", answer="亚洲").with_inputs("question"), # …实际项目建议 50 条以上,这里从略 ] # ---- 第 3 步:定义指标 ---- def exact_match(pred, example, trace=None): # 编译期为 trace 模式:返回布尔值,用于过滤自举示范 return example.answer.strip().lower() in pred.answer.strip().lower() # ---- 第 4 步:编译 ---- from dspy.teleprompt import BootstrapFewShot optimizer = BootstrapFewShot( metric=exact_match, max_bootstrapped_demos=4, # 最多自举 4 条示范 max_labeled_demos=2, # 再混入 2 条人工标注示范 ) compiled_rag = optimizer.compile(RAG(), trainset=trainset) # ---- 第 5 步:评估 ---- evaluate = dspy.Evaluate( devset=trainset[-10:], # 评估集务必与训练集分离 metric=exact_match, num_threads=8, display_table=5, ) print(evaluate(compiled_rag)) # 输出如:Average Metric: 8.0 / 10 (80.0%)
跑完之后值得做一件事:dspy.inspect_history(n=3)。你会看到编译后的程序发给模型的完整提示词——里面已经带上了优化器挑出的示范和改写过的指令,与你写代码时"什么都没写提示词"的直觉形成鲜明对照。这个对照就是编译范式最直观的样品展示。
编译日志怎么读
与流程五步配套的还有一个实用技能:读编译日志。一次编译的标准输出大致分四段——数据段(训练集规模、切分信息)、自举段(每一轮产出的合格轨迹数与淘汰数)、评估段(候选产物的逐个分数)、结论段(最终选中哪个候选)。四段各有健康信号:自举段的合格率长期低于两成,预示零样本能力或指标有问题;评估段各候选分数挤在一起(差距微乎其微),说明任务对提示词形态不敏感,继续加预算意义不大;结论段选中的候选与"直觉上最好"的不一致时,先怀疑验证集太小导致的评分噪声,而不是怀疑优化器。把日志当体检报告读,而不是当进度条看——这是把编译当工程做的第一步习惯。
每一步的常见误区
定义程序环节最常见的错误是把提示词思维偷渡回来——在签名的任务描述里塞满输出格式细节。描述应该说明"什么是好的输出",格式约束交给字段类型与 desc。数据环节的典型坑是训练评估不分离:用训练集自举、又用同一批数据评估,分数虚高到毫无意义,正确做法是从一开始就切出独立验证集。指标环节的大坑是"指标代理失真":比如用子串匹配评开放式摘要,编译器会学着把原文整段抄进答案——指标可以通过,产物不可用。编译环节要管理预算预期:自举意味着"每条示范都要真实跑若干次模型调用",示范上限与训练集规模的乘积就是编译的基础开销。评估环节则记住一条:同一配置至少跑两次看方差,DSPy 的搜索带随机性,单次分数未必可复现。
这五个误区指向同一个元认知:流程五步里,程序与编译器是框架替你管好的,数据与指标才是真正需要你负责的部分。本书后面每一章,本质上都在把某一步往深处讲透。
本节要点回顾
- 流程三前提:搜索目标(指标)、搜索素材(数据)、搜索起点(程序)——对应机器学习的损失函数、训练集、模型结构。
- 五步顺序:定义程序、准备数据、定义指标、编译、评估迭代;顺序不可乱,指标先于编译。
- 最小代码骨架:Signature 加 Module 加 BootstrapFewShot 加 Evaluate,不足三十行即可跑通全流程。
- 五个误区:格式塞进描述、训练评估混用、指标代理失真、预算预期失衡、单次评分定论。
- 通向下一章:本节的每一步在后面都有专门章节深化——先从最核心的三层抽象开始,那是第 3 章的全部内容。