4.4 BootstrapFewShot:自举编译器
4.4 BootstrapFewShot:自举编译器
本节摘要:拆解 DSPy 使用率最高的编译器:自举机制的完整执行序列、四个核心参数(max_bootstrapped_demos、max_labeled_demos、max_rounds、metric)的作用点与调法、编译开销的估算公式,以及三类失败模式的排查清单。理解了它,就理解了 DSPy 所有编译器的公共地基。
编译器是怎么诞生的
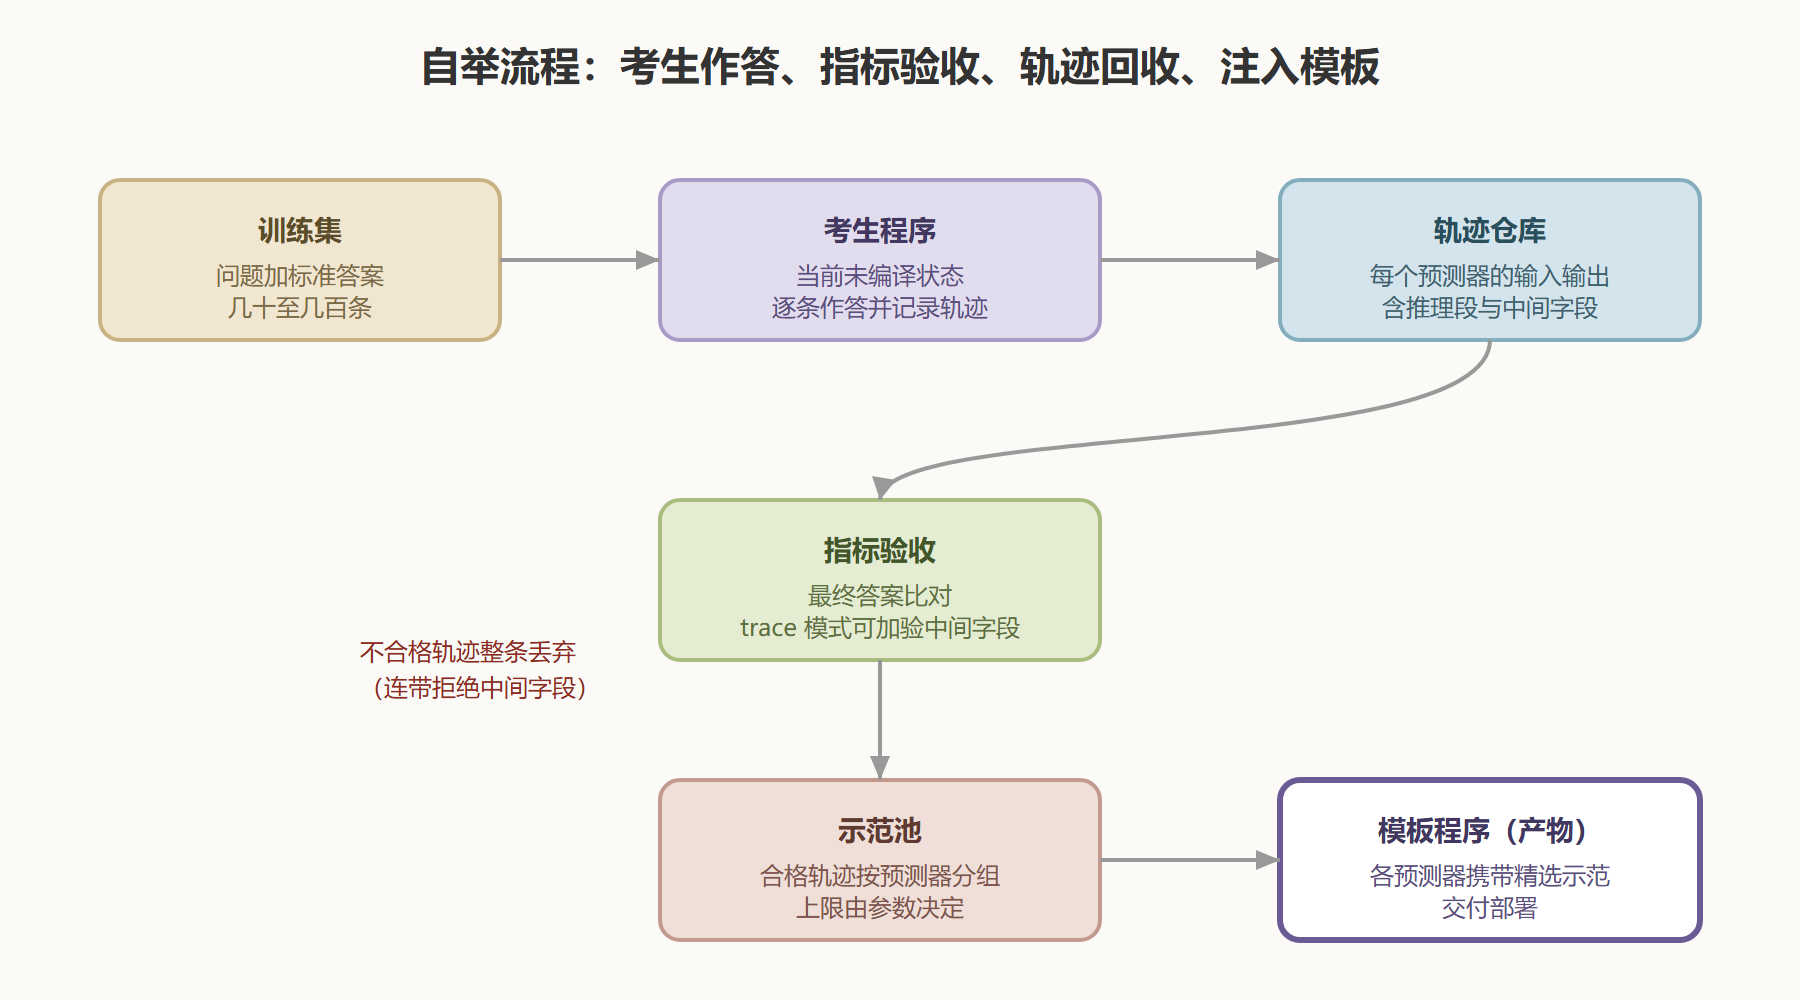
先建立一个心智图像:BootstrapFewShot 编译时,你的程序会被复制成两份角色。一份当"考生"——拿训练集逐题作答;一份当"模板"——最终交付的编译产物。考生答题的完整轨迹(每个预测器收到了什么、输出了什么)被记录下来,指标逐条验收,合格轨迹按预测器拆解成示范,注入模板的对应预测器。整个过程里没有任何权重更新,"学习"完全体现为示范的筛选与注入——严格说,它优化的不是模型,是模型看到的上下文。
图:BootstrapFewShot 自举流程
四个核心参数的作用点
metric 是验收官,3.5 节已经讲透,这里只补一句编译视角的话:它同时决定"哪些轨迹能当示范"与"示范教给模型什么",改指标等于换老师。其余三个参数控制数量与轮次:
- max_bootstrapped_demos:每个预测器示范池里自举示范的上限。取值建议从 2 到 4 起步。调大有两个代价——编译开销线性上涨(每条自举示范背后是完整的程序执行),以及提示词变长推高每次运行的 token 成本;但它也让预测器见过更多正例,对分布偏移更稳。
- max_labeled_demos:混入的人工标注示范数。它的定位是"保底教材":当自举产出不足(程序零样本太弱)时,标注示范保证预测器至少有几个像样范例。典型配置是 2 到 8 条,与自举示范按需配比。
- max_rounds:自举轮数。一轮自举后程序带着示范再跑一遍训练集,可能产出更多合格轨迹(因为示范已经提升了表现),这就是多轮的收益来源。默认一轮;任务难、首轮合格轨迹明显不足时加到 2 到 3 轮,代价是编译时间近似翻倍。
三个参数与开销的关系可以记成一个粗略公式:编译期调用次数 ≈ 训练集规模 × 链路预测器数 × max_rounds(外加验证开销)。五十条训练集、两个预测器、一轮自举,就是约一百次模型调用起步——预算紧的时候先动哪个参数,现在可以算着办。
自举之上加保险:带随机搜索的变体
自举的一个结构性弱点是"一次定终身":一轮自举只产出一套示范,自举质量依赖轨迹抽样的运气,运气差的编译轮次会交出明显偏弱的产物。BootstrapFewShotWithRandomSearch 的对策是把自举放进候选框架:编译时并行产出一组候选程序——零样本版(纯指令无示范)、仅标注示范版、若干个不同自举种子的版本——然后在验证集上逐个打分,返回最优者。它同时回答了两个问题:这轮自举的运气如何(各候选分数差距就是运气方差),以及哪个形态最适合当前任务(有时零样本版反而赢,说明示范在帮倒忙)。
from dspy.teleprompt import BootstrapFewShotWithRandomSearch optimizer = BootstrapFewShotWithRandomSearch( metric=exact_match, max_bootstrapped_demos=2, # 每个候选的自举上限压低,控制总开销 max_labeled_demos=8, num_candidate_programs=8, # 候选数量:含零样本版与若干自举种子 num_threads=16, # 候选评估的并发线程 ) best_program = optimizer.compile(my_program, trainset=trainset, valset=devset)
开销与收益的换算值得记住:八个候选意味着评估开销约为单次自举的八倍,但换来对自举方差的直接观测。实践中它常被用作"诊断器"——当你怀疑自举不稳时,先跑一遍带随机搜索的变体看候选分数分布:分布紧凑说明自举稳定,可以退回便宜的纯自举;分布散乱说明运气主导,要么加大示范上限,要么接受"多编几次取最优"的工作流。
编译日志实例解读
把一段真实感的编译日志压缩后逐行解读,帮你建立"读日志"的手感:
Bootstrapping 4 examples... # 自举段:目标 4 条示范 Round 1: 50 tries, 21 passed # 第一轮:跑 50 条,21 条过指标 Round 2: 21 tries, 9 passed # 第二轮:带示范再跑,合格率提升 Selected 4 examples. # 凑齐 4 条,注入示范池
三个信号藏在数字里。第一轮合格率四成出头,说明零样本能力及格,自举有原料;第二轮合格率从四成涨到接近一半,说明示范注入立刻见效——这是程序"可教"的直接证据,若第二轮不涨反跌,要警惕示范污染。预算视角同样可算:两轮合计七十一次程序执行,每次执行的调用数等于链路预测器数,乘上单次 token 成本就是这次编译的自举开销——日志不是流水账,是账本。
参数之外再补一条调试期的实用技巧:编译前先做一次"迷你自举"——把训练集砍到十条、示范上限设为二、只跑一轮,几十秒内验证整条编译链路(数据格式、指标可用性、模型连通、示范注入)是否畅通。迷你自举跑通了,正式编译大概率一次成功;跑不通,报错也在小规模下最好定位。这相当于编译世界的冒烟测试,成本可以忽略,省下的却是正式编译动辄数十分钟的等待与排错。
三类失败模式与排查
失败模式一:合格轨迹产出率过低,编译器报示范不足。病因通常在两头——要么程序零样本能力太弱(模型小、签名要求过高),要么指标太苛刻。排查:先人工抽二十条训练集让程序裸跑,数一数指标能放行几条;放行率过半还凑合,不足两成就先补 max_labeled_demos 保底或换更强模型,别急着调自举参数。
失败模式二:示范注入了,分数不涨反跌。多半是示范污染:指标放行了答案对但过程歪的轨迹(比如多跳程序里第二跳蒙对了)。治理靠 trace 模式加验中间字段,或收紧指标(3.5 节的双重回路正为此设计)。
失败模式三:验证集分数好,换批数据就垮。这是分布问题的典型症状——自举示范全部来自训练集分布,训练集太窄时示范成了"偏科教材"。对策:扩充训练集覆盖面优先于一切参数调整;若确实无法扩充,把 max_bootstrapped_demos 调小、max_labeled_demos 调大,让更稳定的人工标注主导示范池。
这三类失败覆盖了实践中的绝大多数编译事故。排查的共同起点是同一个动作:打开历史检查工具,直接看示范池里进了什么——产物可审计,是自举路线区别于一切"玄学调优"的底气。
本节要点回顾
- 考生与模板:编译时程序分饰两角,考生产轨迹、模板收示范;没有权重更新,优化的是上下文。
- 参数三分:metric 定验收标准,max_bootstrapped_demos 与 max_labeled_demos 定示范配比,max_rounds 定迭代深度;开销公式帮助预算决策。
- 保底与上限:标注示范是零样本太弱时的保底教材,自举示范是贴近程序分布的上限食材,配比按数据现实定。
- 失败三型:产出率低查零样本与指标、掉分查示范污染、跨分布垮查训练集覆盖面;起点都是审计示范池。
- 通向下一节:自举解决了示范从哪来,但指令还停在人工 docstring——把指令也交给搜索,就是 MIPROv2 的登场理由。