4.5 MIPRO 与 MIPROv2:指令示范联合搜索
4.5 MIPRO 与 MIPROv2:指令示范联合搜索
本节摘要:MIPRO 系列把编译器的搜索空间从"示范"扩展到"示范加指令"两个维度:提案模型负责生成候选指令,贝叶斯搜索负责在候选组合里挑选,验证集负责打分。本节拆解它搜索空间的两层结构、两阶段流程与关键参数(num_candidates、num_trials、auto 档位),并给出预算与档位的实操配置。
搜索空间为什么要拆成两层
自举编译器默认一个假设:你写的任务描述(签名 docstring)已经够好,需要学的只是示范。MIPRO(Multi-prompt Instruction Proposal Optimizer,多提示词指令提案优化器)撤回了这个假设——指令本身也是待优化变量。这个撤回有扎实的观察支撑:同一个程序,仅改写各预测器的指令措辞,验证集分数就能差出可观幅度;人写的 docstring 往往描述了任务,却未必是"对这个模型最有效的表述"。于是搜索空间变成两个维度:每个预测器的示范组合(自举机制提供原料)与每个预测器的指令(提案模型生成)。
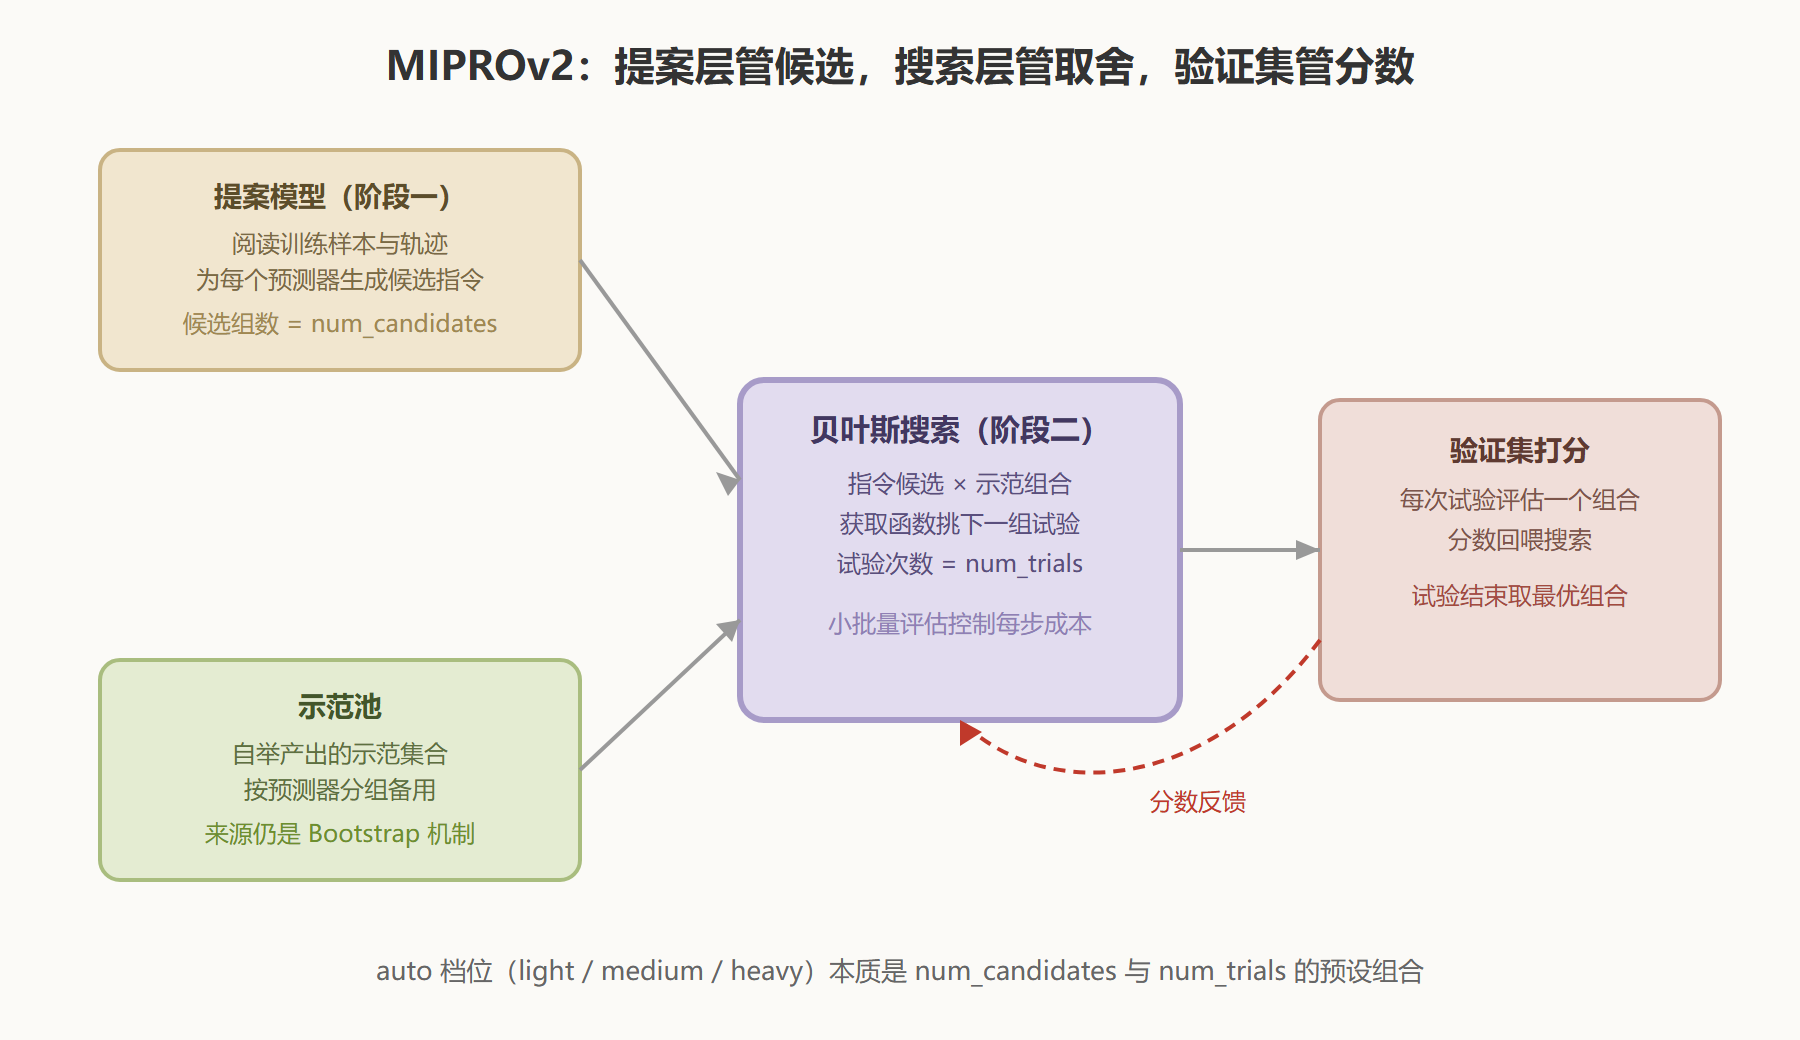
两个维度为何拆成两层处理?因为联合空间是组合爆炸的——三个预测器、每人十条候选指令、示范池几十条,直接枚举不可行。MIPRO 的做法是分层采样:指令层由提案模型按"数据感知"的方式生成候选(提案模型能看到训练集样本、程序的执行轨迹,从而提出有针对性的表述,而不是瞎改写);组合层由贝叶斯搜索在"从每个预测器的候选指令里各选一条、从示范池里各选一组"的巨大空间里,用采样感知的获取函数决定下一轮评估哪个组合。两层各司其职:提案管"值得试什么",搜索管"先试哪个"。
图:MIPROv2 的搜索空间与两阶段流程
提案模型的配置与成本分摊
MIPROv2 允许把"提案"与"执行"分给不同的模型:提案(生成候选指令)需要较强的指令跟随与改写能力,执行(自举轨迹与验证评估)追求便宜。分档配置的写法与成本账如下:
optimizer = MIPROv2( metric=exact_match, prompt_model=dspy.LM("openai/gpt-4o", max_tokens=1024), # 提案用强模型 task_model=dspy.LM("openai/gpt-4o-mini", max_tokens=512), # 执行用经济模型 num_candidates=10, )
这笔账的妙处在于开销结构:提案模型的调用次数只有候选数级别(十次上下),占大头的执行开销全部落在经济模型上。用强模型提案、经济模型执行,总成本与全用经济模型相差无几,但候选指令的质量上限明显抬高——这是联合搜索配置里性价比最高的一个技巧。反过来,若发现候选指令质量平平(提案产出与原指令高度雷同),优先检查提案温度是否过保守、提案模型是否被限流,而不是先加 num_candidates——候选的"质"比"量"更早遇到瓶颈。
一份试验记录的复盘
把一次多跳任务上的联合搜索试验记录压缩成表,看搜索层在做什么决策:
| 试验 | 指令组合特征 | 示范组合 | 验证分 |
|---|---|---|---|
| 1 | 原始 docstring 微调 | 标注示范为主 | 0.71 |
| 2 | 强调"逐步检索"的改写 | 自举与标注混配 | 0.78 |
| 3 | 精简风格改写 | 纯自举 | 0.74 |
| 5 | 引入"证据不足即认输"表述 | 混配并加约束示范 | 0.83 |
| 9 | 与 5 相近的邻域采样 | 混配微调 | 0.82 |
表中藏着搜索行为的三条规律。其一,得分跃升来自"语义级"的指令改动(引入认输表述),而不是措辞级的润色——提案模型的价值正在于它敢做语义级提案。其二,获取函数在试验 5 拿到高分后,试验 9 转向其邻域采样确认——这是贝叶斯搜索"利用已知好区"的正常行为,也是为什么试验预算里要留一部分给探索。其三,最终产物选 5 而非 9,差距虽小但方向一致,说明分数差是信号不是噪声;若前几名的分数在噪声带内(±两个百分点),就该扩大验证集而不是纠结选哪个。
关键参数与一份可抄的配置
MIPROv2 的编译入口把预算集中暴露在少数参数上。num_candidates:提案层为每个预测器生成的候选指令组数,越大指令层越充分,提案的模型调用成本同步上升;num_trials:搜索层的试验次数,每 trial 评估一个"指令加示范"组合,是主要开销所在;auto:官方预设档位(light、medium、heavy),自动按程序规模与任务推算上面两个参数,不想手调就用它;minibatch:试验期用小批量验证集快速打分,显著降低单 trial 成本,代价是分数噪声变大。
from dspy.teleprompt import MIPROv2 optimizer = MIPROv2( metric=exact_match, auto="medium", # 预算档位:light 省钱、heavy 冲上限 num_candidates=10, # 手动接管时:每个预测器 10 组候选指令 init_temperature=1.0, # 提案温度,鼓励指令多样性 ) compiled = optimizer.compile( multihop_program, # 4.3 节的多跳程序 trainset=trainset, valset=devset, # 验证集必须独立于训练集 max_bootstrapped_demos=3, # 示范层仍由自举供给 max_labeled_demos=4, num_trials=20, # 搜索层 20 次试验 minibatch=True, # 小批量评估,试验更快 requires_permission_to_run=False, # 脚本化场景免交互确认 )
预算的量级估算:单次试验成本约等于"验证集小批量大小 × 链路预测器数"次调用,总开销 ≈ num_trials × 单试验成本,另加提案层的 num_candidates 次生成。medium 档在多跳程序上的实测体感是几十到上百次验证调用级别——比 BootstrapFewShot 贵一个数量级,但换来的是指令层的搜索收益。什么时候值回票价?经验信号是:自举编译后分数进入平台期、且你怀疑指令表述是瓶颈时(特征:手工改一句指令,分数明显波动)。平台期一出现,就是从自举升级到联合搜索的时点。
MIPRO 与 MIPROv2 的差别一段话
历史留了两个名字,差别常被问起。初代 MIPRO 先行验证了"指令加示范联合优化"的可行性,但提案与搜索的耦合较紧、小批量评估支持不完善;MIPROv2 重构了提案流程(候选指令生成更充分地利用数据感知),引入小批量评估与更稳定的获取函数,并补上了 auto 档位这套预算管理。选型不需要纠结:新项目直接用 v2,初代只存在于旧教程与复现论文的场景里。这段演化与第 3 章的 Teleprompter 更名一脉相承——每一代编译器都在把上一代验证过的想法做工程化压实。
本节要点回顾
- 空间两层:指令层由提案模型按数据感知生成候选,组合层由贝叶斯搜索决定试验顺序;分层是对组合爆炸的回应。
- 参数对位:num_candidates 管指令层充分性,num_trials 管搜索层数,auto 档位是两者的预设打包,minibatch 用噪声换速度。
- 升级时点:自举进入平台期、手工改指令能引起分数波动时,联合搜索的边际收益最大。
- 验证集纪律:联合搜索对验证集的消耗与依赖都更深,独立切分与规模充足从建议升格为前提。
- 通向下一章:编译器把分数推到指标允许的上限,接下来的问题是——这套分数与产物,凭什么值得信任?评估体系的合流在下一章展开。