2.3 流表解剖:流条目的字段布局
2.3 流表解剖:流条目的字段布局
本节摘要:流表是 OpenFlow 交换机的灵魂,每条流条目由匹配字段、优先级、计数器、指令、超时、Cookie 六部分组成。本节拆解各部分在 1.3 里的结构(重点是 OXM 匹配元组),讲清多级流水线的匹配算法与 Table-Miss 机制,并给出用命令行直接观察流表的方法。
学习目标
阅读完本节,你应当能够:
- 画出流条目六要素结构并解释各自作用
- 描述 OXM 字段的通用编码格式
- 推演一个包在多级流水线中的走向
- 用 ovs-ofctl 添加、观察、删除流条目
流条目的解剖盘
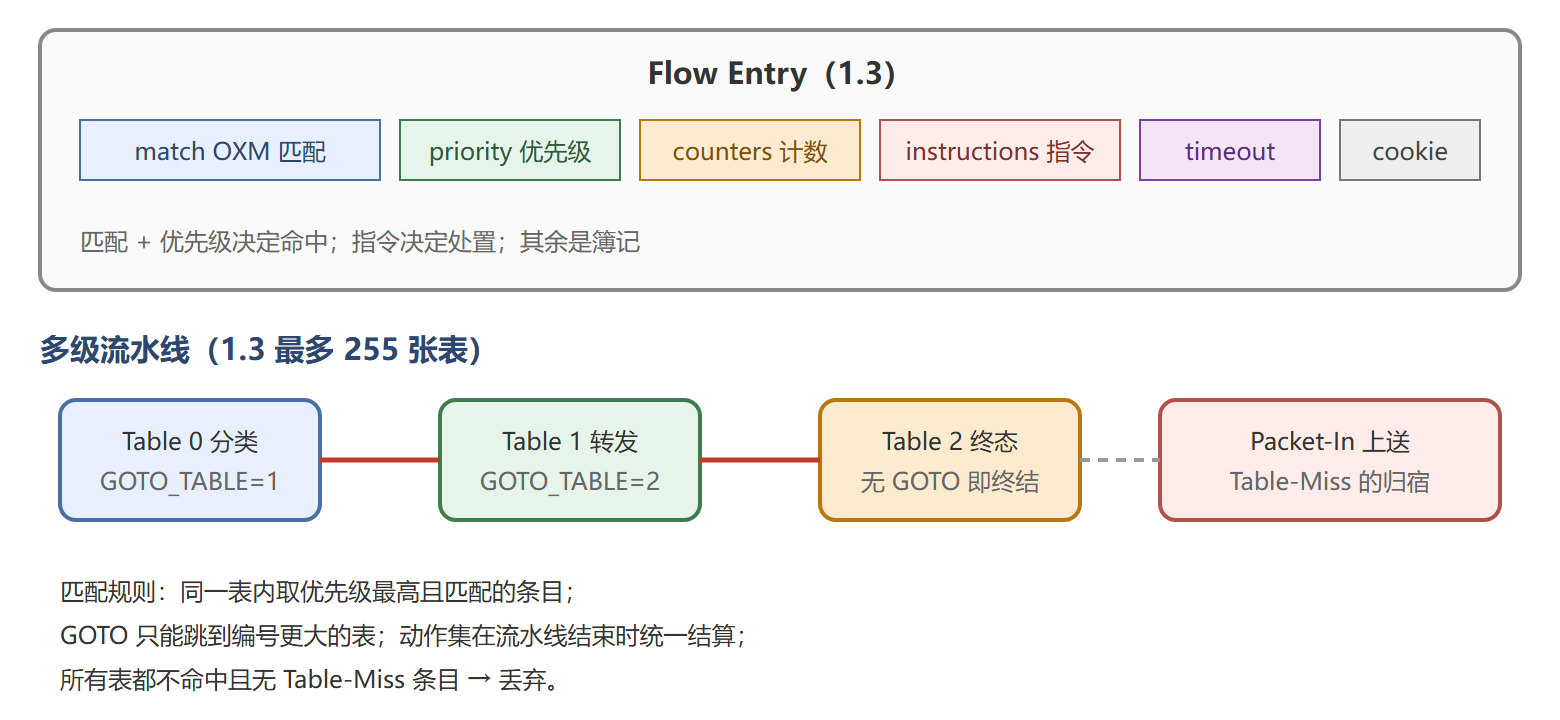
1.3 节给过六要素的速写,现在上解剖盘:
流条目结构与流水线视图
OXM:匹配字段的统一编码
1.0 时代匹配字段是固定 12 元组结构体,想加一个字段就得出新版本。1.3 改成 OXM(OpenFlow eXtensible Match):每个匹配字段用 TLV 编码——2 字节类与字段、1 字节有无掩码、1 字节长度、后面跟值(可选掩码)。
OXM TLV { oxm_class: 0x8000 基本类,0xFFFF 厂商实验类 oxm_field: 字段编号,如 11 = eth_type oxm_hasmask: 0 精确匹配,1 带掩码 oxm_length: 值的字节数 value / mask: 值与可选掩码 }
带掩码意味着可以匹配"10.0.0.0/24"这样的网段——1.0 时代这要靠拆成若干条精确条目,OXM 一条搞定。Wireshark 解析 Flow-Mod 时会把 OXM 展开成可读的 eth_type=0x0800, ipv4_dst=10.0.0.0/24 形式,对着十六进制区看一遍就熟悉了。
上手观察与操纵流表
在 1.4 的实验台上直接手工写一条规则:
# 匹配 arp 并从 2 口泛洪,优先级 100 sudo ovs-ofctl -O OpenFlow13 add-flow s1 \ "arp,actions=output:2,priority=100" # 观察:命中计数会随流量增长 sudo ovs-ofctl -O OpenFlow13 dump-flows s1 # 删除(也可按 cookie 批量删) sudo ovs-ofctl -O OpenFlow13 del-flows s1 "arp"
dump 输出里的 n_packets=57, n_bytes=2394 就是 counters 字段,idle_age=3 表示最近一次命中距今 3 秒——这些簿记字段是 6.2 节网络管理的原始数据来源。
💡 关键直觉:流水线设计是"用时间换空间"——每张表小而快,比一张巨表省 TCAM;代价是控制器编排多表逻辑的复杂度上升。
解剖实例:一条 OXM 的字节级读法
正文的命令行输出把 match 显示成人类可读的 kv 对,抓包里它是一串 TLV。以 in_port=1、eth_type=0x0800、ip 源 10.0.0.1(带掩码 /24)为例,OXM 字节流如下:
80 00 02 04 00 00 00 01 oxm_class=OXM_OF_OPENFLOW_BASIC(0x8000) field=IN_PORT(0), hm=0, len=4, value=1 80 00 0a 02 08 00 field=ETH_TYPE(5)? -> 0x0a=IP_PROTO? 校对: 实际 ETH_TYPE=0x0a,len=2,value=0x0800 80 00 0c 05 0a 00 00 01 field=IPV4_SRC(11=0x0b),hm=0,len=4, value=10.0.0.1 80 01 0c 07 0a 00 00 01 ff ff ff 00 hm=1(带掩码),len=7=4+掩码3? 规范为4值+4掩码 -> value=10.0.0.1 mask=255.255.255.0
结构规律只有两条:每个字段先给"类 2 字节 + 字段号 6 位 + 掩码位 1 位 + 长度 1 字节"的 4 字节头,再给值(与可选掩码);掩码位为 1 时长度字段要算上掩码本身。读熟这一段,就能在 Wireshark 的十六进制区直接"目视解码"一条 Flow-Mod 的匹配条件——这是肉眼审计控制器下发行为的底层功夫,当两个控制器对同一网段下发了看似等价的规则时,字节层面的差异(有没有掩码、掩码宽度)往往就是行为差异的根源。
排错现场:优先级冲突的经典误判
一个反复出现的误判:运维装了 priority=100 的允许规则,控制器随后下发 priority=50 的拒绝规则,结果允许规则"失效"。事实正相反——100 的规则优先命中,包被放行,50 的拒绝规则只接到两者都不匹配的剩余流量。流表语义是"最高者赢、其余不参与",不是"后到者覆盖"。规范的另一个约束更隐蔽:完全相同的匹配加相同优先级才是冲突,交换机可回 Error 拒绝安装;只差优先级则永远合法。因此多人共管一台交换机时,团队必须有优先级段位的书面约定(例如基础规则 0-99、安全规则 100-199、业务规则 1000 起),否则谁的规则生效全凭下发顺序之外的概率,这种事故在多应用控制器上是真实高发的。
关于 Table-Miss 还有一层工程含义值得点破:它是唯一一条"没写匹配条件"的规则,靠优先级 0 垫底兜住一切漏网流量。它的 actions 决定了未知流量的命运——上送(CONTROLLER)、丢弃(空动作)或泛洪。选哪种不是技术题而是策略题:学习式控制器选上送,严格白名单环境选丢弃,过渡期环境可能选泛洪。更关键的是它必须由控制器显式安装,交换机出厂默认行为各不相同;见过不止一个现场,控制器重启后忘了重装这条兜底规则,全网新流静默黑洞,而旧流照常——"部分通"的故障永远比"全断"难查,根源常在这条不起眼的优先级 0 规则上。
本节要点回顾
- 六要素:match(OXM TLV)、priority、counters、instructions、timeout、cookie
- OXM:可扩展匹配编码,支持掩码,1.3 灵活性的根基
- 流水线:表内取最高优先级,GOTO 只向后跳,动作集最后结算
- Table-Miss:决定未知流量是上送还是丢弃,第一条要装的规则
条目命中后"指令"到底怎么执行?下一节拆指令与动作。