2.2 字符串函数:contains 与 substring
2.2 字符串函数:contains 与 substring
本节摘要:字符串函数把节点拍成字再切、拼、找子串。
contains(title,'XML')能选出 Learning XML;substring按下标从 1 起截取;string()只转换节点集的第一个节点。空白用normalize-space压掉,否则看起来相同的书名比不过。
本节地图
阅读完本节,你应当能够:
- 用 contains、starts-with 过滤书名
- 用 substring、string-length 截取与测长,并记住下标从 1 起
- 说明 string 作用于节点集时只取第一项
- 用 normalize-space 处理缩进造成的假空白
一、找出书名里带 XML 的那本
原文集示范过这条,输出就是 Learning XML 的 title 文本:
/bookstore/book[contains(title,'XML')]/title/text()
三本样本里 Everyday Italian、Harry Potter 都不含这段子串,只有第三本命中。starts-with(title,'Learning') 同样命中它。contains 区分大小写:'xml' 小写在这本书上是假。需要忽略大小写时,1.0 用 translate 把两边都转到小写再 contains;2.0 才有更像样的大小写折叠。
再截一段:
substring(/bookstore/book[1]/title, 1, 5) → Every string-length(/bookstore/book[1]/title) → 17
下标从 1 开始。写成 substring(title,0,5) 的行为按规范很别扭,不要用 0。第三个参数是长度不是结束下标:substring(s,1,5) 是前五个字符,不是「切到第 5 个之前」的某种半开区间想象。
二、拍扁、拼接、翻译
string() 的规则(原文集 2.2 写得很明确)值得当纪律:
- 节点集:取第一个节点的字符串值;空集得空串
- 数字、布尔:按规则变成
'true'/'false'/ 数字的字面 - 空序列(2.0):空串
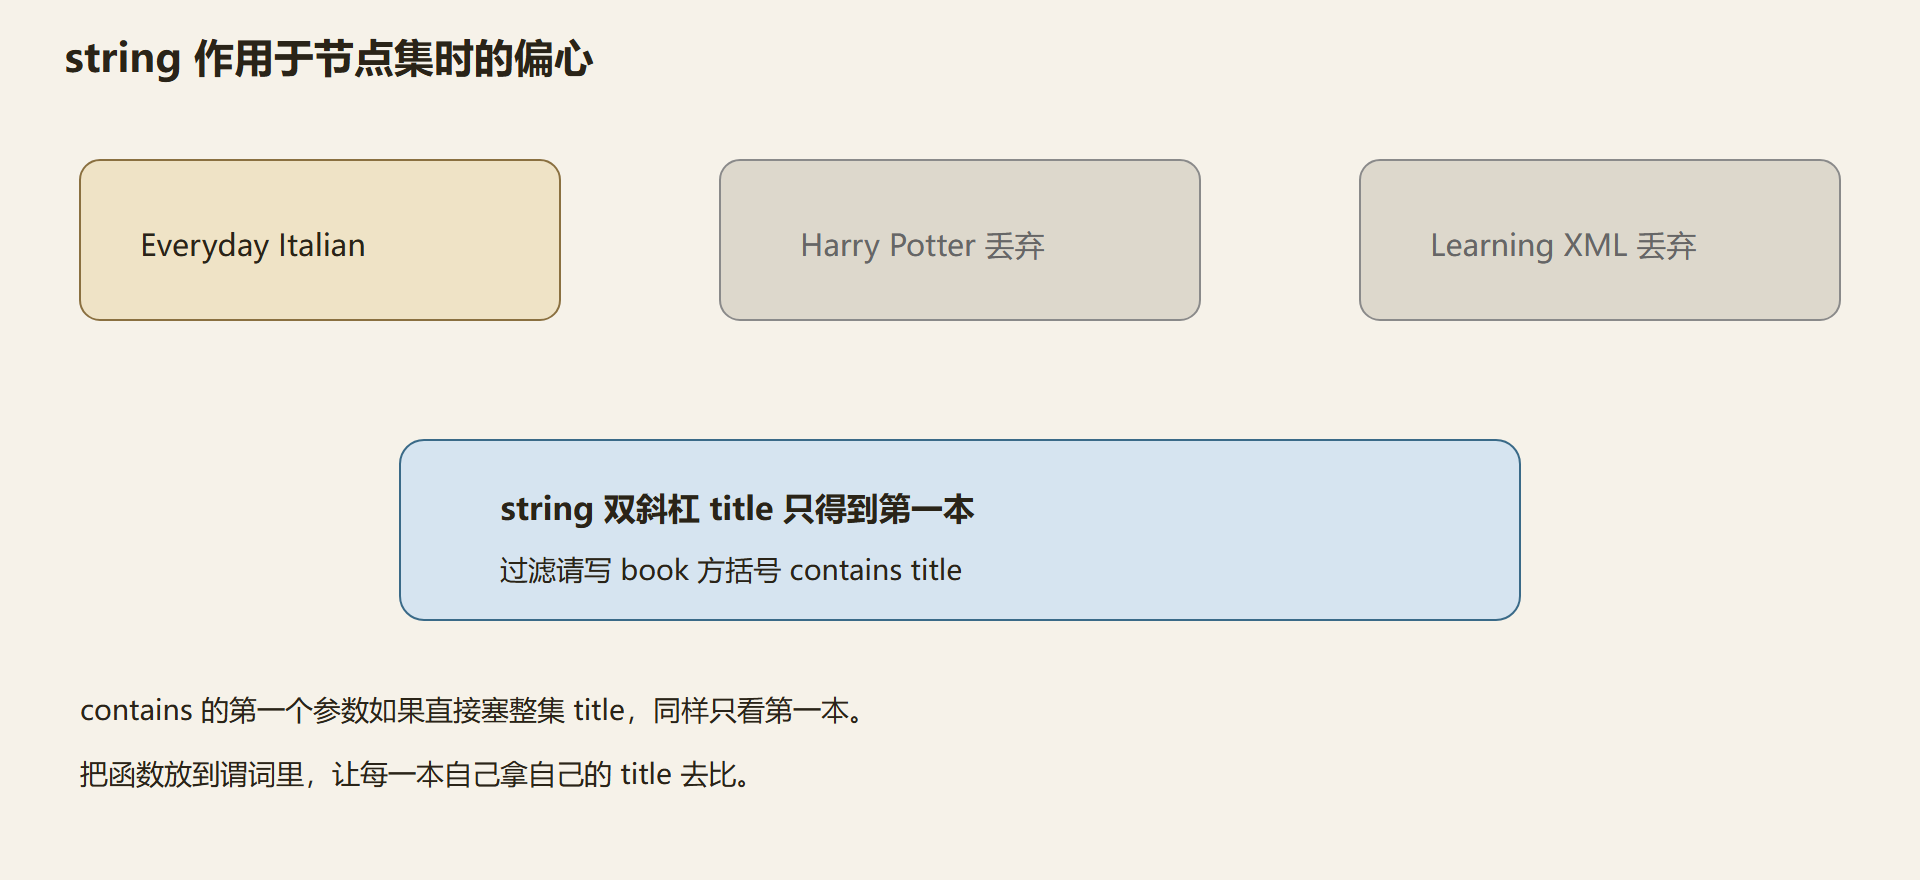
所以 string(//title) 永远偏心第一本 Everyday Italian。要三本书名,选出节点集后在 Python 里 [t.text for t in nodes],别指望一个 string 调用打包回来。
| 函数 | 作用 | 书店例子 | 坑 |
|---|---|---|---|
| string | 拍扁 | string(book[1]/title) |
节点集只取第一 |
| concat | 拼接 | concat(title,'#',price) |
1.0 参数个数固定风格 |
| substring | 切片 | 前 5 字 Every | 下标从 1 |
| string-length | 测长 | 17 | 测的是拍扁后的字 |
| contains | 含子串 | title 含 XML | 区分大小写 |
| starts-with | 前缀 | Learning | 空前缀恒真 |
| normalize-space | 压空白 | 缩进书名 | 头尾空白全砍 |
| translate | 换字 | 大小写折叠土法 | 按字符映射不是正则 |
| substring-before / after | 按分隔符切 | 少用在书名 | 找不到得空串 |
concat 在 1.0 里一次拼多个参数。没有 join 数组。把所有书名拼成一句,还是宿主语言的活。
normalize-space 把头尾空白去掉,中间连续空白收成一个空格。HTML 抓取时文本节点经常带着换行,直接 text()='Harry Potter' 为假,套上 normalize-space 就真。我在抓取谓词里几乎默认包一层。
⚠️ 常见坑:
contains(//title,'XML')的第一个参数若是节点集,1.0 会把该节点集转成第一个节点的字符串。后面两本根本没参与 contains。要过滤「哪本书的 title 含 XML」,必须book[contains(title,'XML')],让 contains 的上下文落在每一本上。
💡 关键直觉:字符串函数吃的是字。先问「这时拍扁的是哪一个节点」,再问「子串在不在」。
图:string 偏心第一本
三、translate 与「没有正则」
1.0 没有正则。translate(title,'ABCDEFGHIJKLMNOPQRSTUVWXYZ','abcdefghijklmnopqrstuvwxyz') 能做大小写折叠,字符集要写全,漏一个字母就漏一次匹配。真正的正则请到宿主语言:选出候选节点,用 Python 的 re 或 Java 的 Pattern。硬把 translate 堆成解析器,维护成本高于换语言。
substring-before(title,' ') 在 Everyday Italian 上得到 Everyday。找不到空格时 before 为空、after 为空,starts-with 对空串返回真——starts-with(title,'') 恒真,别用空串当哨兵。
原文集 2.2 还给出 string 对空元素返回空串、对数字原子转十进制字面。布尔 true 转 'true' 小写,不是 True。和 Python 对打打印时不要用语言自己的布尔字面去比 XPath 的字符串。
问题:text() 和 string(.) 在 title 上一样吗?
样本里 title 只有一段直接文本,一样。若 title 里再嵌 span,text() 只取直接孩子文本,string(.) 拼全部后代。抓 HTML 混排书名时用 string 或 normalize-space(.)。
问题:concat 能拼节点集吗?
会先把每个参数拍扁。传入节点集仍只取该参数的第一个节点。不能 concat(//title) 一次拼三本。
四、空白、大小写、以及不要发明正则
抓取失败有一半看起来像「contains 不好使」,其实是文本节点带着换行。normalize-space 把头尾空白去掉、中间连续空白收成一个空格,谓词里几乎应该默认包一层:contains(normalize-space(title),'XML')。书店样本没有缩进问题,所以不包也能中;一换 HTML 立刻翻车。把「样本能中」当成「生产能中」是字符串函数最大的自负。
大小写:contains 区分。Learning XML 对小写 xml 为假。1.0 用 translate 把两边转到小写再比,字母表要写全二十六对,漏一个就漏一次。这土法能应急,维护成本高。真要模糊匹配,把候选节点拉到 Python 用正则或 casefold。不要在路径里堆三层 translate 假装自己有正则引擎。
substring 的第三参数是长度。substring(title,1,8) 在 Everyday Italian 上得到 Everyday,第九个字符是空格被排除。想「从空格切开」用 substring-before 和 substring-after。找不到分隔符时两者都空;starts-with 对空串恒真,所以不要用「before 为空」当「没有空格」的唯一依据——空书名也会让 before 为空。先 string-length,再决定切不切。
concat 不能一次吃整集 title。每个参数先拍扁,节点集参数只取第一项。想把三本书名拼成一句,循环宿主。原文集 2.2 对 string 的节点集规则写得很死,contains 同样吃这套规则。记住口诀:字符串函数的第一个参数如果是节点集,就当它只看见队长。要把函数作用在每一本上,把函数放进 book 的谓词,让每一本自己当上下文。
translate 按字符一一映射,不是词替换。把 - 换成空可以删掉连字符,但不能把 XML 三个字母换成别的词。需要词替换,回宿主,或等 2.0 的 replace。
五、contains 必须放进每一本的谓词
错误:contains(//title,'XML')。1.0 把节点集拍成第一本 Everyday Italian,不含 XML,整句为假,过滤像坏了。正确:book[contains(title,'XML')],每一本自己拿自己的 title 去比,Learning XML 留下。这是 string 偏心纪律在 contains 上的翻版。starts-with 同样。
substring(title,1,5) 在第一本得 Every,下标从 1,第三参是长度。substring(title,0,5) 不要用。normalize-space 对付缩进:HTML 书名两侧换行时,直接相等为假,包一层就真。translate 做大小写要写全字母表。concat 不能一次拼三本书名。空串 starts-with 恒真。title 内嵌 span 时 text() 可能只拿到一段,string(.) 能拼全。
练习:先跑错误的 contains 整集写法,确认结果不像「有 XML 的书」;再改成谓词写法。给某 title 两侧加换行,比较包不包 normalize-space。截第一本前五个字符,确认是 Every 不是 Everyday。这三项分别钉偏心、空白、下标。没有正则就不要在路径里假装有,复杂匹配回宿主。
六、字符串函数看见的是队长不是全队
对整集书名做包含判断,一点零先拍扁第一本,第一本不含关键字,整句为假,看起来像包含坏了。正确是把包含放进每一本书的筛选里,让每本书拿自己的书名去比。截取下标从一起,第三个参数是长度不是结束位置。空白要用规范化压掉,超文本两侧换行会让直接相等失败。大小写敏感,土法翻译字母表要写全,真正则回宿主或等二点零。拼接不能一次吃三本书名,每个参数仍只拍扁队长。空串当前缀判断恒真,别当哨兵。盒子里再套小标签时直接文本可能残缺,拍扁后代才能拼全。口诀:第一个参数若是节点集,就当只看见队长;要作用在每一本上,把函数放进书的方括号。
先跑错误示范:对整集书名做包含关键字。低版本只拍扁第一本,第一本不含关键字,整句为假,看起来像包含坏了。改成每一本书自己拿自己的书名去做包含,带关键字的那本才会留下。截取下标从一起,第三个参数是长度,截第一本前五字应是那五个字不是整个词。两侧加换行后直接相等会失败,先压空白再比。大小写敏感,土法翻译字母表要写全,真正则回宿主。拼接不能一次吃三本书名。空串当前缀判断恒真,别当哨兵。盒子里再套小标签时直接文字可能残缺,拍扁后代才能拼全。口诀:第一个参数若是节点集,就当只看见队长;要作用在每一本上,把函数放进书的方括号。
原文集示范过包含关键字选出学习标记语言那本书名文本,三本里只有它含那三个字母,并且区分大小写,小写三个字母为假。截取第一本书名从一到五得到那五个字母,测长得到十七左右,以你解析后的空白是否进树为准。转换规则写得很死:节点集只转第一个,空集得空串,布尔真变成小写真字,和某些宿主打印出来的大写真不是同一个字。规范化空白把头尾砍掉、中间连续空白收成一个空格,抓取谓词里几乎默认包一层。翻译按字符映射不是按词替换,不能把三个字母换成另一个词。找不到分隔符时前后截取都空,不要用空当前缀判断当否定哨兵。
先跑错误的整集包含,确认结果不像有关键字的书;再改成筛选写法。给某书名两侧加换行,比较包不包压空白。截第一本前五个字,确认是那五个字不是整个词。这三项分别钉偏心、空白、下标。没有正则就不要在路径里假装有,复杂匹配回宿主。转换打在全部书名上只留下第一本,过滤请写书的方括号包含书名。下标从一起,第三个参数是长度。空串当前缀判断恒真。拼接不能一次吃三本书名。盒子里再套小标签时直接文字可能残缺,拍扁后代才能拼全。翻译按字符映射不是按词替换。找不到分隔符时前后截取都空。布尔真变成小写真字,和某些宿主打印的大写真不是同一个字。抓取谓词里几乎默认包一层压空白。
错误整集包含只看见第一本。筛选写法让每一本自己比。换行要用压空白。截取下标从一长度是第三参。无正则回宿主。拼接不能吃整集。空串前缀恒真。套小标签用拍扁。翻译不是按词。找不到分隔符截取为空。真字小写。抓取默认压空白。口诀:节点集参数只看见队长。大小写敏感。测长测的是拍扁后的字。
包含要放进每一本书自己的筛选里,打在整集书名上只看见队长。压空白几乎应当默认包上,样本没有缩进不代表页面没有。
截取第三参数是长度,把结束下标的半开区间想象带过来会少一个字或多一个字。对着第一本书名截五位,心里先写出那五个字再跑,对不上就回去看下标。
关键字过滤的第一原则是让每一本书自己拿自己的书名去比。整集拍扁只看见烹饪那本,关键字在第三本上也会判假,像包含坏了其实是偏心。
动手验收再加一条前缀判断:用「是否以某个词开头」去筛书名时,空串当查找值会让所有书留下,因为它对任何字符串都成立,不能拿来当「没有前缀」的哨兵。找不到分隔符时前后截取都得到空串,看起来像截取函数坏了,其实是分隔符根本不在字里。把空串哨兵和找不到分隔符两行对照写进笔记,后面抓取谓词才不会把恒真条件当成过滤。
要点串联
- contains 放进 book 的谓词:不要对整集 title 调一次
- 下标从 1 起:substring 第三参是长度
- string 偏心第一项:这是纪律不是优化
- normalize-space 对抗缩进:抓取文本几乎必包
- 1.0 无正则:translate 只是字符表,复杂匹配回宿主
- 空串 starts-with 恒真:别当否定哨兵
下一节把价格从字符串变成能加减的数。sum 和 number 用错,总和会 silently 离谱。