2.5 日期时间与序列函数
2.5 日期时间与序列函数
本节摘要:日期类型、
current-date、years-from-duration属于 XPath 2.0。1.0 只有字符串和浮点,没有日期。本节把原文 2.5 与 2.6「其他函数」合并:先认 xs:date / xs:dateTime / xs:duration,再谈序列上的 exists、empty、distinct-values。lxml 默认走 1.0,这些名字多数不可用。
本节导航
阅读完本节,你应当能够:
- 认出 xs:date、xs:time、xs:dateTime、xs:duration 的字面形式
- 判断当前引擎能否调用 current-date 一类函数
- 用 2.0 的 exists / empty 替代「节点集当布尔」的隐式写法
- 把 1.0 做不到的日期计算交给宿主语言
一、书店只有年份数字,没有日期类型
样本里 <year>2005</year> 是四个字符,不是 xs:date。在 1.0 里你只能 number(year)>=2005。不要写 year > xs:date('2005-01-01'),1.0 不认识构造器。
若文档改成 <published>2005-10-27</published>,2.0 引擎可以:
/bookstore/book[xs:date(published) gt xs:date('2005-01-01')]
比较运算符在 2.0 对日期用 gt/lt/eq 更不易和节点集存在量化搅在一起。1.0 只有 > < =,并且会先转数。
原文集列出的类型字面:
- xs:date:
2023-10-27 - xs:time:
14:30:00可带时区+08:00 - xs:dateTime:
2023-10-27T14:30:00,Z 表示 UTC - xs:duration:
P1Y2M一年两个月,PT2H30M两小时三十分 - 子类型 yearMonthDuration、dayTimeDuration 把年月日和时分秒拆开,避免「一个月等于多少天」的糊涂账
二、哪些函数要 2.0 引擎
| 能力 | 1.0 | 2.0+ | 我的选择 |
|---|---|---|---|
| 年数字比较 | number(year)>2004 |
仍可用 | 样本就用这条 |
| 真日期比较 | 无 | xs:date(...) gt ... |
有 Saxon 再用 |
| 当前日期 | 无 | current-date() |
测试要可重复就别依赖「现在」 |
| duration 抽取 | 无 | years-from-duration |
合同期限一类 |
| exists / empty | 用节点集布尔 | 显式函数 | 2.0 代码更可读 |
| distinct-values | 宿主去重 | 2.0 内置 | 作者名去重 |
| 正则 | 无 | matches |
2.0 才有 |
lxml 基于 libxml2,官方承诺是 XPath 1.0。看到教程里的 current-date() 直接抄进 lxml,会得到未知函数错误。Java 默认 XPathFactory 同样是 1.0。要 2.0/3.1 换 Saxon 或类似实现。
⚠️ 常见坑:把 Python 的 datetime 格式写进 XPath 字符串当日期。XPath 2.0 的 date 字面是
xs:date('2005-10-27'),不是'2005/10/27'。斜杠格式要先替换。
💡 关键直觉:样本的 year 是编目号上的印刷年,当数字用。只有字段真的是 ISO 日期,才值得换 2.0 日期类型。
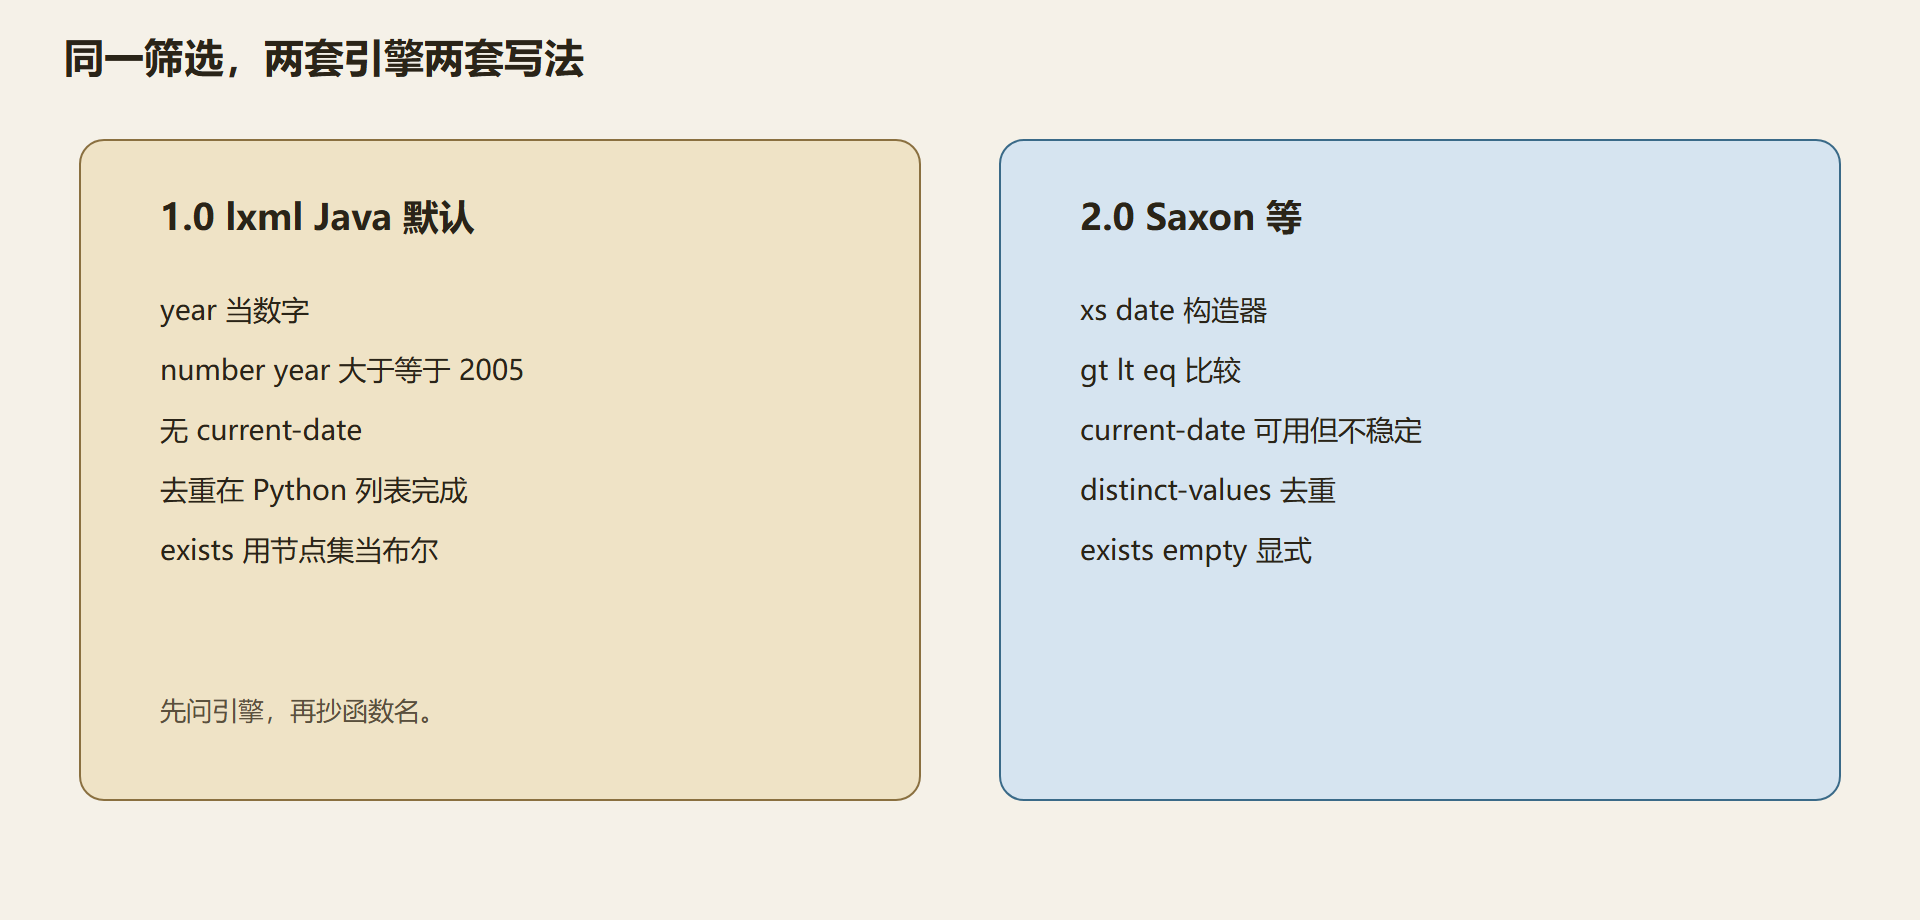
图:1.0 数字年 对 2.0 日期时间轴
三、序列函数:从「其他函数」并入的部分
2.0 把节点集升级成可混合原子值的序列。exists($seq) 非空为真,empty($seq) 相反。distinct-values(//author) 给出不重复的作者字符串。index-of、insert-before、remove、reverse、subsequence 像列表 API。1.0 没有序列这个词,只有节点集,节点集里不能掺裸字符串。
正则 matches、replace、tokenize 也是 2.0。1.0 继续用 contains / translate。不要在 lxml 路径里写 matches(title,'XML')。
时区:dateTime 带 +08:00 与 Z 比较时,2.0 会换算。文档里有的带时区有的不带,规范把无时区当成本地,比较可能报错或按实现宽松处理。工程上统一存 UTC 字面,少混。
current-date() 让同一条查询昨天和今天结果不同,单测会碎。我更倾向把「今天」当外部参数传入(2.0 变量,见第 3 章),而不是在表达式里读时钟。
问题:year 写成 2005 和写成 2005-01-01 能混比吗?
不能指望自动对齐。数字 2005 与日期是不同类型。先约定字段格式,再选函数族。混用是数据建模问题。
问题:duration 的 P 和 T 是什么?
P 起头表示 period。日期部分在 P 后、T 前;时间部分在 T 后。P1DT2H 一天加两小时。漏 T 把小时写在日期位会解析失败。
四、把 2.6 的序列工具放进日期这一节的原因
原文单独开「其他函数」容易写成函数名清单。序列 API 和日期一样,共同前提是 2.0 引擎。放在一起,读者只问一次「我的引擎够不够」。不够,整节可以标成参考,继续用 1.0 的 number 比年份、用宿主去重作者。够,再启用 exists、distinct-values、matches。
distinct-values 对 //author 能去掉重复作者字符串,文档序不保证。要保序去重仍可能要宿主。index-of、subsequence、reverse 像列表方法,用来加工已经拍扁的原子序列,不是用来在树上走路。走路还是轴的事。把序列函数当成「第二套轴」会写出既慢又难读的表达式。
matches 是正则,标志位能忽略大小写,这是 1.0 translate 土法的正经替代。replace、tokenize 一起出现。正则写进路径的可移植性立刻降到「必须 2.0」。对要给 lxml 用户用的库,正则放 Python。对内部 Saxon 管道,matches 可以进谓词。
日期字面必须是 ISO。2005/10/27 不是 xs:date。时区有的节点带、有的不带,比较可能报类型错误。工程上存储统一带 Z 或统一不带,少混。current-date 让同一条查询昨天和今天不同,单测会碎。把「今天」当外部变量传入,第 3 章的变量节就是为这种参数准备的。
duration 的 P 和 T 不能写反。P2H 非法,小时属于时间部分,要 PT2H。P1DT2H 一天加两小时。合同「一个月」用 yearMonthDuration,不要自己用 30 天去乘,闰年和大小月会让你的乘法丢脸。这是类型存在的理由:强迫你选对量纲。
没有 2.0 引擎时,本节的学习目标改成:看见这些函数名能认出「这是 2.0」,而不是会默写。默写了抄进 lxml,只会收获未知函数。
五、年份当数字,日期当类型,两套夹具不要混
书店 year 是 2005、2005、2003。1.0 写 number(year)>=2005 留下前两本。不要写 xs:date 构造器,未知函数或语法错误。把字段改成 2005-10-27 而引擎仍是 1.0,你只能当字符串比,字典序碰巧对 ISO 日期常常能用,但 '2005-10-27' 和 '2005-9-1' 字典序会坑——月份一位数没有补零。这是「没有日期类型时不要赌字符串比日期」的现场。
2.0 引擎上,xs:date(published) gt xs:date('2005-01-01') 按日历比。字面必须 ISO,斜杠分隔要先替换。时区有的带 Z 有的不带,比较可能报错。current-date 让今天和昨天不同,单测把「今天」当参数传入。duration PT2H 不是 P2H。一个月用 yearMonthDuration,不要乘 30 天。
序列函数:exists 代替节点集当布尔的隐式写法,可读性更好,1.0 没有。distinct-values 去重作者,Kick Start 两个名字都会留,与别的书重复的作者会收成一份,顺序不保证。matches 正则忽略大小写是 2.0,lxml 里继续 contains 加 translate 或回 Python。
练习:先在 1.0 用数字年过滤;再假设引擎升级,把同一需求写成日期比较,对照哪些书进出集合。故意把 current-date 抄进 lxml,确认报错信息里有未知函数,把这张截图式错误记成「版本问题」而不是「路径写错」。2.6 并进本节的原因就是让你只问一次引擎够不够。
六、先问引擎再抄日历和序列
样本年份是四个数字,一点零当数字比即可。抄日期构造器会未知函数。字段改成完整日历而引擎仍是一点零,字典序赌月份补零,一位数月份会翻车。二点零按日历比,字面必须标准形式,斜杠分隔要先替换。当前日期让昨天今天不同,单测把今天当参数传入。时间间隔的标记字母不能写反,一个月不要乘三十天。序列去重、存在、正则都是二点零,一点零用节点集当真假、宿主去重、包含加翻译。本节和学习日期放一起,是为了只问一次引擎够不够。不够整节当参考,不要为了当前日期去换整个技术栈。认出这些名字属于二点零,比默写签名重要。
样本年份当四个数字比即可。抄日期构造器进轻量库会未知函数,把这记成版本问题不是路径写错。字段改成完整日历而引擎仍是低版本,字典序赌月份补零,一位数月份会翻车。高版本按日历比,字面必须标准形式。当前日期让昨天今天不同,单测把今天当参数传入。时间间隔标记字母不能写反,一个月不要乘三十天。去重、存在、正则属于序列和高版本,低版本用节点集当真假、宿主去重、包含加翻译。本节和学习日历放一起,是为了只问一次引擎够不够。不够整节当参考。认出这些名字属于高版本,比默写签名重要。
原文集列出日期、时间、日期时间、间隔以及只含年月或只含日时的子类型,间隔字面有的表示一年两个月,有的表示两小时三十分。这些类型是高版本的活。当前日期、从间隔抽年、正则匹配,轻量库多数没有。序列把节点集升级成可混合原子值,去重、查找位置、倒序、切片像列表接口,走路仍用方向不是用列表接口。正则从高版本才有,低版本继续包含和翻译。时区有的带有的不带,比较可能报错,存储统一更少混。没有高版本引擎时本节目标改成认出这些名字,而不是默写进生产路径。
先在低版本用数字年过滤,再假设引擎升级把同一需求写成日历比较,对照哪些书进出集合。故意把当前日期抄进轻量库,确认报错信息里有未知函数,把这张错误记成版本问题而不是路径写错。样本年份当数字用。字段真是标准日历才值得换类型。字面必须标准形式,斜杠分隔要先替换。时区有的带有的不带,比较可能报错,存储统一更少混。当前日期伤害可重复性,把今天当参数传入。间隔标记字母不能写反,一个月不要乘三十天。去重、存在、正则属于高版本,低版本用节点集当真假、宿主去重、包含加翻译。走路仍用方向,不要把序列接口当成第二套方向。没有高版本引擎时本节目标是认出这些名字。二点六并进本节,是为了让你只问一次引擎够不够。
把年份当数字比和把出版日期当日历比,是两种数据模型,不要混在同一条筛选里指望自动对齐。低版本只有前一种。高版本字面必须标准形式,一位数月份没有补零时字典序会骗人。当前日期让同一条查询不可重复,单测把今天当参数。间隔字面日期部分和时间部分中间有标记,漏标记会解析失败。一个月用年月间隔类型,不要乘三十天。去重作者不保证文档序。正则匹配忽略大小写是高版本对翻译土法的替代,可移植性立刻降到必须高版本。轻量库报未知函数时先看名字是不是本节这张表里的,是的话换引擎或回宿主,不要改轴。本节和学习日历放一起,只问一次引擎够不够。
年份数字和日历字面不要混比。轻量库报未知函数时先对本节这张表,对得上就是版本不够,改轴解决不了。
间隔子类型把年月和日时拆开,就是为了避免一个月等于多少天的糊涂账。合同期限用年月间隔,钟表差用日时间隔,量纲选对类型才有意义。
日历字面不允许用斜杠当分隔还指望构造器认出来。先替换成标准形式,再交给类型。一位数月份补零,字典序才不会在低版本里骗人。
动手验收故意把当前日期函数抄进只支持一点零的库,确认报错信息里出现未知函数,把这张报错剪进笔记当版本证据。同一需求在低版本用年份数字比较,升级后才改写成日历比较,两套不要写在同一条筛选里混比。间隔类型把年月和日时拆开,合同期限不要乘三十天去冒充一个月。
一节小结
- 样本 year 当数字:number 比较即可
- 日期类型是 2.0:字面 ISO,比较可用 gt
- lxml / 默认 Java 是 1.0:current-date 会未知
- exists / distinct-values 属序列 API:1.0 用节点集布尔和宿主去重
- 正则从 2.0 才有 matches:1.0 用 contains
- current-date 伤害可重复性:日期当参数传入更稳
下一章处理真实文档里最常让路径变空的原因:命名空间。前缀只是本地贴纸,引擎认的是 URI。