2.4 布尔函数:not 与 lang
2.4 布尔函数:not 与 lang
本节摘要:XPath 1.0 的否定是函数
not(),没有感叹号前缀。boolean()把节点集、字符串、数字收成真假;true()/false()是函数不是关键字。lang()检查 xml:lang 的继承,和@lang='en'不是同一件事——书店样本的 title 带的是普通 lang 属性。
本节导读
阅读完本节,你应当能够:
- 用 not 写出「不是 cooking 类」的书
- 说明空节点集、空串、NaN、0 的布尔值
- 区分 true 函数与字符串 'true'
- 说明 lang 函数走继承,普通属性相等不走继承
一、选出非烹饪类
原文集示范:
/bookstore/book[not(@category='cooking')]
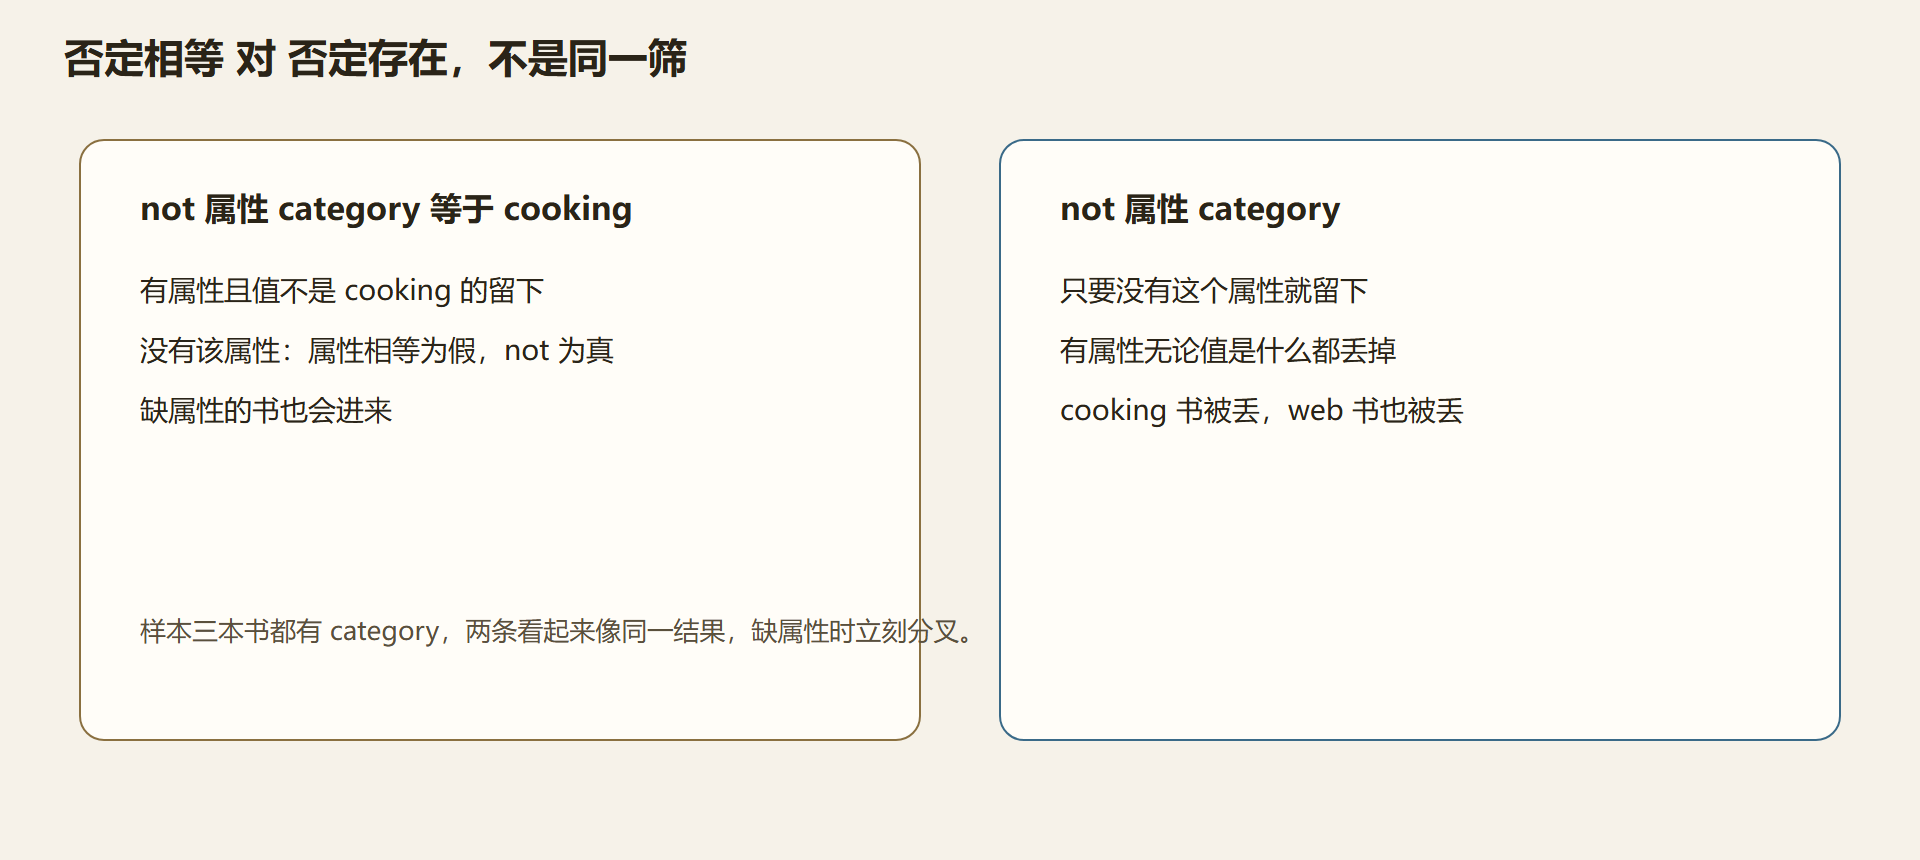
三本里留下 children 与 web。注意比较写在 not 里面:not(@category='cooking')。写成 not(@category)='cooking' 会先把属性节点集做布尔(有 category 则为真),再拿布尔去和字符串比,结果无意义。括号包住要否定的那一整句。
「没有 category 属性」是另一句:book[not(@category)]。存在性的否定,不是相等的否定。两本账必须分开算。
二、boolean 怎么收真假
1.0 转换规则:
| 原值 | boolean | 现场 |
|---|---|---|
| 非空节点集 | 真 | [author] 能留书 |
| 空节点集 | 假 | 没有 author 的书被丢 |
| 非空字符串 | 真 | 包括 'false' 这个字 |
| 空串 | 假 | |
| 非零非 NaN 数字 | 真 | |
| 0 或 NaN | 假 | |
| true / false | 自身 | 由 true() false() 产生 |
字符串 'false' 为真,因为它非空。从 XML 读到文本 "false" 不要直接 boolean(.),要和 'true' 做字符串相等,或在 2.0 用类型构造。
true() 和 false() 带括号,是函数调用。写 true 会被当成名为 true 的 child 元素测试,样本里没有这元素,得到空。这是从通用编程语言迁过来的人最常写错的一行。
⚠️ 常见坑:
not(author='x')在多 author 时,只要存在一个不等于 x 的 author,1.0 的!=语义会让你头疼。否定相等请想清楚是「不存在等于 x 的 author」:not(author='x')其实接近这个存在量化的否定。多值比较用author[.='x']定位到具体文本节点再 not。
💡 关键直觉:谓词里写路径,空则假、有则真。not 包住的是整句比较,不是某一个元素名。
图:两种「不是 cooking」
三、lang 不是 @lang
书店样本是 <title lang="en">,这是普通属性,用 @lang='en'。lang('en') 函数看的是 xml:lang 属性及其在祖先上的继承。HTML 里常见 xml:lang 或 lang 混用,函数只认 xml:lang 那套继承规则。页面抓取用 @lang 或 translate 处理 HTML lang,不要假设 lang() 能读到。
boolean(count(book)) 在有书时为真。其实 boolean(/bookstore/book) 就够,非空节点集已是真。套 count 多一次算术,没必要。
or 与 and 短路与否取决于引擎,不要靠短路做有副作用的事——XPath 函数本就几乎无副作用。可读性上把最便宜的存在性判断放前面:book[author and number(price)>35]。
问题:谓词里写 true() 有用吗?
等于没写。有时生成器为了拼接条件会留下 true() 当占位。手写请删。false() 会让该步清空,等于注释掉这条路径,调试时偶尔当开关。
问题:not(.) 是什么?
当前节点作为节点集非空,boolean 为真,not 为假。谓词 [not(.)] 恒丢。无实际用途,属于笔误。
四、多值比较、短路、以及 lang 的继承链
1.0 的等号对节点集做存在量化:左边任一节点的字符串值等于右边即为真。book[author='Per Bothner'] 能命中 Kick Start,尽管另一位作者不是这个名字。!= 更绕:存在一个不相等就可以为真,几乎所有多作者书都会命中「不等于某某人」。需要「不存在等于 x 的作者」写 not(author='x')。需要「所有作者都等于 x」几乎得 count 与 count 相等来凑,通常回宿主更清晰。多值比较想清楚量词:存在、不存在、全部,三者用的写法不同。
not(@category='cooking') 在缺属性时:属性节点集空,相等为假,not 为真,缺属性的书会进来。not(@category) 才是「没有这张贴纸」。样本三本书都有 category,两条结果碰巧一样,测试必须造一本缺属性的书才能分开。布尔节的表不是理论,是测试夹具需求。
字符串 'false' 非空即为真。从配置文件读到文本 false,boolean(.) 得到真,条件全反。和 'true' 做字符串相等,或在 2.0 用布尔构造。Python 的 True 打印出来和 XPath 的 'true' 也不一样,跨语言比较布尔字面是事故高发区。
lang 函数沿着祖先找 xml:lang,能匹配前缀语言标签,比如文档写 xml:lang=en,lang('en-US') 的匹配规则按规范比普通属性相等宽松。样本 title 上的 lang=en 是普通属性,函数看不见它。HTML 页面两者混用时,先打开树看实际属性名,再决定用 at lang 还是 lang 函数。不要因为函数名叫 lang 就以为它能读所有语言相关属性。
or 与 and 不要靠短路做有副作用的事,XPath 函数几乎无副作用。可读性上把便宜的存在性判断放前面:先问有没有 price,再 number 比较。true() 当生成器占位可以,手写请删。false() 当调试开关会清空该步,用完记得拿掉,否则像路径被注释掉却没有注释。
五、缺属性夹具把两道筛分开
造第四本:有 title 没有 category。not(@category='cooking') 会收进这本,因为相等为假、not 为真。not(@category) 也会收进,因为没有这张贴纸。再看 cooking 那本:第一道筛丢掉它,第二道筛也丢掉它——它有属性。web 那本:第一道筛留下,第二道筛丢掉——它有属性。只有缺属性夹具才能让两道筛的差异出现。样本三本都有 category 时,你以为学会了 not,其实只学会了「非 cooking 值」。
多作者书 author='Per Bothner' 为真(存在量化)。!= 几乎对所有多作者书为真。not(author='Per Bothner') 表示不存在这个作者。Kick Start 有 Bothner,not 为假,书被丢。量词想清楚再写。字符串 'false' 为真。true() 是函数,写成 true 会去找子元素。lang 函数看不见普通 lang 属性。
练习:加上缺属性的书,分别 count 两道筛,记下两个数字。再对 Kick Start 试等号和 not 等号。把 'false' 放进某元素做 boolean(.),确认得到真。这三项分别钉否定存在、存在量化、非空串即真。or 与 and 加括号,不要玩优先级。
六、两道否定筛子必须用缺属性书才能拆开
否定相等在缺属性时为真,因为相等失败。否定存在才是没有这张贴纸。样本本本都有分类时两道筛看起来一样,测试必须造一本缺属性的书。多值等号是存在量化,有一个作者等于目标即为真;不等号更绕,几乎所有多作者书都会命中。不存在某作者要写否定包住相等。非空字符串即为真,文本假也是真,配置里读到假字不要直接当布尔。真与假是函数调用,写成光秃秃的词会去找同名孩子。语言函数认继承链上的专用属性,样本里普通语言属性它看不见。逻辑组合加括号。占位真值手写请删。
造一本没有分类盖章的书。否定相等会收进它,因为相等失败所以否定为真;否定存在也会收进它,因为没有这张贴纸。烹饪那本两道筛都丢掉;网络类那本第一道留下第二道丢掉。只有缺属性夹具才能让两道筛分叉,样本本本都有分类时你以为学会了否定,其实只学会了非某值。多作者时等号是存在量化;不等号更绕。不存在某作者要否定包住相等。文本假字非空即为真,不要直接当布尔。真与假是函数调用,写成光秃秃的词会去找同名孩子。语言函数认继承链上的专用属性,样本里普通语言属性它看不见。逻辑组合加括号。占位真值手写请删。
原文集示范否定掉烹饪类,留下儿童和网络。注意比较写在否定里面,不要先否定一个盖章再去等于某值。没有某盖章是另一句,两本账分开算。转换规则:非空节点集为真,空为假,非空字符串为真包括假这个字,空串为假,非零非非法数字为真,零和非法为假。字符串假为真,因为它非空。真与假带括号是函数,写成光秃秃的词会去找同名孩子。语言函数看专用继承,样本书名上的普通语言属性要用属性相等。或与且不要靠短路做有副作用的事。最便宜的存在性判断放前面。占位真值等于没写,假值会清空该步,调试用完拿掉。
加上缺属性的书之后,分别计数两道否定筛,记下两个数字。再对多作者那本试等号和否定等号。把假这个字放进某元素做布尔转换,确认得到真。这三项分别钉否定存在与否定相等的分叉、存在量化、非空串即真。或与且加括号,不要玩优先级。转换规则要当纪律:非空节点集为真,空为假,非空字符串为真包括假这个字,空串为假,非零非非法数字为真,零和非法为假。真与假是函数调用,写成光秃秃的词会去找同名孩子。语言函数认继承链上的专用属性,样本里普通语言属性要用属性相等,不要因为函数名叫语言就以为它能读所有语言相关盖章。或与且不要靠短路做有副作用的事。最便宜的存在性判断放前面。占位真值等于没写,假值会清空该步,调试用完拿掉。否定要包住整句比较,不要先否定一个名字再去等于。
缺属性夹具让两道否定筛分叉,没有这本夹具就不要声称学会了否定。存在量化让多作者书能被一位目标作者命中。假这个字做布尔是真。真假是函数。语言函数看不见普通语言属性。逻辑加括号。占位真值删掉。否定包住整句。最便宜的存在性放前面。转换纪律当表用:空集假、非空串真、零和非法假。不要靠短路做有副作用的事。样本本本都有分类时两道筛碰巧一样,测试必须造缺属性的书。页面语言属性混用时先看树上实际名字再决定用属性相等还是语言函数。
缺属性那本书是布尔课的必做夹具,没有它两道否定筛分不开。假这个字当布尔是真,跨语言打印布尔字面时不要用宿主自己的真假去比。
多值不等号几乎会让所有多作者书命中,因为它只要存在一个不相等。需要不存在某作者时,用否定包住相等,不要用不等号赌量词。
量词想清楚再写等号和否定。存在一位目标作者、不存在这位作者、全部作者都是这位,三句话对应三套写法,混用会让多作者书神出鬼没。
动手验收把语言函数和普通语言属性拆开跑:样本书名上的语言盖章是普通属性,语言函数看不见它,要用属性相等。页面若真有专用继承链上的语言属性,函数才会认祖先传下来的值。两套写法对着同一本书得到不同真假时,先看树上实际属性名,不要因为函数名叫语言就以为它能读所有语言相关盖章。再造一本没有分类的书,分别计数否定相等和否定存在,两个数字必须能分叉,分不开就说明夹具还没造出来。
要点速记
- 否定是 not 函数:没有感叹号运算符
- not 要包住整句比较:不要 not 一个元素名再去等于
- 否定相等 ≠ 否定存在:缺属性时分叉
- 'false' 字符串为真:非空即真
- true() 是函数:写成 true 会去找子元素
- lang 函数认 xml:lang 继承:样本里的 lang 是普通属性
下一节进入 2.0 领地:日期、duration,以及原文「其他函数」里的序列操作。1.0 引擎会报未知函数,先确认再写。