第2章 · 微调理论与实践
第 2 章 · 微调理论与实践
章节摘要:本章是微调的"正课"。先用迁移学习讲清"为什么微调能生效",再给微调策略的完整地图(全量微调、LoRA、PEFT 等),接着讲不同模型(BERT 类、GPT 类、多模态)怎么微调,最后讲微调路上绕不开的问题与挑战。学完本章,你能为项目选对微调方案。
本节导航
阅读完本章,你应当能够:
- 解释迁移学习为什么让微调生效
- 对比全量微调、LoRA、PEFT 等策略
- 按模型类型选择微调方式
- 预见并缓解微调的常见问题
- 独立设计一个微调方案
核心概念速览
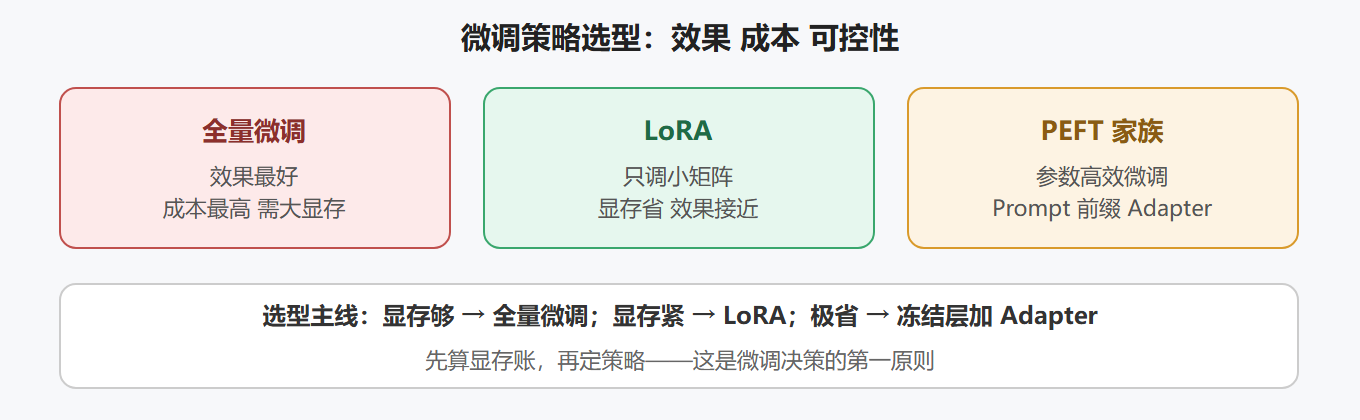
一句话记住本章:微调策略 = 在"效果、成本、可控性"三者间做取舍——全量最强最贵,LoRA 轻量够用,PEFT 是平衡点。
微调决策流程
子章节导航
2.1 迁移学习理论基础
迁移学习是什么、为什么微调能"少量数据生效"。
2.2 微调策略详解
全量微调、冻结层、LoRA、PEFT 的对比与选型。
2.3 不同类型模型的微调
BERT 类、GPT 类、多模态模型的微调差异。
2.4 微调的问题与挑战
灾难性遗忘、过拟合、成本、评估难题与对策。
子章节之间的逻辑关系
为什么生效(2.1) → 怎么选策略(2.2) → 不同模型怎么做(2.3) → 会遇到什么(2.4) 理论 方法 实操 排坑
从原理到选型再到实操与排坑,四节构成微调方案的完整设计流程。
前置知识与后续延伸
- 前置:第 1 章的训练机制与微调概述
- 为后续铺垫:第 3 章参数训练深入是本章策略的细节展开;第 4 章案例直接应用本章方案
本章学习建议
微调策略是本教程的核心章节。学习时请带着两个选型问题:我的任务适合全量微调还是参数高效微调?学习率应该比预训练时大还是小?建议把 2.2 的几种微调策略整理成对比表,并动手跑一个最简单的文本分类微调实验,亲眼观察不同学习率下验证集损失的变化曲线。
评论区
(0)
U