2.1 迁移学习理论基础
2.1 迁移学习理论基础
本节摘要:微调之所以"少量数据也有效",理论根基是迁移学习。本节讲清迁移学习是什么、为什么能生效(知识共享)、三个关键问题(迁移什么、怎么迁移、何时迁移),以及它在微调场景的落地形式。
核心问题
阅读完本节,你应当能够:
- 用自己的话说出迁移学习
- 解释迁移学习为什么能生效
- 说清迁移学习的三个关键问题
- 理解"负迁移"的风险
- 把迁移学习与微调对应起来
一、问题与直觉
一个会开轿车的人,学开卡车会快很多——因为他已经掌握了"驾驶"的通用技能。迁移学习就是这个道理:模型在一个任务上学到的知识,搬到相关任务上复用。微调之所以"少量数据也有效",正是因为预训练模型已经掌握语言/视觉的通用知识,你只需让它"适应新任务"。
二、核心原理
2.1 迁移学习是什么
迁移学习可以画成"开车技能"的类比:
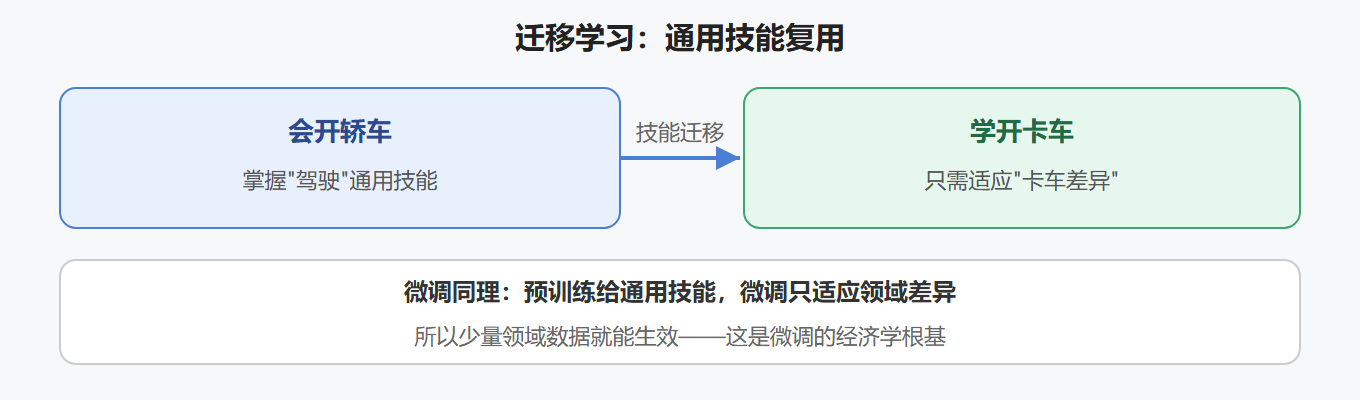
从"源任务"学到通用知识,迁移到"目标任务"上适配——这就是迁移学习的完整闭环。
2.2 为什么能生效
预训练模型在训练时"见多识广",参数里沉淀了通用规律:语言的语法语义、图像的边缘形状。这些规律与具体任务无关,可以直接复用。微调时只需小幅调整"任务相关"的部分,所以数据需求大幅降低。
2.3 三个关键问题
| 问题 | 微调中的答案 |
|---|---|
| 迁移什么 | 模型参数中的通用知识 |
| 怎么迁移 | 继续训练(微调) |
| 何时迁移 | 任务相关且目标域数据少 |
💡 关键直觉:迁移学习成功的前提是"源任务与目标任务相关"。用文本预训练模型去微调图像任务,迁移的知识就不匹配——相关度决定迁移质量。
2.4 负迁移:迁移的反面
当源任务与目标任务不相关时,迁移不但无益反而有害,叫"负迁移"。表现:迁移后的效果比从零开始还差。微调场景里,选错预训练模型(如用通用模型微调专业领域而通用模型里没有该领域知识)就是常见诱因。
三、工程实践要点
3.1 迁移学习在微调中的三种形式
| 形式 | 做法 | 场景 |
|---|---|---|
| 特征提取 | 冻结模型只训新头 | 数据极少 |
| 微调 | 全模型小学习率训练 | 数据中等 |
| 逐步解冻 | 从顶层开始逐层放开 | 平衡效果与遗忘 |
3.2 选预训练模型的判断标准
- 领域相关度:领域越接近,迁移越有效
- 数据规模:预训练数据越广,通用性越强
- 模型规模:与你的显存预算匹配
⚠️ 常见坑:盲目用"最强"模型。参数更大的模型不一定更好迁移,还要看领域匹配与显存预算——先算账再选模型。
3.3 迁移效果的验证
迁移有没有用,用数据说话:对比"从零训练"与"迁移微调"在验证集上的表现。迁移有效时,微调会收敛更快、最终效果更好——这是判断迁移质量的硬指标。
3.4 动手:加载预训练模型做特征提取
用 Hugging Face 生态两行代码就能拿到一个预训练模型,这本身就是"迁移"的第一步——你继承的是别人在海量数据上训练出的参数:
from transformers import AutoModel, AutoTokenizer tokenizer = AutoTokenizer.from_pretrained("bert-base-chinese") model = AutoModel.from_pretrained("bert-base-chinese") # 特征提取模式:冻结全部参数,只把输出当特征用 for param in model.parameters(): param.requires_grad = False texts = ["微调是迁移学习的落地形式"] inputs = tokenizer(texts, return_tensors="pt", padding=True) with torch.no_grad(): features = model(**inputs).last_hidden_state
AutoModel.from_pretrained 会自动下载权重并重建网络结构——这就是"站在巨人肩膀上"的代码形态。把 requires_grad 设为 False 就是特征提取(3.1 表里的第一种形式);设为 True 并用小学习率继续训练,就是标准微调。两行代码的区别,正是本章三种迁移形式的全部差异。
重点提炼
- 要点一:迁移学习 = 复用源任务知识到目标任务
- 要点二:微调生效靠的是预训练模型的通用知识
- 要点三:三个关键问题——迁移什么、怎么迁、何时迁
- 要点四:相关度决定迁移质量,不相关会负迁移
- 要点五:三种形式——特征提取、微调、逐步解冻
- 要点六:迁移是否有效,用"收敛速度与最终效果"验证
理论清楚了,下一节进入策略——全量微调、LoRA、PEFT 怎么选。