6.2 统计分析与机器学习
6.2 统计分析与机器学习
Julia 数据栈三件套:DataFrames 管表格、StatsBase 与 Statistics 管统计、Flux 管神经网络。本节从一张表一路做到一个小模型,全程可复现。
DataFrames:从建表到分组聚合
] add DataFrames StatsBase Flux using DataFrames df = DataFrame( city = ["北京", "上海", "北京", "上海", "北京"], month = [1, 1, 2, 2, 2], pm25 = [82, 61, 95, 70, 88], ) # 取列、筛选、排序 df.pm25 filter(:city => ==("北京"), df) sort(df, :pm25, rev = true) # 分组聚合:每个城市每月均值 combine(groupby(df, [:city, :month]), :pm25 => mean => :avg_pm25)
Pandas 用户的迁移对照
| 操作 | Pandas | DataFrames.jl |
|---|---|---|
| 筛选行 | df[df.city=="北京"] |
filter(:city => ==("北京"), df) |
| 分组聚合 | df.groupby("city").mean() |
combine(groupby(df, :city), :pm25 => mean) |
| 新增列 | df["ratio"]=... |
df.ratio = df.pm25 ./ 100 |
| 缺失处理 | dropna |
dropmissing(df, :pm25) |
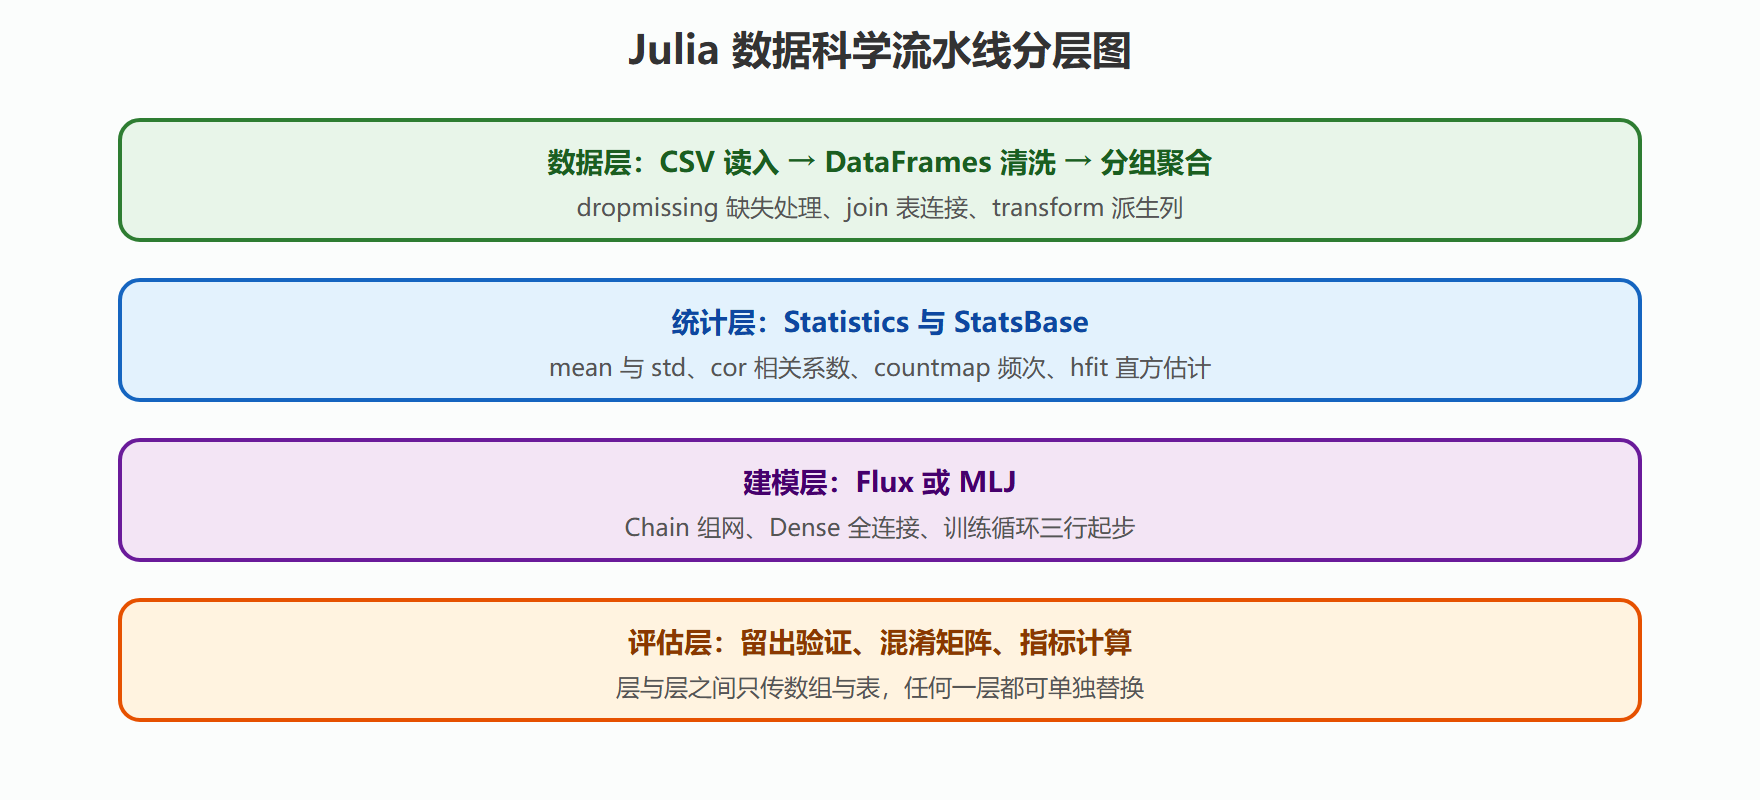
表格到预测的工作流分层
统计三行起步
using Statistics, StatsBase x = randn(1000) mean(x), std(x), median(x) cor(x, x .^ 2) # 相关系数 countmap(rand(1:4, 100)) # 频次统计
Flux:二十行训一个分类器
用两个正态分布造数据,训一个小网络分开它们:
using Flux, Statistics # 造数据:两类二维点 X = hcat(randn(2, 200), randn(2, 200) .+ 2.0) # 2 x 400 输入 y = vcat(zeros(Int, 200) , ones(Int, 200)) # 标签 model = Chain( Dense(2, 8, relu), Dense(8, 2), ) loss(m) = Flux.logitcrossentropy(m(X), Flux.onehotbatch(y, 0:1)) opt = Descent(0.1) for epoch in 1:200 Flux.train!(loss, params(model), [(X,)], opt) end accuracy = mean(Flux.onecold(model(X)) .- 1 .== y) # 约 0.95 以上
Flux 的哲学是"Julia 代码即模型":网络是普通函数、训练循环是普通循环、损失是普通函数。没有 Session、没有特殊的 DSL,第 3 章的函数知识全部直接适用。
⚠️ 常见坑:忘记
onehotbatch直接把整数标签喂给交叉熵,报错信息晦涩。Flux 的分类损失默认要 one-hot 标签;嫌麻烦可换Flux.Losses.logitcrossentropy配合onecold的组合并自己写转换。
模型选择上我的建议:结构标准(全连接、CNN)用 Flux 足够;要对比几十种现成模型选最优,看 MLJ——它是 Julia 版的 sklearn 接口聚合层。
案例:一份脏数据的完整清洗流水线
背景:拿到三个月的站点监测表,混杂缺失值、异常高的离群点和重复行,目标是产出"每站点周均值"的干净表。第一步建样本并暴露问题:
using DataFrames, Statistics raw = DataFrame( site = ["A", "A", "B", "B", "A"], week = [1, 1, 1, 2, 2], value = [10.0, missing, 990.0, 12.5, 11.0], )
第二步,三连清洗:去重、按业务规则截离群、处理缺失:
clean = unique(raw, [:site, :week]) # 重复键先去掉 clean = filter(:value => <(100), clean) # 990 是传感器故障值 clean = coalesce.(clean.value, missing) # 缺失保持显式 weekly = combine(groupby(clean, [:site]), :value => (x -> mean(skipmissing(x))) => :week_avg) # 2 行干净结果:A→10.5,B→12.5
解读:清洗顺序讲究——先去重再截离群(否则重复的故障值影响统计)、最后聚合时用 skipmissing 而不是 dropmissing 整行丢弃(保住其他列的信息)。变式:把阈值 100 换成按站点的四分位距规则,流水线结构不变、只换谓词函数,这正是 3.1 高阶函数思想在数据清洗里的兑现。
Flux 训练排错实录
新手在 Flux 上翻车的位置很集中,按频率记录。第一位:标签形态错——logitcrossentropy 要 one-hot 矩阵而给了一维整数向量,报错却在损失内部深处;先 Flux.onehotbatch 再进损失。第二位:学习率过大——Descent(0.5) 起步导致损失变 NaN,降到 0.1 或换 Adam() 默认参数最稳。第三位:忘了 params(model)——train! 的第二个参数是参数集合,漏写或传错对象则训练空转、损失纹丝不动。第四位:数据矩阵方向搞反——Flux 约定"特征 × 样本",从 Python 生态迁来的人习惯相反,用 size(X) 先确认第一维是特征数。逐条对号入座后,二十行训练脚本的调试时间能从半天压到十分钟。
本节要点回顾
- DataFrames 的
filter / groupby / combine / transform四招覆盖 90% 表格操作; - 统计先看标准库 Statistics,频次与直方在 StatsBase;
- Flux 三要素:
Chain组网、损失函数、train!循环,全是普通 Julia 代码; - 分类标签要 one-hot,预测结果用
onecold转回类别; - 模型比选交给 MLJ,自建结构用 Flux。