8.2 集成测试与切片测试
8.2 集成测试与切片测试
本节摘要:测试策略的核心矛盾是真实性与速度。全量启动最真实也最慢,切片测试只装配需要的层。本节给出三类测试的作用域与启动成本,讲测试数据的三种来源选择与事务回滚技巧,让旅程的每一层都有匹配的验证深度。
三类测试的深浅
// 切片:只装配 Web 层,秒级 @WebMvcTest(OrderController.class) class WebSliceTest { ... } // 切片:只装配数据层,可连真实数据库 @DataJpaTest class RepositorySliceTest { @Autowired OrderRepository repo; @Test void findByStatus_sorted() { repo.save(new Order("paid")); assertThat(repo.findByStatus("paid")).hasSize(1); } } // 集成:整个应用上下文,含内嵌中间件 @SpringBootTest(webEnvironment = SpringBootTest.WebEnvironment.RANDOM_PORT) class FullJourneyTest { @Autowired TestRestTemplate http; @Test void orderFlow_endToEnd() { var resp = http.postForEntity("/api/orders", new OrderCmd("u1"), OrderVO.class); assertThat(resp.getStatusCode().is2xxSuccessful()).isTrue(); } }
成本与真实性一目了然:
| 类型 | 装配范围 | 典型耗时 | 擅长验证 |
|---|---|---|---|
| Web 切片 | 过滤器到控制器 | 秒级 | 路由、绑定、安全 |
| 数据切片 | 实体与仓储 | 秒级起 | 查询语义、映射 |
| 完整集成 | 全部 Bean 加中间件 | 十秒级 | 旅程全程协作 |
策略上金字塔依旧成立:大量切片测各层,少量集成测关键流程(下单、支付这类一错就赔钱的路径),集成测试不是越多越好——它们慢、脆,失败定位也模糊。
测试数据与隔离
数据切片默认在内存库执行、事务自动回滚,每个测试拿到干净库。集成测试面对真实中间件时,隔离要自己设计,常用三招:
- 随机端口加专用库:每个构建用独立数据库名,物理隔离
- 事务回滚:测试方法纳入事务,结束回滚,痕迹归零
- 显式清理:
@AfterEach删测试造的数据,简单但要列全
@SpringBootTest @Transactional // 结束自动回滚 class LedgerFlowTest { @Autowired CheckoutService checkout; @Test void checkout_createsAllRecords() { checkout.checkout(1L, TestCart.oneItem()); assertThat(ledgerRepo.count()).isEqualTo(1); // 验证完即回滚 } }
图 8-2 测试金字塔与各层对应的旅程区段
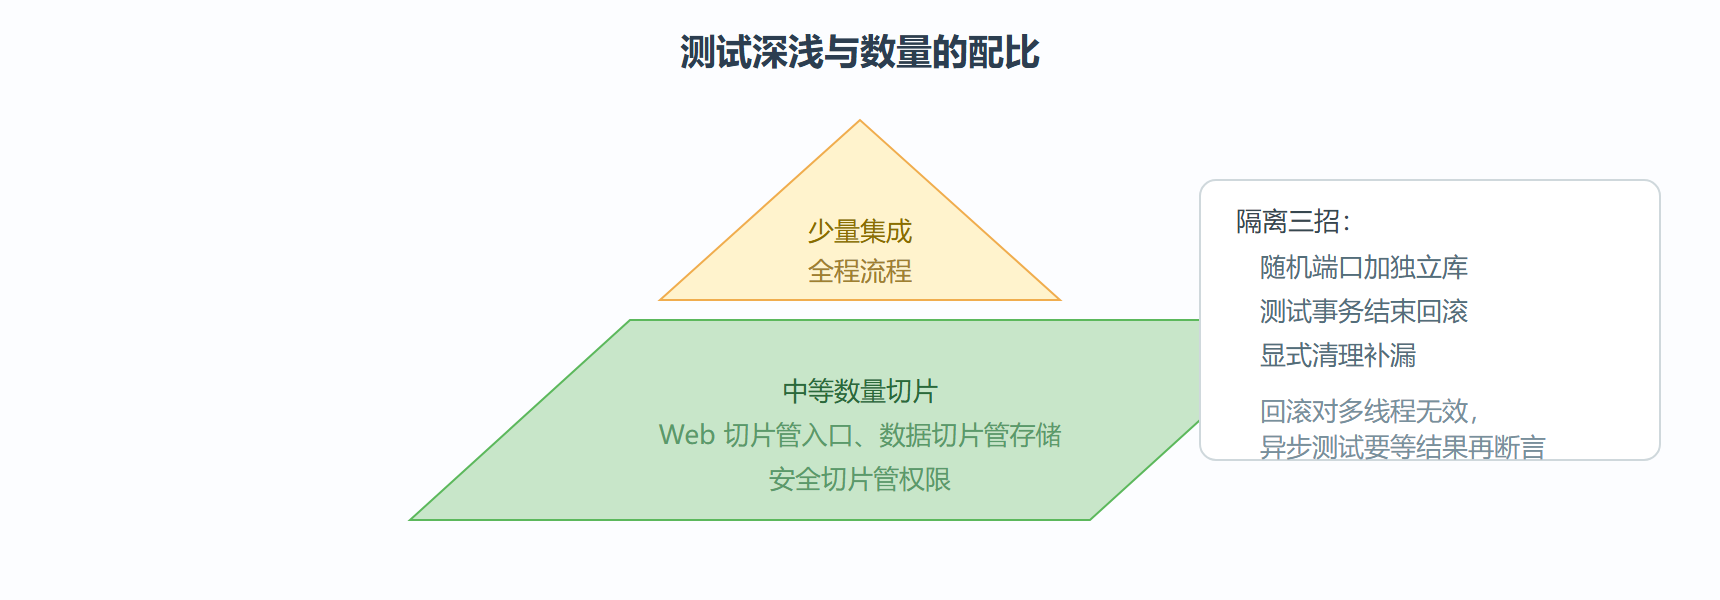
⚠️ 事务回滚对异步路径无效:7.1 节的
@Async方法在另一条线程用自己的连接,测试事务回滚管不到它的写入。异步流程的测试要么等结果落库后显式清理,要么交给专门的集成环境。
实战:把一个慢测试套件提速十倍
背景:接手的项目有两百个测试全部用完整集成注解,单次跑二十五分钟,没人愿意在提交前跑测试。操作分三步。第一步,盘点:按测试内容分类——只测控制器翻译的有九十个,只测仓储查询的有七十个,真正需要全程的四十个。第二步,降级:前两类分别改成 Web 切片与数据切片注解,替身替换掉不需要的真实依赖。第三步,保留:关键资金流程的四十个集成测试原样保留,配独立测试库与随机端口。
结果:总耗时从二十五分钟降到三分钟以内。解读:提速的关键不是删测试而是缩小装配范围——切片测试装配的 Bean 数量是个位数,集成测试是数百个,成本差主要在启动。变式一:数据切片默认用内存库,若担心与生产库方言差异,可用注解换成测试容器提供的真实数据库实例,速度略降但语义更真。变式二:给异步路径的测试补显式等待——用轮询工具等待积分记录落库再断言,正好覆盖上文回滚失效的坑。
测试策略的两条经验
其一,测试也要防"腐烂":断言写得越具体越脆,字段一改全红;经验是状态码与关键业务字段精确断言,其余结构做存在性断言,红得有理由的测试才会被认真对待。其二,共享上下文是隐形耦合:多个测试类复用同一个应用上下文能提速,但任何一个类改了配置都会波及他人,慢而独立与快而共享之间,倾向给关键流程独立上下文。测试代码与业务代码同权重评审,这一条写进规范,测试套件才不会在两年后变成没人敢动的雷区。
本节要点回顾
- 三类测试对应旅程三段:入口切片、存储切片、全程集成
- 金字塔配比:切片多而快,集成少而关键
- 隔离首选事务回滚,辅以独立库与显式清理
- 异步路径回滚失效,测试里要显式等待与清理
读完自测
三问收束:提速改造的第一步为什么是盘点而不是删测试;事务回滚策略对异步路径为何失效;金字塔配比里集成测试为什么"不是越多越好"。第三问答出"慢、脆、定位模糊"三个词,策略意识就到位了。
最后提醒一个度量误区:测试覆盖率数字本身不是目标,覆盖的层次分布才是——入口层、业务层、数据层各有测试护住,比单层覆盖率冲到高位更有价值。评审测试时多问一句这条关键旅程有没有集成测试兜底,少看一眼总覆盖率。
再补一个层次与速度之外的维度:可读性。三个月后回看,测试名就是最好的文档——用"场景加预期"的方式命名(下单成功后库存应减少),失败清单本身就是一份系统行为说明,比任何注释都常新。
还有一个实践顺序建议:新项目从第一天就按三类测试分层搭骨架,比老项目补测试容易得多——先立结构再填用例,成本最低;反之在两百个全量集成测试里做拆分,就是本节实战案例里那场费时费力还容易出错的手术。分层这件事,越早越便宜。