6.3 微生物与环境代谢组学
6.3 微生物与环境代谢组学
微生物代谢组学的核心问题是互作:菌群与宿主、菌群与菌群、生物与非生物环境。代谢物是这些对话的化学语言——短链脂肪酸、吲哚衍生物、吩嗪类、硫代谢物,都是跨物种信号分子。
宿主-菌群互作:把谁放在哪个格子里
研究互作的标准做法是交叉设计:无菌动物定植不同菌株、体外共培养体系、菌株突变体的代谢表型对比。比如色氨酸路线:宿主食入色氨酸 → 部分被菌群转化为吲哚及其衍生物 → 吲哚经肝脏硫酸化 → 调节芳烃受体与屏障功能。要证明"某个代谢物是菌群产的",至少要三格对比:
定植普通小鼠(有菌) vs 无菌小鼠 → 差异来自菌群 无菌鼠 + 目标菌株回补 vs 无菌鼠 + 突变株 → 差异锁定到该菌的某条通路 体外培养上清 vs 空白培养基 → 排除培养基本底
环境代谢组学版的三格对照同样严谨:污染场地 vs 参考点、暴露梯度样带、实验室微宇宙(microcosm)加标回收。核心思想一致:代谢物差异必须能归因,而不是停留在"两地不同"。
环境应用三例
水体富营养化:湖泊不同水层的溶解性有机碳与藻类毒素(微囊藻素的靶向 LC-MS/MS 监测)绘制"水华化学画像",预警比细胞计数提前数天。
土壤健康:土壤提取物代谢谱与酶活性指标结合,评估有机农业与常规耕作下的微生物功能差异——代谢组学在这里提供"功能正在发生"的证据,与 16S 测序的"谁在场"互补。
生物修复:降解菌群处理污染土壤前后 的代谢足迹(中间降解产物出现又消失)是判断降解通路真的在运转的证据链。
环境微生物样品的特有麻烦
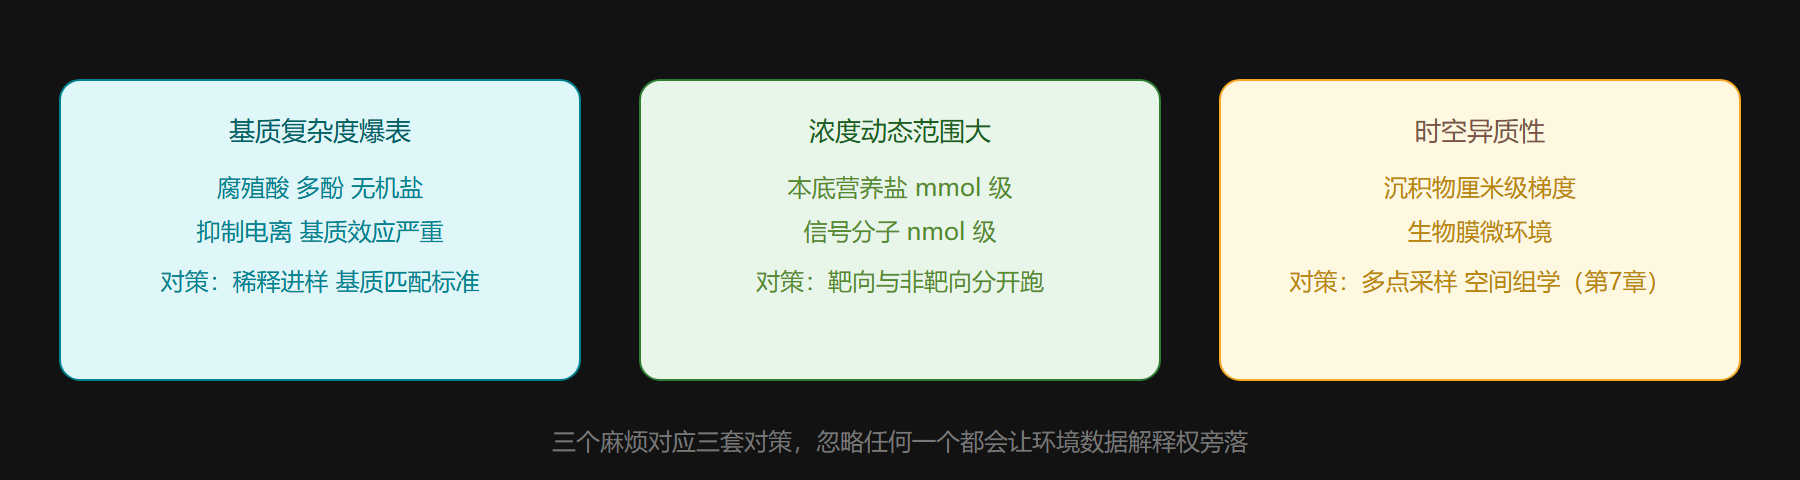
⚠️ 常见坑:体外实验忘了采"空白培养基对照"。培养基里的酵母提取物本身就带大量代谢物,不扣本底,所谓"菌株代谢物"一半是培养基成分。
本节要点回顾
- 互作研究靠交叉对照:有菌/无菌/回补/突变 四格把差异归因到具体通路
- 环境版三格对照:点位、梯度、微宇宙,归因逻辑同源
- 环境样品三大麻烦:基质效应、动态范围、时空异质性,各有对策
- 培养基本底必须扣,体外实验的第一课
- 代谢组学与 16S 互补:"谁在场"与"在干什么"
第 7 章看这条技术路线正在往哪里走。
从共培养到环境:代谢组学的"化学对话"视角
微生物代谢组学的核心发现之一是代谢交叉喂养(cross-feeding):大肠杆菌释放的丙氨酸被肠道拟杆菌摄取、拟杆菌产生的琥珀酸反过来供养别的类群——胞外代谢组(exometabolome)因此成为菌群互作的直接语言。环境方向上,海洋代谢组学用非靶向 LC-MS 对海水溶解有机物(DOM)做分子式级统计,发现数万种分子式中跨越洋盆仍稳定的" refractory 骨架",为碳循环模型提供了分子级约束。
| 场景 | 平台 | 关键发现/用途 | 规模 |
|---|---|---|---|
| 肠道菌群-宿主轴 | LC-MS 靶向 | 短链脂肪酸、吲哚衍生物 | 每研究 10² 代谢物 |
| 共培养互作 | 胞外代谢组 | 交叉喂养网络 | 双物种 10³ 峰 |
| 海洋 DOM | FT-ICR MS | 分子式空间 | 每样 10⁴ 分子式 |
| 土壤/根际 | GC×GC-MS | 根分泌物谱 | 10²–10³ 化合物 |
| 毒理生态 | 非靶向 | 生物标志物响应 | 模式生物 |
胞外代谢组的差集分析:谁吃掉了什么
# 共培养上清 vs 单培养上清的峰面积(截选 5 个峰,示意) peaks = ["丙氨酸", "琥珀酸", "葡萄糖", "吲哚", "甲酸盐"] mono_ecoli = [1.00, 0.20, 0.85, 0.10, 0.40] # 大肠杆菌单培养 mono_bact = [0.05, 0.90, 0.05, 0.60, 0.30] # 拟杆菌单培养 co_culture = [0.15, 0.35, 0.80, 0.55, 0.50] # 共培养 for i, name in enumerate(peaks): consumed = co_culture[i] < min(mono_ecoli[i], mono_bact[i]) * 0.6 released = co_culture[i] > max(mono_ecoli[i], mono_bact[i]) * 1.2 tag = "被消耗" if consumed else ("新生成" if released else "—") print(f"{name}: 共培养 {co_culture[i]:.2f} vs 单培养 " f"{mono_ecoli[i]:.2f}/{mono_bact[i]:.2f} → {tag}") # 丙氨酸、琥珀酸在共培养中显著低于两单培养 → 交叉喂养的直接证据
环境与微生物方向的共同方法论是"把代谢物当代际语言读":浓度差集指认谁生产谁消费,时空梯度指认过程速率,分子式空间统计指认来源与归宿。与临床方向相比,这里的挑战不是混杂控制而是注释空白——海水 DOM 里 90% 以上分子式无结构注释,统计只能在"分子式空间"进行,这也是 FT-ICR 与数据科学融合最深的领域。
环境样本的质控还有特殊一关:盐与腐殖质的基质效应。海水样品脱盐(固相萃取)与土壤提取物的净化步骤若不统一,跨研究比较失去意义;同位素内标在环境基质中的回收率波动也更大,允收窗通常放宽到 50–150%。方法学透明在环境方向尤其重要——基质效应的校正方法写清楚,数据才能进入全球比对数据库。
这个方向还有一个正在成型的应用窗口:发酵食品与工业生物制造。酿造与乳品发酵的过程控制直接依赖代谢物轨迹(乙醇、有机酸、风味酯的时间曲线),在线或旁线质谱把"老师傅的鼻子"数字化为过程分析技术;合成生物学的菌株筛选也用胞外代谢组通量做高产表型的早筛。工业场景的资金与数据体量给这个分支注入了工程化的节奏,与学术研究形成方法回流——本章工具箱里的差集分析与轨迹建模,多数都在工业场景里先被打磨成熟。
环境样本的定量基线也值得记录:海水溶解有机物中约 70% 的提取重量集中在 200–600 Da 区间,而现有标准品库能定量的不足其中的 5%,这意味着环境代谢组学的注释放率天然偏低,报告中应明确标注"未注释特征的占比"而非只罗列鉴定清单。跨境比对时,把内标回收率、提取效率与仪器漂移三项指标同步发布,是数据集可复用的最低门槛。