2.1 整体架构设计
2.1 整体架构设计
本节摘要:Doris 的整体架构可以压缩成一句话:控制平面与数据平面分离,元数据走 Raft 式复制组,数据按 Tablet 散布在无共享的 BE 集群上,查询计划被切分成并行片段同时下发。本节从 MPP 执行模型讲到元数据服务机制,再到三方协同的全景图,为后面两节的深度拆解铺设框架。
本节能力目标
阅读完本节,你应当能够:
- 解释 Shared-Nothing 与存算分离两种形态下,故障域有什么不同;
- 描述一条查询在 FE 与 BE 之间的完整往返路径;
- 说明元数据的写入为什么必须经过 Master、读却可以从任意 FE 走;
- 指出集群扩容时哪些动作发生在 FE、哪些发生在 BE。
一、MPP 之行:把一台集群当成一台机器用
分析查询的规模化难题在于"数据太大而算力太散"。MPP(大规模并行处理)的回答是把两个东西同时对齐:将逻辑表横向切成成千上万个 Tablet 物理分散到各节点;把 SQL 编译成的执行计划纵向切分成多个 Fragment(片段),每个片段对应一段算子流水线。调度时,FE 把Fragment 实例分发到持有相关数据分片的 BE 上并行执行,各实例只扫本地数据——这就是"计算找数据"而不是"数据找计算",网络传输量因此从全表规模降到聚合中间结果规模。
一个常被忽略的细节是数据倾斜在这个模型里的放大效应:Tablet 是调度的最小单位,某个热点分桶一旦过大,所有并行度调整都救不了那一个拖后腿的实例。这也提前预告了第 3 章的结论——分桶键的选择本质上是在给 MPP 划定公平的起跑线。
两阶段聚合是这个模型的另一块基石。局部节点先做预聚合(partial aggregation),把数亿行压成数十万行中间结果再走网络;最终归并阶段在同一批节点或另一层完成。你看执行计划时看到的 HASH_PARTITIONED 交换、AGGREGATE 出现两次,都是它的痕迹。
二、元数据之锚:轻量高可用的服务机制
FE 集群内部是一个以 BDB JE(Berkeley DB Java Edition)为底的复制组,典型配置为三 Follower。写入操作(建表、导入登记、副本变更)只能由 Master 执行并序列化进日志,其余 Follower 回放日志保持一致;Leader 通过选举产生,宕机后秒级自动切换。Observer 角色订阅同样的数据流但不参与投票,专门用来横向扩展查询入口的承载能力。
这个设计的两个推论值得记住:
- 读元数据可以在任意 FE,写必须经 Master。业务连接串里写一串 FE 地址做负载均衡是常见做法,但要意识到收到 DDL 的那个 FE 若不是 Master,会内部转发。
- 元数据不存数据本身。FE 记录的是库表结构、分区范围、每个 Tablet 的三副本位置。数据文件的生命周期由 BE 直接管理并向 FE 上报心跳,所以即使 BE 短暂失联,已提交的查询不受影响。
图 2-1:核心组件协同全景——一次导入与一次查询的对账
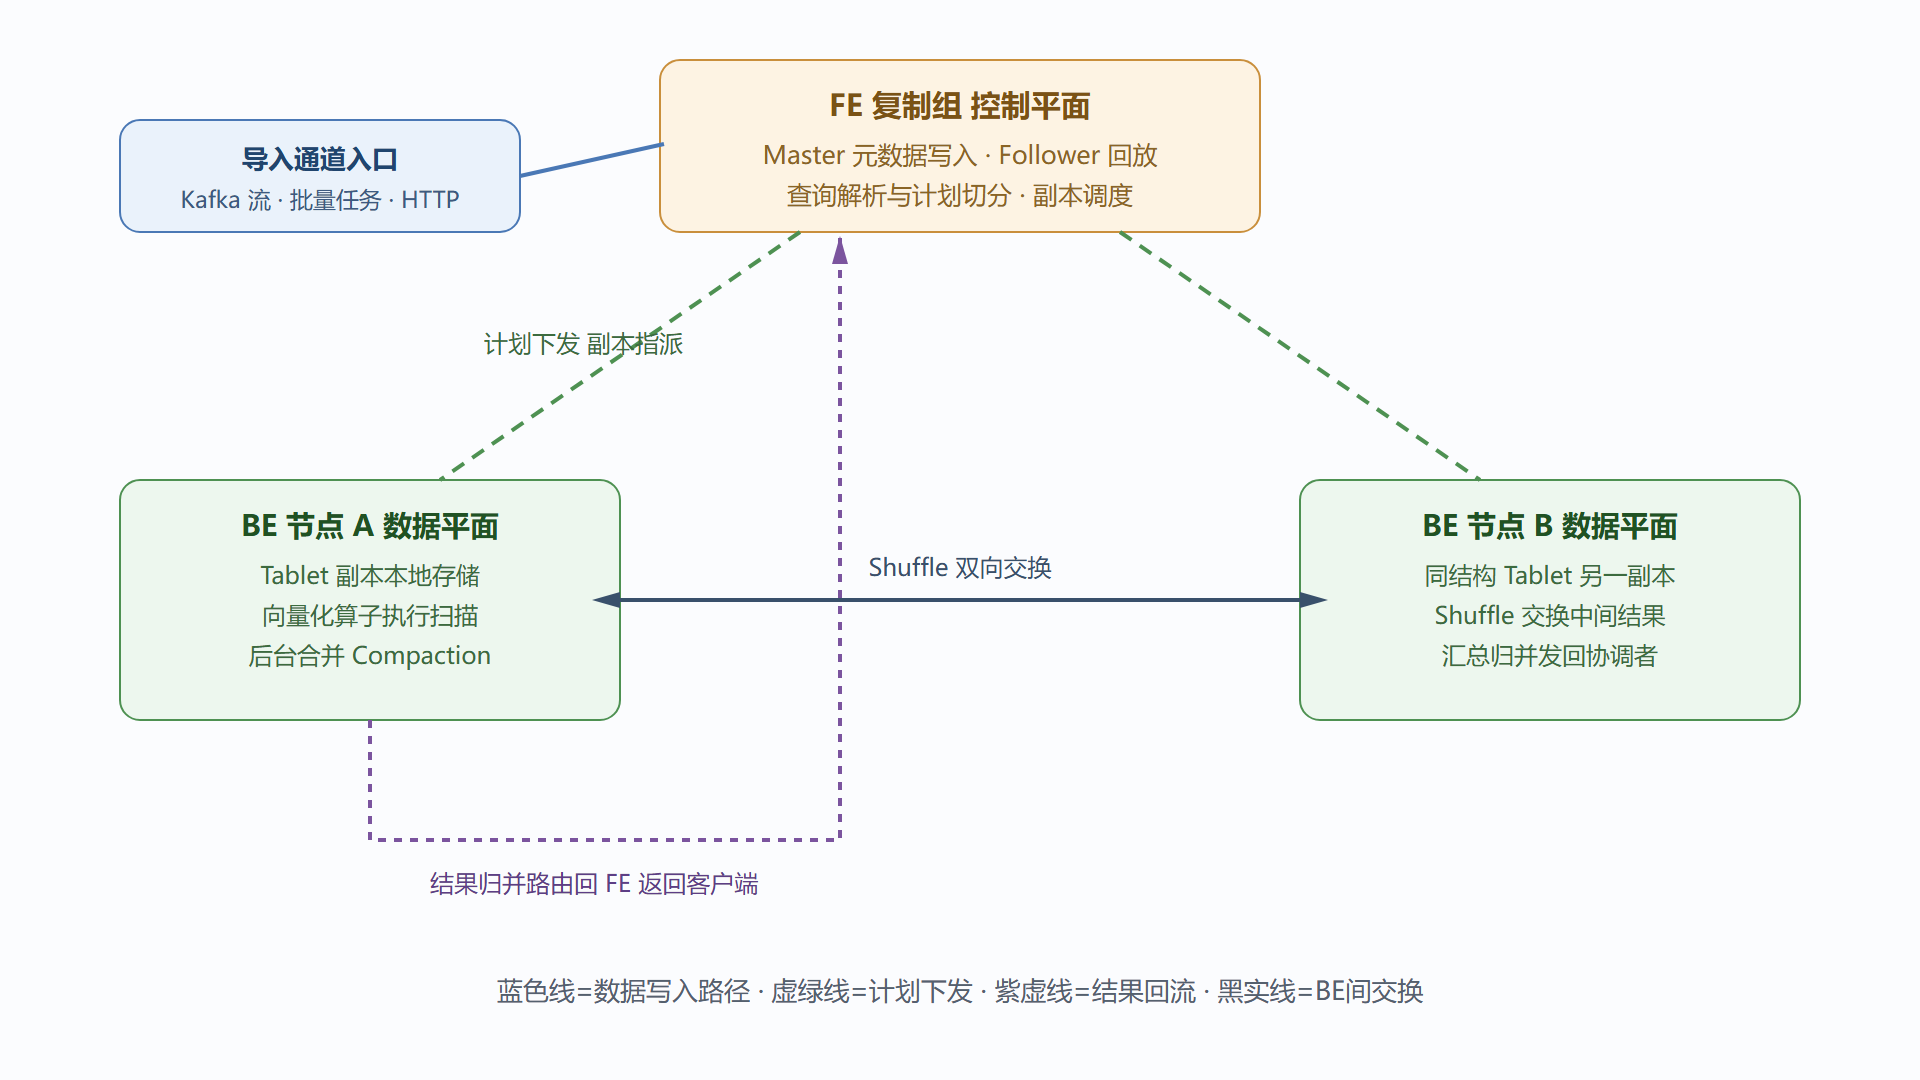
三、三位一体:计算、存储与服务的协同
把组件图翻译成三个常见场景,架构的"协同性"就具体了。
场景一:夜间批量灌数。 Broker Load 任务由 FE 立项并生成作业计划,实际拉取远端文件的活由各 BE 分担,导入完成后副本状态经 FE 登记。瓶颈点通常不在网络而在目标表的版本堆积,原因见第 4 章。
场景二:白天的看板风暴。 几百个并发查询打到任意一台 FE(通常前面挂负载均衡),每条只携带几毫秒的计划时间。真正的扩展压力落在 BE 的扫描与合并算子上,所以容量评估看的是 BE 内存与磁盘 IO,FE 只要 CPU 不饱和就稳如裁判席。
场景三:一台 BE 宕机。 该节点上的 Tablet 少了一个副本,但查询并不中断——其他副本顶上,Master FE 在健康检查确认后触发自动克隆补齐副本。这背后的原则是任何单点的消失都不应改变系统的对外语义,代价只是短暂的重平衡流量。
⚠️ 常见坑:把三台 FE 里的 Observer 当成"灾备 Master"。Observer 不参与选举,它扩展的是读能力;想让故障转移生效,Follower 必须达到奇数多数派。
四、形态之争:Shared-Nothing 与存算分离
社区早期版本是标准 Shared-Nothing:BE 既管计算又管存储,副本即冗余。优势是无外部依赖、故障半径小;代价是弹性差——扩容要搬数据,缩容要等迁移完成。云原生方向的存算分离版本把存储下沉到对象存储,计算层变成无状态可秒级伸缩,代价则转移到网络往返与一致性缓存的设计复杂度上。
两条路线没有绝对优劣,判断依据回到你们的负载形状:数据增长平稳、追求极致本地性能,Shared-Nothing 更省心;流量潮汐剧烈、希望闲时释放算力成本,分离形态更划算。本册正文按经典两角色形态展开,涉及分离版本的差异处会单独标注。
值得补一个容量视角:两种形态的"加一台机器"语义不同。Shared-Nothing 加节点带来的是算力与存储的同步增量,容量规划要把两者绑在一起算;分离形态里算力与存储各自独立池化,白天扩查询算力、夜间收回去,存储按用量计费——灵活的代价是网络成了新的第一性资源,跨网络扫描的延迟预算要重新校准。选型时不妨先问一个财务问题:你们的算力利用率曲线是平的还是潮汐的,答案会替你选好路线。
常见疑问
问:FE 挂了查询会中断吗? 单台 FE 故障不影响——客户端连接串里的多台 FE 地址配合负载均衡会自动切到存活节点,已提交的查询不受影响;只有当投票多数派全部失联时元数据服务才不可用,这正是三台奇数起步的原因。给FE 配置进程级守护加多地址连接串,是两个成本极低的可用性投资。
问:元数据会丢吗? 元数据的可靠性由复制组的日志多数派保证,写入确认要求多数成员落盘成功。真正的风险点反而在 BE 侧的数据副本——副本数配二又恰逢双节点同时损坏时才有丢失可能,三副本加跨机架分布把这类概率压到可忽略。元数据丢与数据丢是两个独立的风险域,预案要分开写。
问:为什么不用 ZooKeeper 做协调? 早期架构试过外挂协调件,后来收敛进 FE 进程内部。外挂意味着多一套要运维、要监控、要版本对齐的活性组件,而 BDB JE 嵌入式复制把一致性协议收进同一进程,故障排查时少跨一个系统。这体现的是"轻量架构"哲学——易运维不是宣传词,是每个组件决策的筛选条件。
问:BE 节点配置可以一次到位买三年吗? 建议按十八个月的增长留余量即可。列存压缩率与硬件性价比都在持续改善,三年期的"一步到位"往往在第二年就被更优的机型价格击穿——扩容是在线能力,把容量规划做成滚动节奏比押注单次采购更经济。
本节要点回顾
- Fragment 并行是性能来源也是倾斜放大器:分桶均匀才配得上高并行度。
- 元数据单一写多路读:DDL 转发机制让多 FE 连接透明化,但别把 Observer 当 Master 备胎。
- FE 无状态承载查询入口:并发扩展的真正瓶颈在 BE 资源。
- 自愈优先于告警:副本自动克隆让多数硬件故障退化为运维事件而非事故。
- 部署形态二选一的判据:负载潮汐剧烈选存算分离,否则经典形态更简单可靠。
下一节走进控制平面的心脏,看看 FE 如何在几十毫秒内把一条 SQL 变成一份可以分发的作战地图。