2.2 前端节点 FE
2.2 前端节点 FE
本节摘要:FE 是 Doris 的大脑:元数据的唯一写入方、查询计划的出生地、副本调度的决策者。本节拆开它的三重身份,重点回答两个值班时的高频疑问——为什么选主会抖、为什么同一条 SQL 有时快有时慢。前者的答案在 BDB JE 复制组,后者的答案一半在优化器、一半在统计信息。
学习目标
阅读完本节,你应当能够:
- 说明 Master、Follower、Observer 三种角色的差别与推荐部署组合;
- 描述 FE 元数据日志的回放机制及"元数据落后"的判断方法;
- 列出一条 SQL 在 FE 侧经历的分析、改写、优化、切分四步;
- 解释统计信息新鲜度如何影响计划稳定性,并给出定时采集策略;
- 定位连接数暴涨、内存告警两类 FE 侧问题的检查顺序。
一、三角色分账
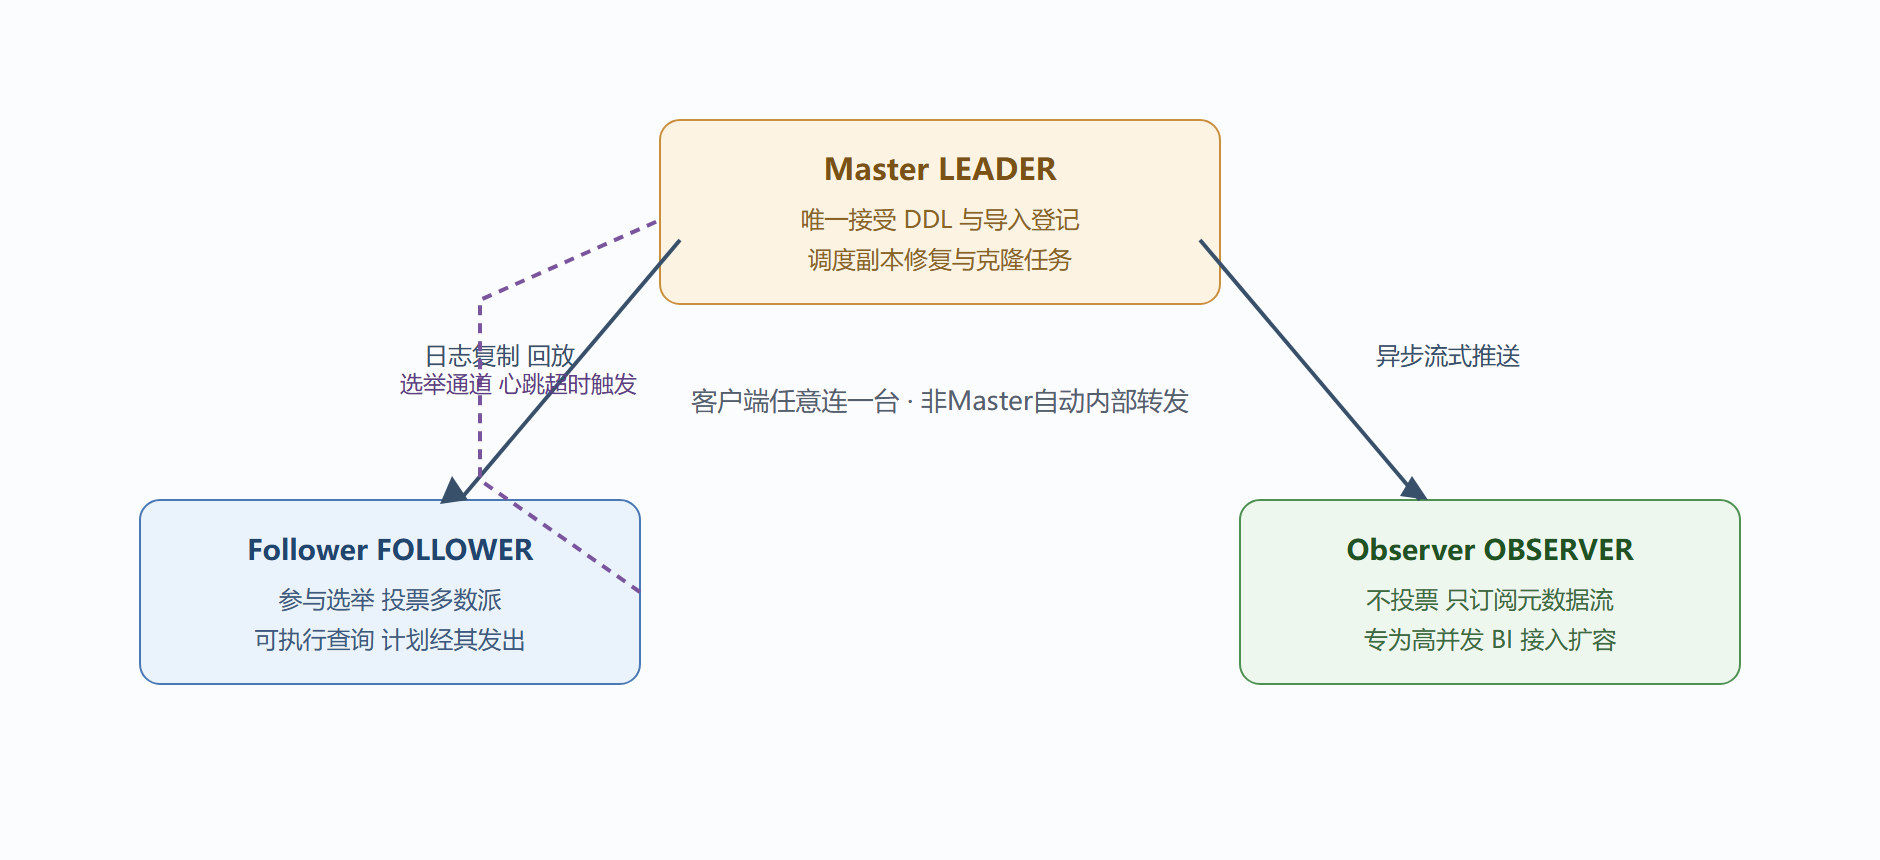
FE 进程以三种身份出现在集群里:
| 角色 | 参与选举 | 服务写请求 | 典型配比 | 适用场景 |
|---|---|---|---|---|
| Master | 是(Leader) | 是(唯一入口) | 一 | 全集群唯一的元数据写入点 |
| Follower | 是 | 可转发至 Master | 两个 | 高可用多数派 + 读扩展 |
| Observer | 否 | 转发,只读回放 | 按需 | BI 高并发接入、跨机房读 |
生产推荐起步组合是一主两从:三个投票成员凑成奇数多数派,任何一台宕机都不影响写入;BI 流量大的团队再加若干台 Observer 扛连接。一个容易混淆的点再次强调——Observer 增加的是读吞吐而非可用性等级,故障转移能力由 Follower 数量决定。
图 2-2:FE 复制组的状态流转与流量分担
二、元数据一致性怎么维持
所有元数据变更先变成一条操作日志持久化到本地 BDB JE 存储,再向其余成员同步。接收方逐条回放使内存态追平,因此"某台 FE 的表结构看起来旧了一版"这类现象的本质是回放延迟。排查方法也很直接:对比各 FE 上库表的清单数量,或观察其报告的心跳时间戳是否持续推进。
几个工程上的注意事项:
- 元数据目录必须放在高性能本地盘上(SSD 为佳),日志落盘速度直接决定批量 DDL 与导入登记的上限;
- 升级或重启 Follower 时一次只动一台,保持多数派在线;
- 千级以上数据库规模会让单条全量元数据镜像变慢,控制"库表爆炸"本身就是最好的运维。
三、一条 SQL 的 FE 侧五步
以一条典型的多维聚合为例,它在 FE 内部走完五道工序:
-- 客户端送来的原句 SELECT city, channel, SUM(amount) FROM dws_trade_wide WHERE dt = '2026-08-26' AND amount > 100 GROUP BY city, channel;
- 解析与分析:词法语法解析生成抽象语法树,完成库名展开、权限校验;
- 关系代数改写:谓词下推到扫描节点、列裁剪只保留引用字段、常量折叠合并表达式;
- 代价估算:结合统计信息(各分区行数、列基数直方图)给每种候选Join顺序与分发方式打分;
- 计划切分:物理计划被切成若干 Fragment,确定每个 Fragment 的实例数与目标 BE;
- 下发与协调:通过 thrift/rpc 把片段送到 BE,随后作为协调者等待结果归并。
这套流程解释了一个经验规律:简单聚合的计划开销通常低于十毫秒,而十几张表关联的复杂查询可能花掉上百毫秒做优化。若你的 P99 抖动集中于计划阶段,优化方向是简化语句或固化提示,而不是加 BE。
四、计划不稳定这个老毛病
同一语句时而毫秒时而数秒的第一嫌疑人就是统计信息过期:优化器以为大表只有一万行,选了 Broadcast Join,实际广播了三亿行。治理办法是把统计信息采集制度化——
-- 对关键事实表开启定时采样(示意) ANALYZE TABLE dws_trade_wide WITH SAMPLE PERCENT 10; ANALYZE TABLE dim_user; -- 维度表小 可全量收集
配合两条纪律:新建大表当天就采一次样再开放查询;口径变更(新增维度列之类)之后重采。此外新版本优化器支持 SQL Cache 与 Plan 复用,对形态重复的看板类负载能把计划开销直接摊薄。
💡 关键直觉:FE 的价值不在算得快,而在"把不确定性消灭在几十毫秒内"。它越是让你感觉不到存在,工作就越成功。
五、FE 侧问题的值班检查顺序
连接数告警:先看是业务风暴还是泄漏(长连接未回收),前者评估加 Observer 分流,后者推动应用改造;
内存水位上涨:多半是复杂查询的计划缓存与大结果集缓冲,限制单查询返回行数往往立竿见影;
元数据写入变慢:检查该机磁盘 IO 与日志卷大小,必要时滚动清理审计日志;
选主抖动:确认是否有人在批量重启 FE、网络是否有抖包,以及 BDB JE 日志里多数派的达成耗时。
⚠️ 常见坑:给 FE 配置过低的堆内存却保留默认无上限并发。控制平面的资源底线要高于数据平面单机的直觉预期。
常见疑问
问:各台 FE 上的表结构不一致是怎么回事? 本质是元数据回放延迟:变更日志先落 Master,其余成员逐条回放,回放间隙读到的是旧状态。观察方法是对比各节点的库表清单与心跳时间戳;持续不追平才值得报警,短暂滞后属于设计内行为。批量 DDL 高峰期适当拉大对延迟的容忍,别把正常回放当故障处理。
问:FE 需要多少台才够? 起步三台(一主两从)覆盖高可用,BI 并发高就加 Observer。判断标准是连接数与计划吞吐:FE 的 CPU 水位长期超过六成、或计划耗时的 P95 明显抬升,就该加 Observer 分流;而选举可用性与 Follower 数量绑定,加 Observer 不改变它。
问:升级 FE 集群有什么铁律? 一次只动一台且先从非 Master 开始,保持多数派在线;Master 的切换放在业务低谷手动触发,别让升级动作和自动选主撞车。元数据目录在升级前做一次快照备份——回滚窗口内它就是唯一的后悔药。
问:连接应该打到哪台 FE? 生产标准做法是在 FE 前面挂一层负载均衡,把整个复制组当成一个虚拟端点;应用侧写多个地址轮询是降级方案,缺点是无法感知节点健康。特别注意长连接场景:会话粘在某台 FE 上后,它重启前应用不会自动迁移,健康检查与重连逻辑要在应用侧备好。
问:统计信息采集会不会拖累线上? 采集本身是一次轻量扫描,避开车流高峰执行就无感。相比它换来的计划稳定性,这笔开销是全册性价比最高的投资之一——把它写进调度平台的例行任务,比等计划劣化后再补救便宜得多。
本节要点回顾
- 一主两从起步:多数派决定高可用,Observer 只解决读压力。
- 元数据即日志回放:所谓"看到的结构不一致",多数时候只是回放延迟而非脑裂。
- 五步流水线:解析、改写、估优、切分、派发,复杂度的爆炸点几乎总在第三步。
- 统计信息是计划稳定的地基:采样要制度化,变更后必补采。
- 控制平面值得更好的硬件与更严的纪律:元数据盘的性能与重启流程规范化,回报远超投入。
控制平面看完,下一节下到车间——BE 如何用列存、向量化和一组精巧的过滤器兑现亚秒承诺。