2.3 后端节点 BE
2.3 后端节点 BE
本节摘要:所有关于速度的承诺最终都在 BE 兑现。本节沿着"一列数据从内存缓冲到磁盘布局,再被一次查询读回"的路径,讲清列式存储的物理形态、向量化执行的算子模型、前缀索引与各类过滤器的协同,以及 Tablet 副本的后台维护机制。读完你应该能对着一张 Query Profile 指出每一毫秒花在了哪个环节。
学习目标
阅读完本节,你应当能够:
- 描述 Rowset、Segment、行组三级的存储组织及各自被谁创建;
- 解释前缀索引、ZoneMap、Bloom Filter、倒排索引各自的命中场景;
- 说明向量化引擎为什么按批次处理数据,以及它对内存的额外要求;
- 区分三种 Runtime Filter 的适用条件并预估收益量级;
- 看懂 Compaction 分数指标并用它解释"导入正常但查询变慢"的现象。
一、数据在 BE 身上的样子
一条导入进来的数据流经历这样的旅程:MemTable 攒批、排序后刷盘生成一个不可变的 Rowset;Rowset 内部按 Tablet 归属放置;每个 Rowset 由若干 Segment 文件组成,Segment 内再以约一万行为一个行组(block)做列编码与压缩。
不可变性是这个设计的灵魂:已生成的 Rowset 永不修改,更新和删除都表现为追加新的 Rowset 并在读取时按版本合并,或者干脆由后台 Compaction 把多个小版本压实成一个。理解了这一点,很多运维现象立刻失去神秘感——高频小批量导入会制造海量微小 Rowset,让读取时合并的开销失控,于是"导入曲线很健康、查询延迟却在爬坡",答案就在版本数量里。
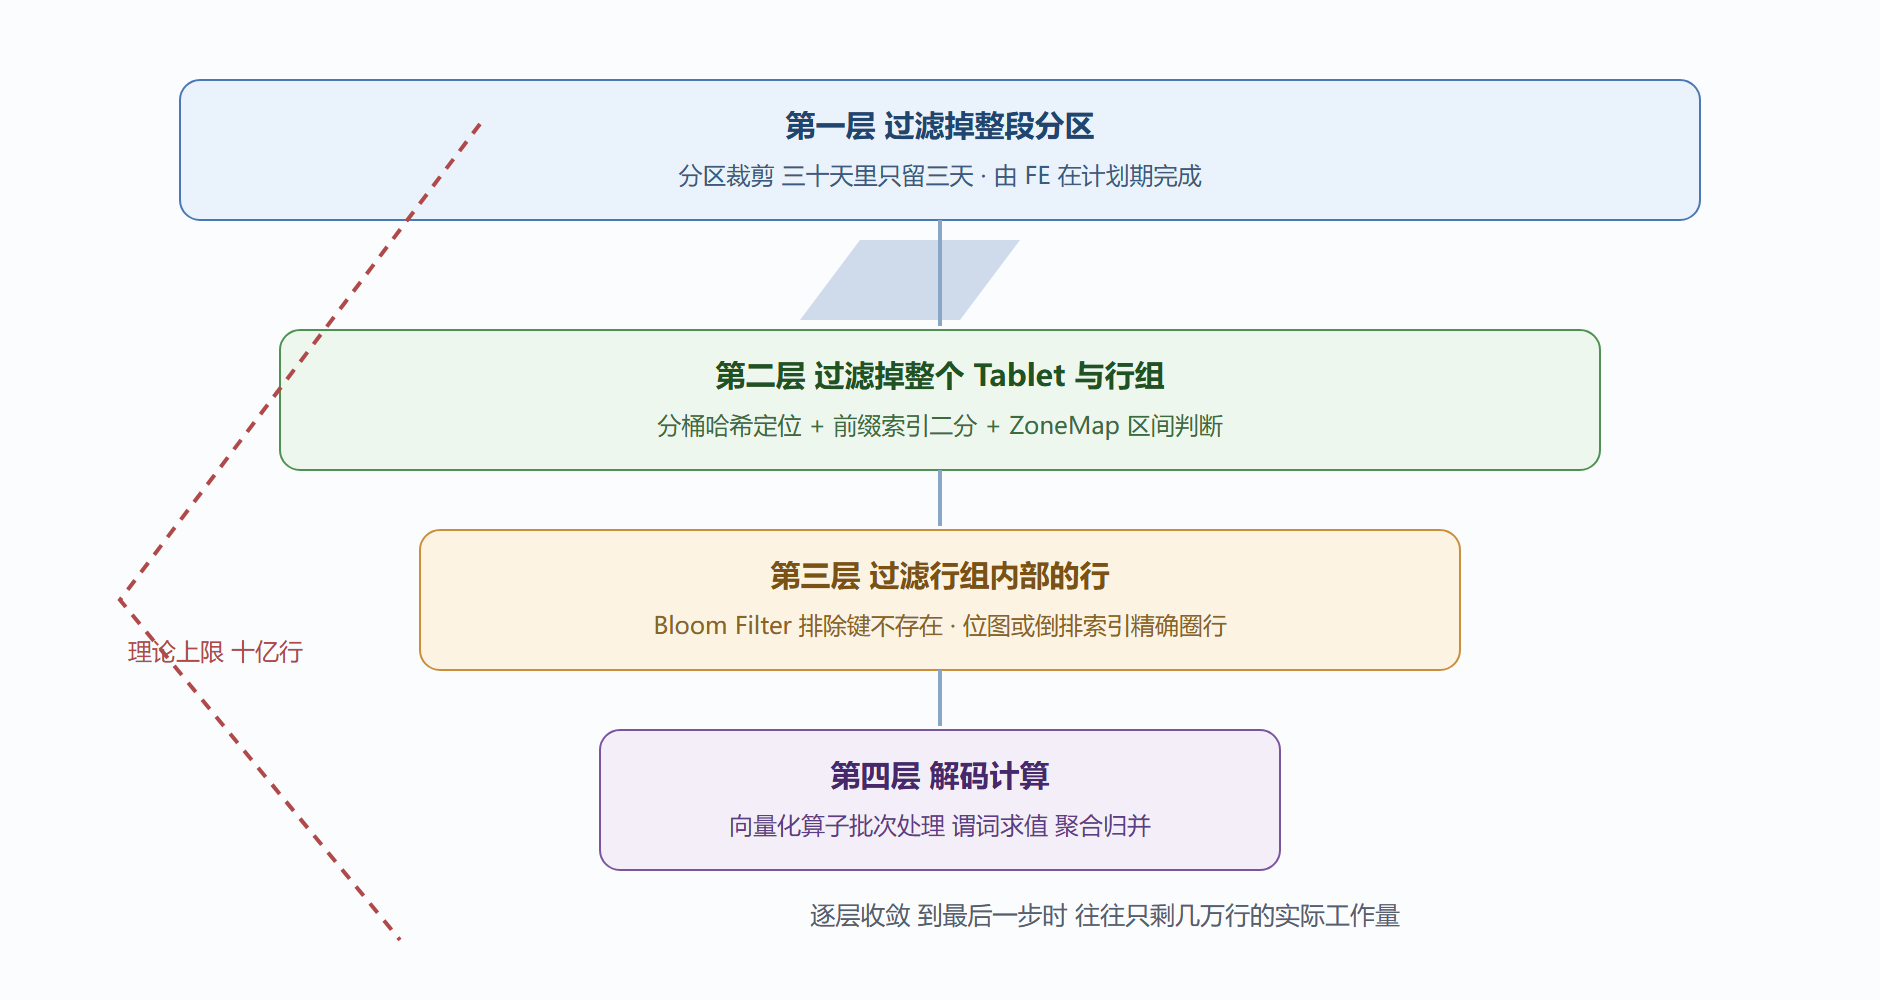
图 2-3:一次扫描查询在 BE 内部的四层漏斗
二、四类索引各管一段
- 前缀稀疏索引:每个行组只在开头记一个排序键摘要,查询按排序列二分直接跳到候选行组。它依赖建表时把最常过滤的低基数列放在排序键前面——参数怎么选是第 3 章的主题。
- ZoneMap:每列为每个行组记录最大最小值,对时间戳、金额这类单调性强的列,一次比较就能跳过成片行组。
- Bloom Filter:为指定列声明后,对等值条件给出"绝不在此行组"的概率性判断,适合高基数的用户 ID 类字段。
- 位图与倒排索引:分别服务低基数枚举值的多值交集与文本类字段的包含匹配,后者让日志检索类负载有了原生支撑。
一张表不必全开——每个索引都有构建与存储代价,网格化堆料反而拖慢导入。原则是:排序列享受免费的前缀索引;数值范围过滤加 ZoneMap(多数版本默认);等值点查的大基数列加 Bloom Filter;仅当确有检索需求才上倒排。
三、向量化执行的真实含义
传统火山模型的算子一次吐一行,函数调用与虚表跳转的开销占了大头。向量化算子一次吞吐几千行的批次,内部循环对整批列连续求值,CPU 指令分支预测友好,还能吃到 SIMD 的并行车道。同样的聚合语义,这套模式下指令数下降一个数量级并不夸张。
它的隐性账单是内存:批次本身要驻留,哈希表的构建粒度变大,因此 BE 侧有专门的内存池划分(查询池、导入池、元数据缓存等)。当你在 Profile 里看到内存超限报错,对应的是这条预算线被打穿,而不是简单的"数据太大"。缓解方向包括控制单实例并发度、给大查询设内存上限、必要时拆分日期范围执行。
四、Runtime Filter:Join 的小滤网
当事实表 Join 维度表后还要继续过滤时,Be 侧可以把维表侧生成的过滤信息反向推给大表扫描器,这就是 Runtime Filter,常见三类:
| 类型 | 原理 | 最适场景 | 开销 |
|---|---|---|---|
| IN 列表 | 收集维度侧去重键集合 | 键数量适中(百级到万级) | 低 |
| Min-Max | 记录维度侧键值区间 | 关联键在两侧分布相关 | 极低 |
| Bloom | 概率成员判断 | 大基数关联、超长列表场景 | 中 |
实测中,一场维表过滤后再扫十亿行事实表的任务,三张滤网叠加常能把扫描量压掉一个数量级。它们默认按优化器估值自动启用,也可以用会话变量强制调整类型与等待超时。
五、Tablet 管理:副本健康度这门家事
每个 Tablet 默认三副本分散在不同 BE。后台持续做的事有三件:克隆补副本(检测到节点掉线自动从健康副本复制)、重均衡(新节点加入时分担 Tablet)、Compaction(压实版本链)。值班时可观察的整形指标是 Compaction 分数——它近似于该 Tablet 未压实的版本堆积程度:
-- 经由管理接口查看 BE 汇总的压实情况(示意) SHOW PROC '/cluster_health'; -- 关注 tablet_max_compaction_score 单机阈值经验线在百余级别
分数长期高位意味着版本产生速度快于消化速度。处置顺序是:先查导入是否过于碎片化(调大批次或开启攒批提交),再评估后台压缩线程资源是否被查询挤占,最后才考虑滚动重启释放积压。
⚠️ 常见坑:为了"看着整齐"频繁手动触发全量合并。Compaction 是资源竞争者,抢走的正是查询要用的 IO 与 CPU。
常见疑问
问:更新和删除既然是追加 Rowset,数据会不会越积越多? 不会无限积压——后台 Compaction 会把版本链压实:同主键的多个版本合并成一个最新值,被删除标记覆盖的行物理清除。这正是高频小导入伤查询的机理:版本产生快于压实,读取时的合并路径变长。理解了"追加加压实"这对机制,导入节奏与查询性能的因果关系就通了。
问:Runtime Filter 什么时候会失效? 三种典型情形:关联键两侧分布无关(维表键区间覆盖事实表全域,区间滤网剪不动)、维表过滤后基数仍然巨大(IN 列表超长,退化为 Bloom 甚至放弃)、以及关联发生在子查询内部而过滤器生成时机晚于扫描开始。Profile 里扫描输入行数接近全量时,先按这三种情形排查,再考虑调会话变量。
问:Compaction 分数多高算异常? 经验线是单机峰值长期高于百余,且随导入高峰回落缓慢。瞬时冲高随导入节奏波动是健康的;只涨不回落、或全集群普遍高位,说明消化能力不足——按"查导入碎片化、查压缩线程资源、最后才重启"的顺序处置,直接重启只是把问题延后半天。
问:扫描时压缩数据要解压多少才划算? 经验方向是"先裁剪后解码":四层漏斗把行数砍到位后才做向量化解码,多数查询真正解压的行数不到扫描命中的十分之一。若 Profile 显示解码耗时占比畸高,多半是裁剪层失灵让解码扛了不该扛的量——回查前三层,而不是急着换压缩算法。
本节要点回顾
- 不可变 Rowset 加版本合并是全部读写行为的总纲,也是碎片化问题的根源。
- 四层漏斗决定扫描下限:分区、Tablet 与行组、行内精确过滤、解码计算。
- 索引按需开:排序键免费用,其他索引各有明确的服务对象。
- 向量化省指令费内存:内存池上限是大查询的第一道闸门。
- Runtime Filter 是免费的暴力剪枝:Join 型看板必开必验。
- Compaction 分数是导入健康的体温计:治理导入形态优先于加大后台资源。
至此解剖完成。带着这台机器的全息图,我们进入全册重心——第 3 章,把一张真实的订单宽表从建模争论到上线验收完整复盘一遍。