3.1 表模型设计与取舍
3.1 表模型设计与取舍
本节摘要:Duplicate、Aggregate、Unique 三种表模型是 Doris 与使用者签订的第一份契约,它规定了"同一批键值再次到来时引擎该怎么处理"。选错的代价不是慢一点,而是语义不成立——聚合翻倍、明细重复、更新丢失。本节逐个拆解三种模型的合并规则与代价结构,并给出一套两分钟内可完成的选型流程。
学习目标
阅读完本节,你应当能够:
- 口述三种模型在数据重复到达时各自的行为差异;
- 为 Aggregate 模型列出可用的聚合函数约束与建表写法;
- 在 Merge-on-Read 与 Merge-on-Write 之间做出有依据的选择;
- 用一句业务描述判断三种模型的适用边界。
一、问题从哪里来
上游数据天然带重:Kafka 至少一次投递会造成幂等重放;每日全量同步会把旧记录原样再送一遍;补数任务常把同一天的文件重导。关系库靠主键唯一约束挡住这些重复,但分析存储为了吞吐选择"允许重复、按策略合并"。所谓表模型,本质上就是那份合并策略说明书:
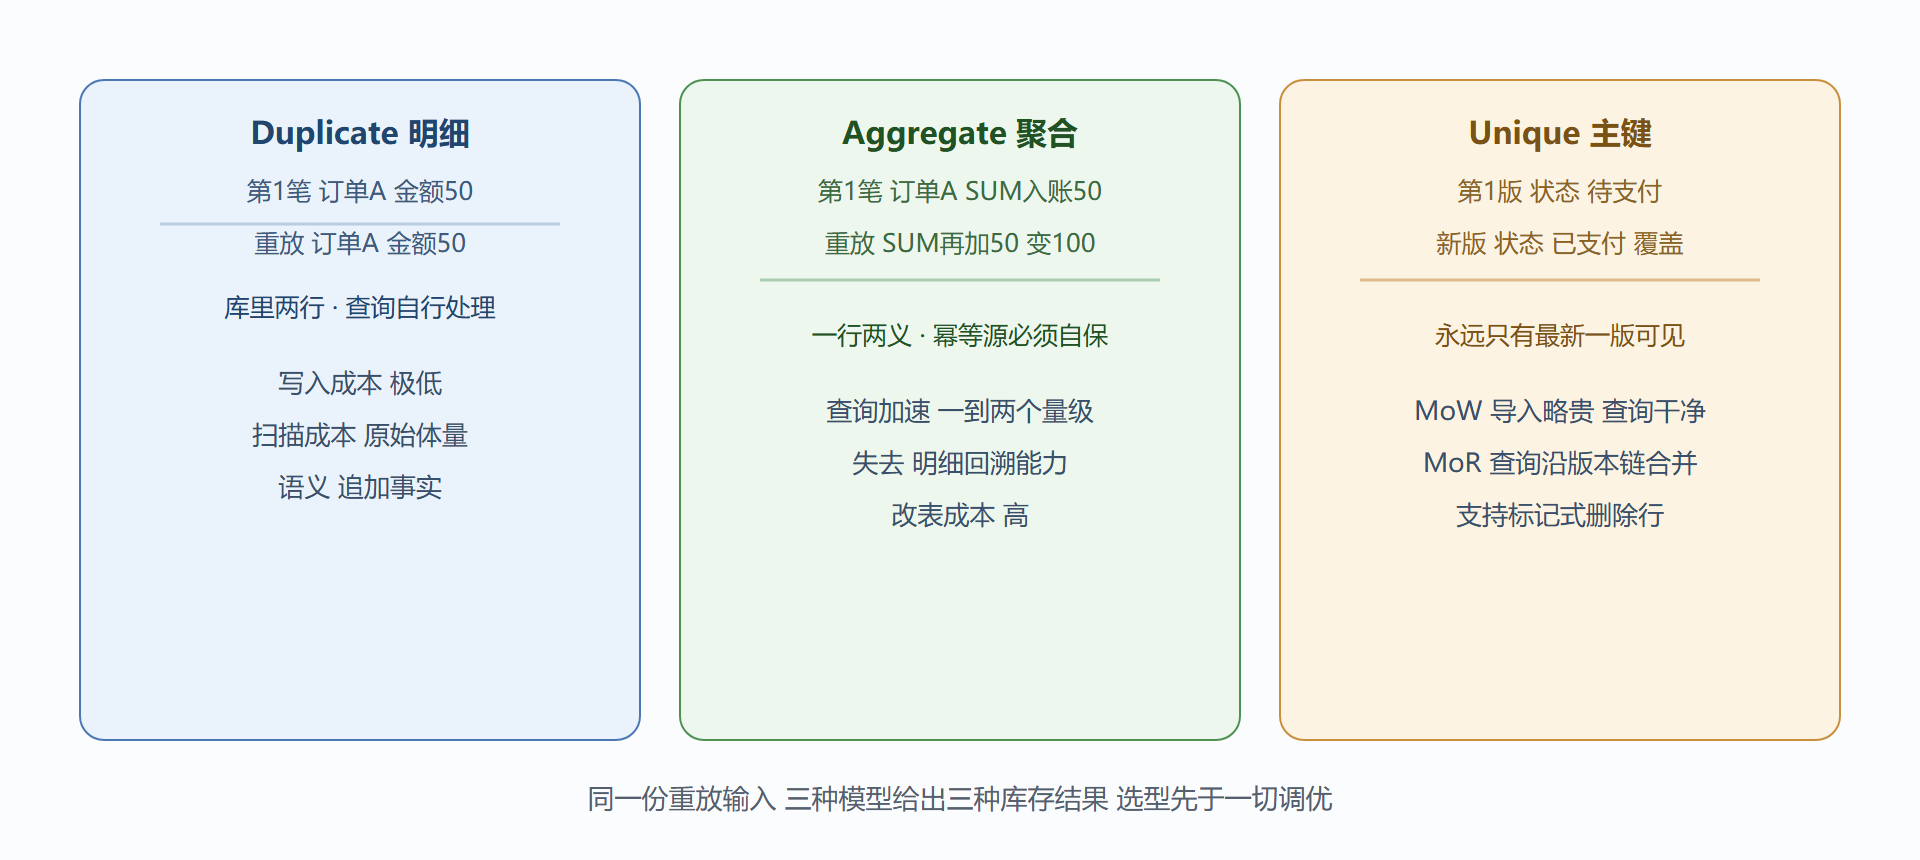
- Duplicate 明细模型:什么都不做,来多少存多少。适合日志、埋点这类只增不改的事实流水,查询自己负责去重或按时间窗口收敛。
- Aggregate 聚合模型:键列相同的行在导入时做预聚合,度量列按声明的函数(SUM、MAX、MIN、REPLACE 等)滚成一行。它是把 GROUP BY 成本前移到写入期的交易。
- Unique 主键模型:键相同的行保留最新版本,等价于以 REPLACE 方式覆盖全部列。从 2.x 起底层实现已并入 Aggregate 框架——主键即聚合键,全部列默认 REPLACE。
三者的心理画像可以这样记:明细模型是忠实的账房先生,聚合模型是精打细算的采购员,主键模型是永远只认最新报价的前台。
二、逐个看代价结构
Duplicate 的账本最简单:写入零合并开销,查询承担原始体量。只要口径里没有"改数",它的性价比最高。用下面的方式声明:
CREATE TABLE dwd_page_view ( dt DATE NOT NULL COMMENT '日期分区', event_time DATETIME NOT NULL, user_id BIGINT NOT NULL, page_id VARCHAR(64), stay_ms INT ) DUPLICATE KEY(dt, event_time, user_id) PARTITION BY RANGE(dt) () DISTRIBUTED BY HASH(user_id) BUCKETS 16;
排序键(DUPLICATE KEY)同时是前缀索引的取材来源,所以把过滤频率最高的列放前面,而不是机械照抄主次序。
Aggregate 的账本是双面的:查询因基数坍缩获得数量级加速,代价是牺牲明细回溯能力。REPLACE_IF_NOT_NULL 这类特殊函数还能实现"空值不清旧值"的稀疏更新语义,画像宽表常用这一招拼装多来源标签:
CREATE TABLE dws_user_profile ( user_id BIGINT NOT NULL, last_login_dt DATE REPLACE, total_points BIGINT SUM, vip_level TINYINT MAX ) AGGREGATE KEY(user_id) DISTRIBUTED BY HASH(user_id) BUCKETS 10;
注意约束:一旦定型,想新增一个非 REPLACE 类型的度量就要重建表,改造成本远高于普通加列。
Unique 的账本取决于合并时机。读时合并把成本留在查询侧——每个查询都要沿着版本链找最新值,点查场景还行,大范围扫描就难受了。写时合并反其道而行之:导入阶段先查一遍已有数据的位置,为将被覆盖的旧版本打删除标记,之后查询走的是干净的追加路径。后者多付的是导入延迟与一份额外内存索引(持久化之后磁盘负担可控),换回的是查询性能的确定性。
图 3-1:三种模型在“重复到达”下的行为对照
三、一套可执行的选型流程
拿到需求后按顺序问三个问题:
- 同一键会再次到达吗? 若是流式导入且需要幂等或有修正语义,答案通常是 Unique;纯追加事件流直接 Duplicate。
- 查询会不会超过百万级基数扫描? 是则评估 Aggregate 预聚合能否覆盖主要口径,能覆盖的先建 Aggregate 或交给物化视图。
- Unique 表的读写占比是什么形状? 大屏、报表等读密集负载一律 MoW;只有导入极高频而读取稀疏(如高频心跳回流)才接受 MoR。
两个真实教训值得引用。某团队把订单状态表建成 Duplicate,靠"取最大时间戳"逻辑在 SQL 层去重,三个月后一条没写该条件的报表上线,GMV 直接翻倍——语义漏洞藏在每一个未来作者的键盘里。另一个团队对画像标签表用了 MoR 的 Unique 模型,日常十几毫秒的点查膨胀到秒级,最后整套迁移到 MoW 才收场,白白付出一轮数据搬迁。
⚠️ 常见坑:认为"加个 UNIQ 可以以后再改"。表模型在建表后不可在线切换,转换等于重建全量数据,这一条请写进评审清单。
四、动态分区与建表的联动手感
多数生产表会顺手开启动态分区,让引擎自动滚动创建与回收日分区:
ALTER TABLE dws_trade_wide SET ( "dynamic_partition.enable" = "true", "dynamic_partition.time_unit" = "DAY", "dynamic_partition.start" = "-30", "dynamic_partition.end" = "3", "dynamic_partition.prefix" = "p" );
它能预先创建三天后的分区承接迟到的时钟漂移数据,也能静默回收三十天前的历史。注意它管理的是分区骨架而非桶数——分桶在创建时的分布决定权仍然在你手里,这正是下一节的话题。
常见疑问
问:三种模型之间能互相转换吗? 在线不能。模型是建表时刻定下的物理契约,切换等于按新模型重建全量数据——通常的做法是建新表、双写过渡、历史数据回灌、校验后切读。这也是选型流程放在建表之前的根本原因:模型错了,后面所有调优都是在错误的账本上精打细算。
问:Unique 模型既然并入聚合框架,还值得单独记一类吗? 值得,因为使用语义完全不同。业务视角下 Unique 就是"按键覆盖"的主键表,讨论的是一致性与更新链路;聚合模型讨论的是预计算的口径设计。同一套底层机制服务两种心智模型,记混了会把"改标签"写成"累加标签",那是要出数据事故的。
本节要点回顾
- 表模型是合并契约:Duplicate 全留、Aggregate 按函数滚动、Unique 只认最新。
- Aggregate 是写入期的 GROUP BY:换来查询加速,失去明细与灵活改表。
- Unique 默认选 MoW:除非导入频次高到 MOW 开销不可接受且查询很轻。
- 不可在线换模型:评审阶段就把语义钉死,比事后重建便宜百倍。
- 排序键兼顾前缀索引:列序跟着查询形态走,不跟理论主次走。
模型定了方向盘,下一节拆开引擎盖看物理布局——Rowset 如何落盘、四类索引在哪里各显神通。