3.2 存储结构与索引内幕
3.2 存储结构与索引内幕
本节摘要:一次亚秒查询的九成功劳属于"少读字节"。本节把视角钉到磁盘上:Rowset 与 Segment 的生成时机、行组里的列编码、四类索引的落位与命中条件。最后用一个一亿行的过滤查询做纸上演练,逐层算出实际需要读取的数据量——这套心算是你判断建表方案优劣的尺子。
学习目标
阅读完本节,你应当能够:
- 描述 MemTable 到 Rowset 再到 Segment 的落盘链条及各环节触发条件;
- 解释排序键如何同时服务聚簇存储与前缀索引两件事;
- 为一个具体查询组合预估各索引层的裁剪量;
- 判断什么时候值得为一列付出 Bloom Filter 或倒排索引的额外成本;
- 用 Compaction 视角解释同一天导入的同一张表为何上午快下午慢。
一、从内存缓冲到不可变文件
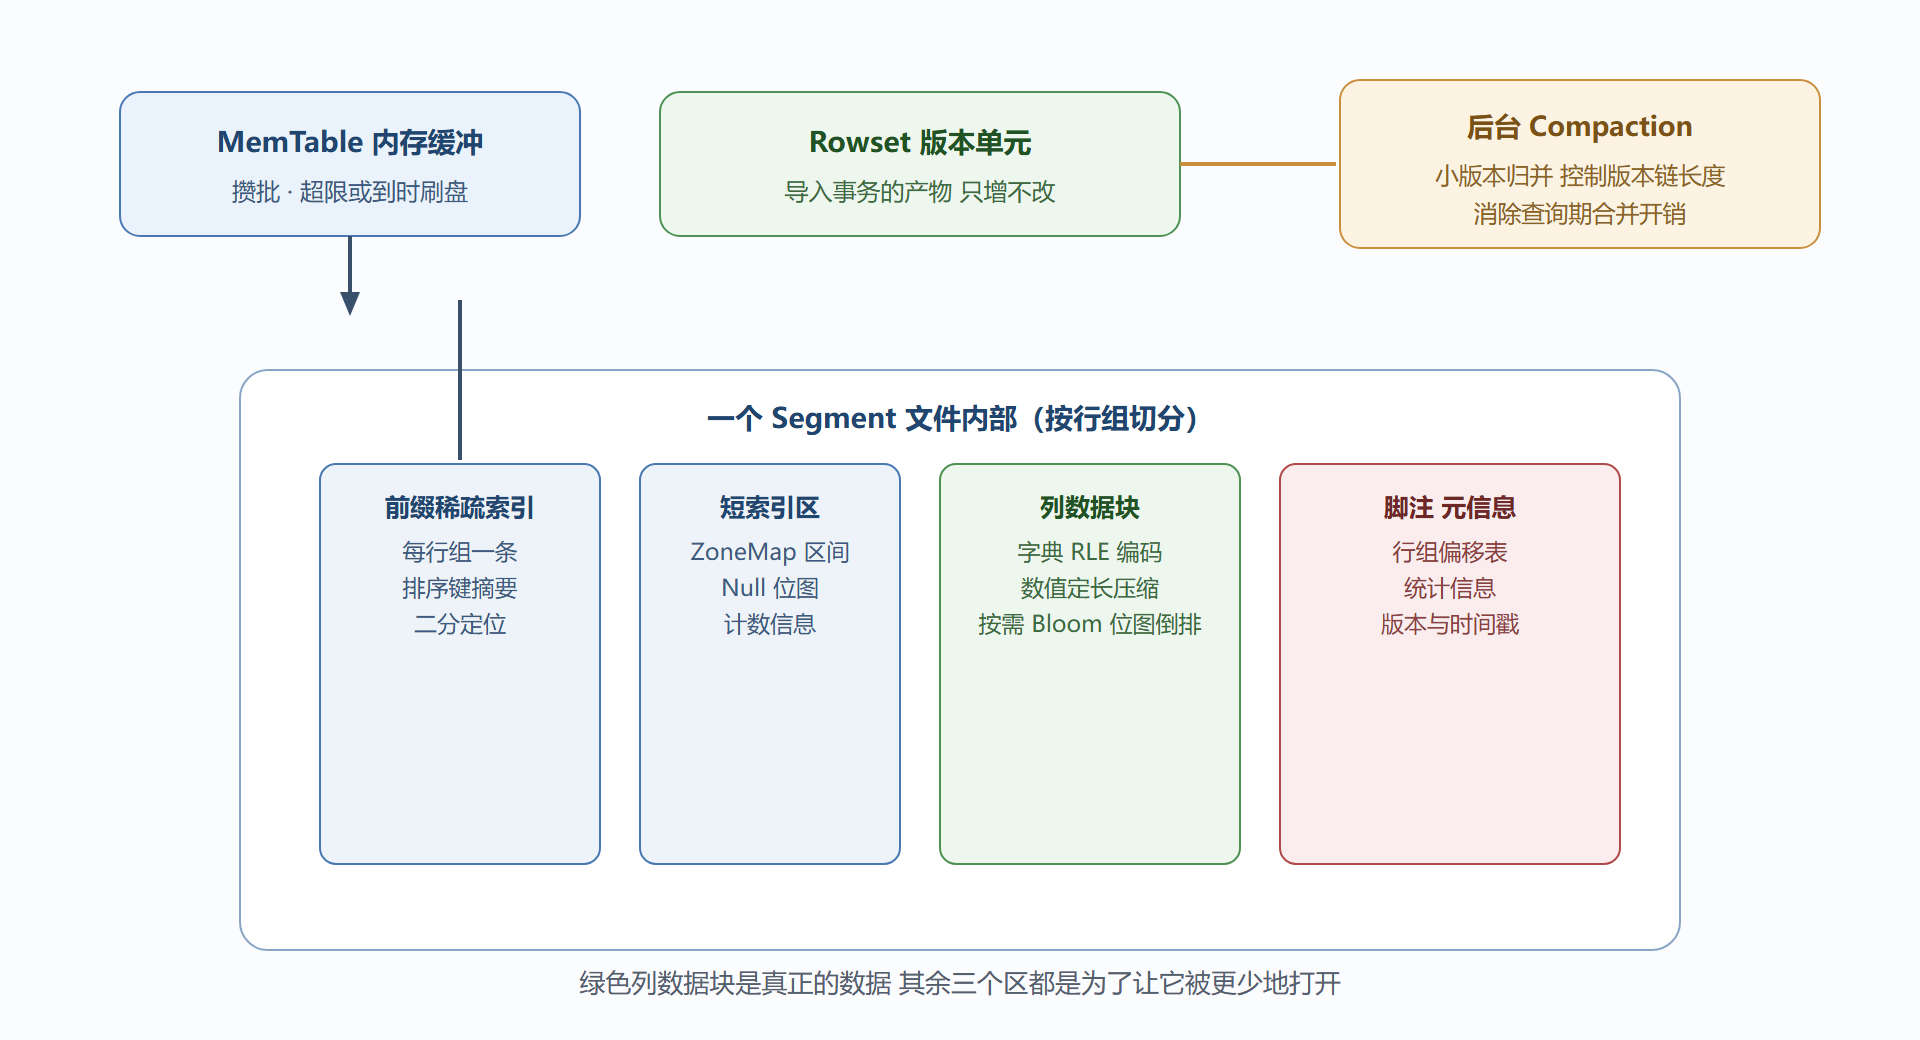
数据进入 BE 后先落在内存里的 MemTable,攒满或超时后按排序列整批排序,压成一个 Rowset 直接落盘。每个 Rowset 内部再切成一个或多个 Segment 文件,Segment 里以固定行数(通常一万行左右)为界切成行组(block),行组是 IO 与索引的共同基本单位。
这条链上有三个关键推论:
- 写入放大主要来自排序与编码:导出的每一批都要重新排序,批越大边际成本越低——这是"大批次优于小批量"建议的第一性依据。
- 读取路径必然经过版本合并:一天的查询可能面对多个 Rowset,主键模型的合并逻辑就在此时生效;压实任务把多版本卷成单版,是维持扫描速度的长效药。
- Segment 内的列布局与压缩互锁:同列相邻值高度相似,字典编码加 RLE 能把枚举列压到原体积的十分之一以下。
图 3-2:Rowset 物理布局与索引落位示意
二、排序列一鱼两吃
DUPLICATE KEY 或 UNIQUE KEY 声明的列除了承载聚合语义,还决定了 Segment 内数据的物理顺序以及前缀索引的内容。因此选列的两个标准是一体的:
- 把过滤条件里出现频率最高、选择性最差的列放最前面(比如渠道、城市这类低基数维度);
- 高基数但常做精确点查的键(用户 ID)往后靠,配合 Bloom Filter 补刀。
反例是照搬业务主键当排序键:主键往往是自增长整型,除了按 ID 点查之外对任何维度过滤都毫无裁剪力,等于白费了免费的聚簇收益。
三、纸上演练:一次一亿行的扫描算账
设一张埋点明细表按天分区、三十二桶,每天约一亿行;查询条件为某一天的某个城市加某个页面渠道的访问次数汇总:
SELECT COUNT(*) FROM dwd_event_log WHERE dt = '2026-08-26' AND city = '杭州' AND channel = 'app';
分层估算它真正要碰多少数据:
| 裁剪层 | 命中手段 | 剩余量级 |
|---|---|---|
| 分区 | 仅当天分区 | 约 1/30 总量 ≈ 一亿行 |
| 分桶 | 城市不在分桶键则全桶扫(若城市是第一排序列则受益) | 取决于排序设计 |
| 行组前缀 | city 领头排序时跳过绝大多数行组 | 可能压到百万级 |
| ZoneMap | 辅助 channel 区间判断 | 继续折半 |
| 精确谓词 | 行内求值计数 | 最终结果若干万 |
同样的 SQL 在另一张以自增 ID 打头的表上跑,行组层几乎颗粒无收,全程要解压近千万行的剩余数据——差出来的那几百毫秒就是建表阶段欠下的债。
一个 mermaid 时序视图补充说明这几层在执行期的先后关系:
四、付费索引值不值
给列开 Bloom Filter 的存储代价大约是该列字节数的一成上下,换来的是高基数等值条件的行组级排除。经验法则:该列出现在等值过滤中的频率高于其更新成本,就值得。倒排索引更重,但对文本包含、数组元素匹配这类需求没有替代品——检索型负载开了才有入场券,纯报表负载别碰。
💡 关键直觉:每个索引都是在为未来的某种查询预付存款。没人会查的列配上最好的索引,是把利息白白烧掉。
五、与 Compaction 的时间赛跑
上午导入后立刻查询慢、下午却变快,这不是玄学而是版本链:刚导入的数据由 N 个新鲜 Rowset 组成,扫描要做实时合并;等后台把版本卷好,路径自然干净了。想缩短这段窗口可以从三处下手:控制导入批次数量(根源)、调整压缩调度权重(缓解)、对强实时表选择 MoW 主键模型让合并成本一次性前置。
六、编码与压缩:列存红利的一半来自这里
扫描慢的账单里,相当一部分是"读了太多字节",而字节量的一半以上由编码压缩决定。选型的底层逻辑是按列的取值特征配策略:时间戳与自增序列这类相邻差值小的列,差值编码能把八个字节压到一两个;省份、状态这类低基数字符串列走字典加游程,压缩比常到十倍以上;金额这类数值列用定长压缩,收益中等但解压近零成本。压得越狠解压越贵,高频扫描的热列应选解压轻快的组合,归档冷列才放行高压缩比算法——这与 8.3 的冷热分层是同一笔账的两半。
还有一个容易忽略的联动:排序本身也是压缩的前置手段。同列相邻行取值相近时游程与字典的收益放大,这就是为什么排序键的选择不仅影响裁剪、还悄悄影响着压缩比——建表时把"常过滤的列"放前面,等于同时优化了扫描路径与存储体积。
常见疑问
问:索引加得越多是不是越快? 反了。每个索引都要在导入时构建、在存储里占空间、在查询计划时参与评估,堆料的结果是写入变慢而查询未必受益。正确姿势是按查询形态配最小充分组合:免费的前缀索引用足,ZoneMap 默认在列上,其余两种付费索引各服务明确的等值或检索需求。
问:为什么刚导入完的表查询偏慢? 版本链还没压实:新数据是若干新鲜 Rowset,扫描要边合并边读。这是设计内行为而非故障,缓解靠控制导入批次粒度与压缩调度权重,强实时表干脆选写时合并的主键模型把合并成本一次性前置。
问:行组为什么定在一万行左右? 这是索引粒度与 IO 粒度的折中:行组太大则前缀索引的跳读精度变粗、ZoneMap 的区间变宽,裁剪力下降;太小则索引与元数据的存储与构建开销占比上升。万行量级让单行组的原始体积落在几百 KB,正好匹配一次顺序读的物理块大小。
本节要点回顾
- MemTable→Rowset→Segment→行组 是全部物理阅读题的标准答案。
- 排序列决定聚簇形态与免费索引,按查询形态排,不按业务主键抄。
- 估算扫描量要用漏斗乘法:分区 × 分桶 × 行组 × 行,任何一层塌方都会现形于延迟。
- 付费索引对症才开:等值高基数配 Bloom,文本检索配倒排。
- 查询的时间波动多半是版本链现象:治理源头(导入形态)优先于调参。
物理布局清楚了,下一节回答最后一个布局问题:这么多 Tablet 该怎么摊到时间轴与机器网格上。