3.3 分区与分桶策略
3.3 分区与分桶策略
本节摘要:分区与分桶是同一套切分思想的两级实现:分区按时间或业务段划出数据的"存亡边界",决定裁剪精度与生命周期管理;分桶把每个分区再摊到集群网格上,决定并行度上限与倾斜风险。本节给出数量估算的公式与例外,讲清桶数不可变的约束从何而来,并覆盖动态分区、自动分区这类让两级切分自己运转起来的机制。
学习目标
阅读完本节,你应当能够:
- 用一句话区分分区的三个用途(裁剪、生命周期、副本平衡)与分桶的两个用途(并行、打散);
- 按日增行数与单 Tablet 目标体量估算初始桶数;
- 选择不倾斜的分桶列并说出为什么禁止用时间列分桶;
- 配置动态分区滚动保留,评估自动分区在稀疏业务日期上的适用性。
一、两级切分的职责分工
分区(Partition)沿某个逻辑维度纵向切表,最常见是日期,也可以是地区或租户。它服务三件事:查询裁剪(带时间条件的看板只碰相关分区)、TTL 管理(过期整区删除瞬间完成)、以及 Replication 分配的最小调度单位。分区是元数据层面的概念,创建删除都轻。
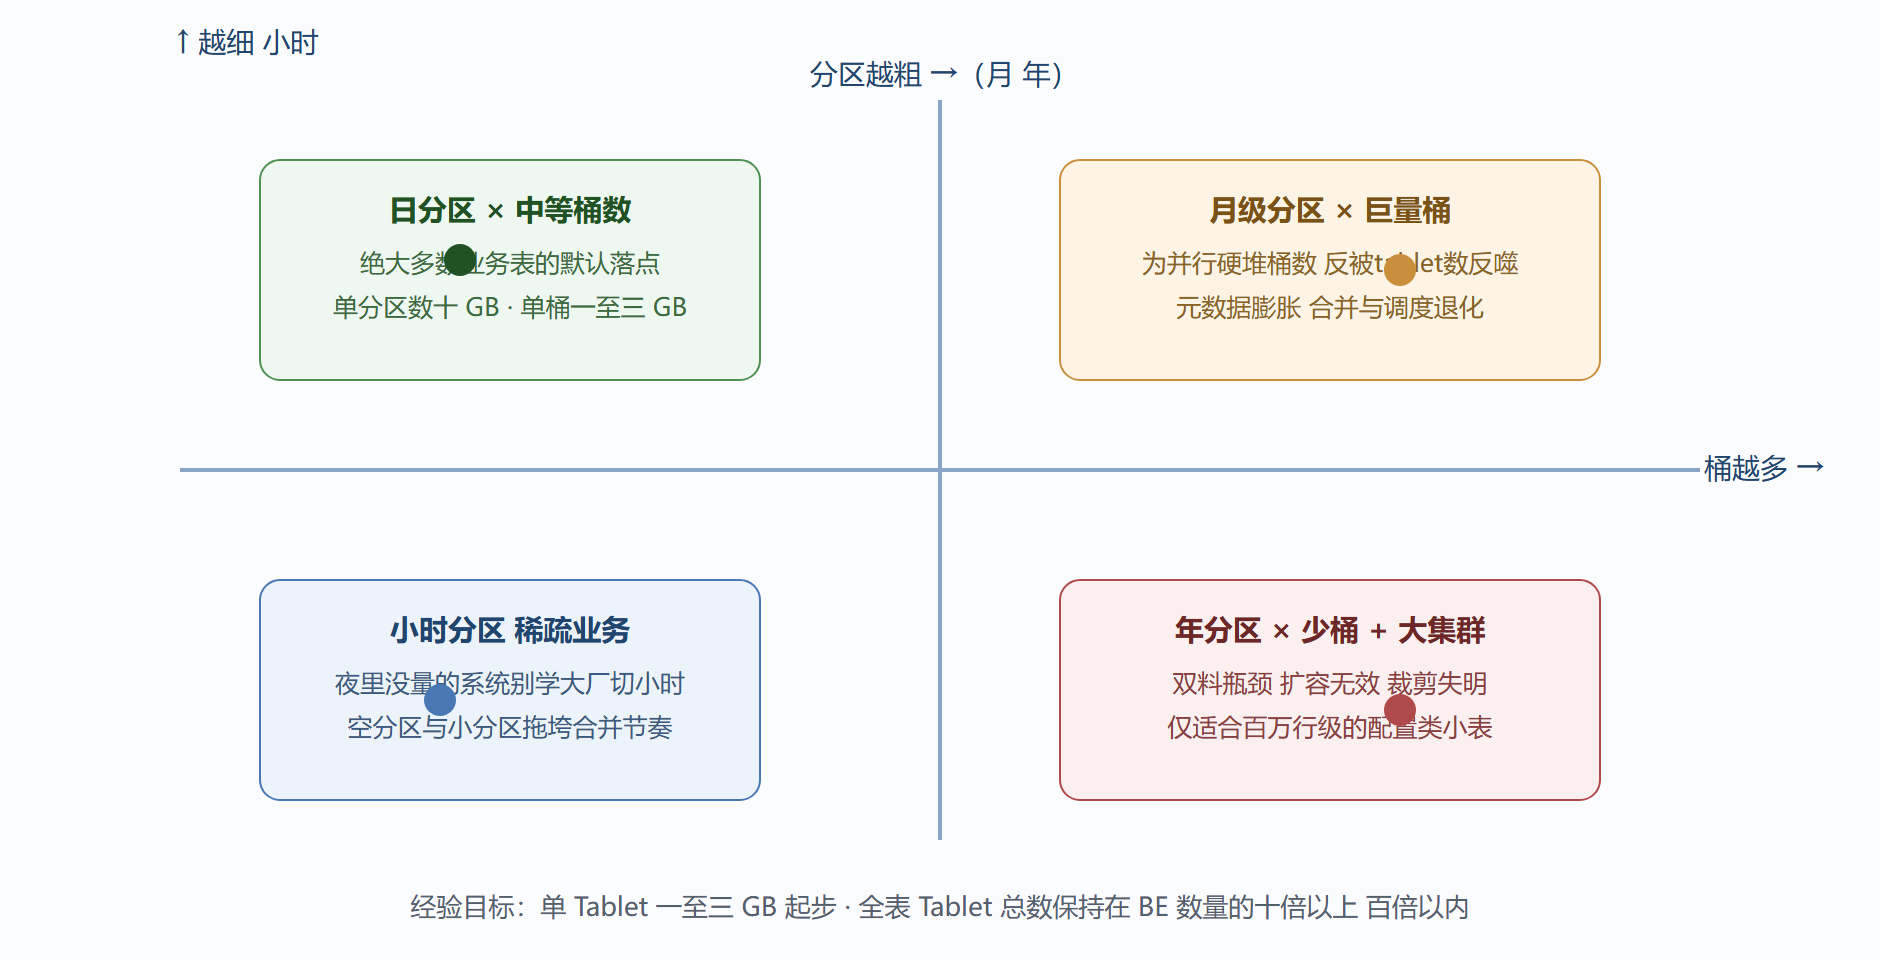
分桶(Distribution)在每个分区内横向打散数据,按哈希规则落到若干 Tablet 上。Tablet 是副本、迁移、均衡的实际载体——并行度天花板就是"参与扫描的 Tablet 总数",一旦定死就不再随集群扩容而改变。这直接导出本章最重要的一条工程常识:桶数建少了,后面加机器只是多了一堆闲人围观热点;反之桶数过多则 Tablet 数爆炸,元数据、调度和合并的开销一起上升。
图 3-3:分区 × 分桶两维坐标系与数量权衡
二、桶数的估算作业
用一个真实规模演算:日增两亿行的订单明细,三十天滚动保留,当前 BE 十二台。
- 日分区原始体量约四十 GB,压缩后落在十 GB 内外;
- 按"单 Tablet 一至三 GB"的下限取整,期望每分区约十至二十个 Tablet;
- 平滑扩容余量(计划一年内翻倍机器)乘上四倍系数,取 六十四桶作为最终值;
- 校验:全生命周期 Tablet 总数为三十个分区乘六十四约两千个,十二台 BE 每台承载一百六七十个 Tablet,处于健康区间。
三条修正条款要记牢:
- 必须以最大分区估算而不是平均分区——月末峰值决定了体验下限;
- 桶数建表后不可改,宁可初期偏多两成,也别给自己埋扩容僵局;新版本虽提供了在线调整分桶的能力入口,但历史分区的迁移成本仍然可观;
- 极小表(常驻几万行)不必机械凑桶数,单桶反而是最优解,否则元数据开销倒挂。
三、分桶键的选择纪律
哈希分桶的目标是均匀,因此基数高且稳定参与查询的列才是好材料:用户 ID、订单 ID 这类天然离散字段。反面教材有三个经典:
- 用时间列分桶:同一天的数据哈希后仍集中爆仓,等于没散开,导入高峰那几分钟所有写入挤进少数几个 Tablet;
- 用性别、状态等极低基数字段单列分桶:桶数超过基数后必然出现空桶与巨桶并存;
- 频繁变更的组合键顺序:分布看不见摸不着,直到某一台 BE 磁盘先满才暴露。
复合场景可以用「城市加用户尾号」这类组合但务必验证实际分布:
-- 验证候选分桶键的均匀性(示意) SELECT user_id % 64 AS bucket_guess, COUNT(*) AS rows_cnt FROM dwd_order_detail WHERE dt = '2026-08-25' GROUP BY bucket_guess ORDER BY rows_cnt DESC;
头尾比值若在一点五倍以内算合格,出现尾部巨大的长尾就得换键或加盐处理。
四、让边界自己滚动:动态与自动分区
手工维护分区骨架很快就会被补数、回溯、跨年这些边角磨掉耐心。两个内置机制值得放进默认工具箱:
-- 动态分区:滚动的近九十天窗口 提前备好明天 ALTER TABLE dws_order_detail SET ( "dynamic_partition.enable" = "true", "dynamic_partition.time_unit" = "DAY", "dynamic_partition.start" = "-90", "dynamic_partition.end" = "1", "dynamic_partition.buckets" = "64" ); -- 自动分区:按落入数据的范围自己建区 长尾历史一次性导入友好 CREATE TABLE dws_merchant_bill ( bill_time DATETIME NOT NULL, amt DECIMAL(16,2) ) AUTO PARTITION BY RANGE (date_trunc(bill_time, 'month')) () DISTRIBUTED BY HASH(merchant_id) BUCKETS 8;
两者的分界线:访问模式规整的流水表用动态分区(可预测、可清理);历史冷数据批量灌入或日期分布稀疏的场景用自动分区(避免空区间白占骨架)。注意自动分区的裁剪依赖谓词能与分区表达式对齐——写 date_trunc(dt,'month') = 某值 能裁剪,写成对 dt 包函数的比较就可能整表扫。
⚠️ 常见坑:为了"看着整齐"给小时级流量极低的表配小时分区,换来几千个空分区每天陪跑合并与校验任务。粒度跟着数据密度走,不跟 KPI 口号走。
五、Colocation 与分布式 Join 的伏笔
当两张表以相同方式分桶(同键、同桶数)时,关联操作可以省去 Shuffle,直接在同机本地完成——这就是 Colocation Join 的前提。它要求建模期就把相关的宽表与维表设计成同构分布,代价是失去独立重均衡的灵活性。哪个更划算取决于 Join 频率:每日几百次的核心星型关联值得买断,偶尔手动分析的长尾留给 Bucket Shuffle 或广播即可,选择留在第 5 章展开。
常见疑问
问:历史表当年没分桶建好,现在能改吗? 桶数与分桶键在分区创建后即固定,新建分区虽可声明不同桶数,但历史分区的迁移代价是一轮全量重写。更现实的路径是建新表双写、按分区批量回灌、校验后切读——把这次教训折算成下次建表评审时的一条硬性检查项,比迁移本身更有价值。
问:分区键必须参与查询条件才有意义吗? 是的,这是分区最容易被神话的地方。裁剪发生的唯一前提是谓词能与分区列对齐——不写时间条件的查询享受不到任何分区收益,反而因分区数量增加了一点点调度开销。分区策略要对着真实查询日志设计,而不是对着"方便管理"的直觉。
本节要点回顾
- 分区管生死与裁剪,分桶管并行与打散,两者不可互相替代。
- 桶数在建表那一刻封顶:按最大分区、留扩容系数,宁可略多。
- 分桶键第一原则是不倾斜:高基数、查询常用、分布已验证。
- 动态分区管流水,自动分区救长尾,表达式的形状决定裁剪成败。
- Colocation 是提前规划的奖励:核心关联是否买断本地化,建模期就要表态。
布局三板斧到此齐备。下一节进入全章高潮——一张订单宽表的完整建模复盘,看看这些原则如何在真实的评审拉扯中落地。