4.1 多样化数据摄入方式
4.1 多样化数据摄入方式
本节摘要:Doris 提供六条主流导入通道——Stream Load、Routine Load、Broker Load、S3 Load、Insert Into、以及生态连接器。它们的差异不在"谁能把数据送进来",而在延迟形态(同步秒级到异步小时级)、吞吐特征与失败恢复方式。本节给出完整的选型对照与每种通道的最小可用示例,并用两个真实案例说明选错通道的代价。
学习目标
阅读完本节,你应当能够:
- 用延迟、吞吐、触发方式三个属性描述任一导入通道;
- 写出 Stream Load 与 Routine Load 的最小配置并解释关键参数;
- 判断一个新业务应该走哪条通道以及为什么;
- 识别"用批通道跑实时需求"这类结构性错配。
一、六通道全景对照
| 通道 | 触发方式 | 延迟形态 | 吞吐上限倾向 | 典型来源 |
|---|---|---|---|---|
| Stream Load | 程序发起 HTTP PUT | 同步返回 秒级 | 单任务中等 并发可扩 | 微批采集器 应用直写 |
| Routine Load | 集群常驻作业 | 准实时 秒到分钟 | 高(分区并行消费) | Kafka |
| Broker Load | 提交异步 LOAD LABEL | 分钟到小时 | 极高 | HDFS 大文件 批量回灌 |
| S3 Load | 同上走对象存储 | 分钟级 | 高 | 对象存储 数据湖 |
| Insert Into | SQL 即席或调度 | 同步/异步 | 低到中 | 库内加工 外表转入 |
| 连接器(Flink 等) | 上游框架驱动 | 流式 | 取决于检查点间隔 | 实时计算链路 |
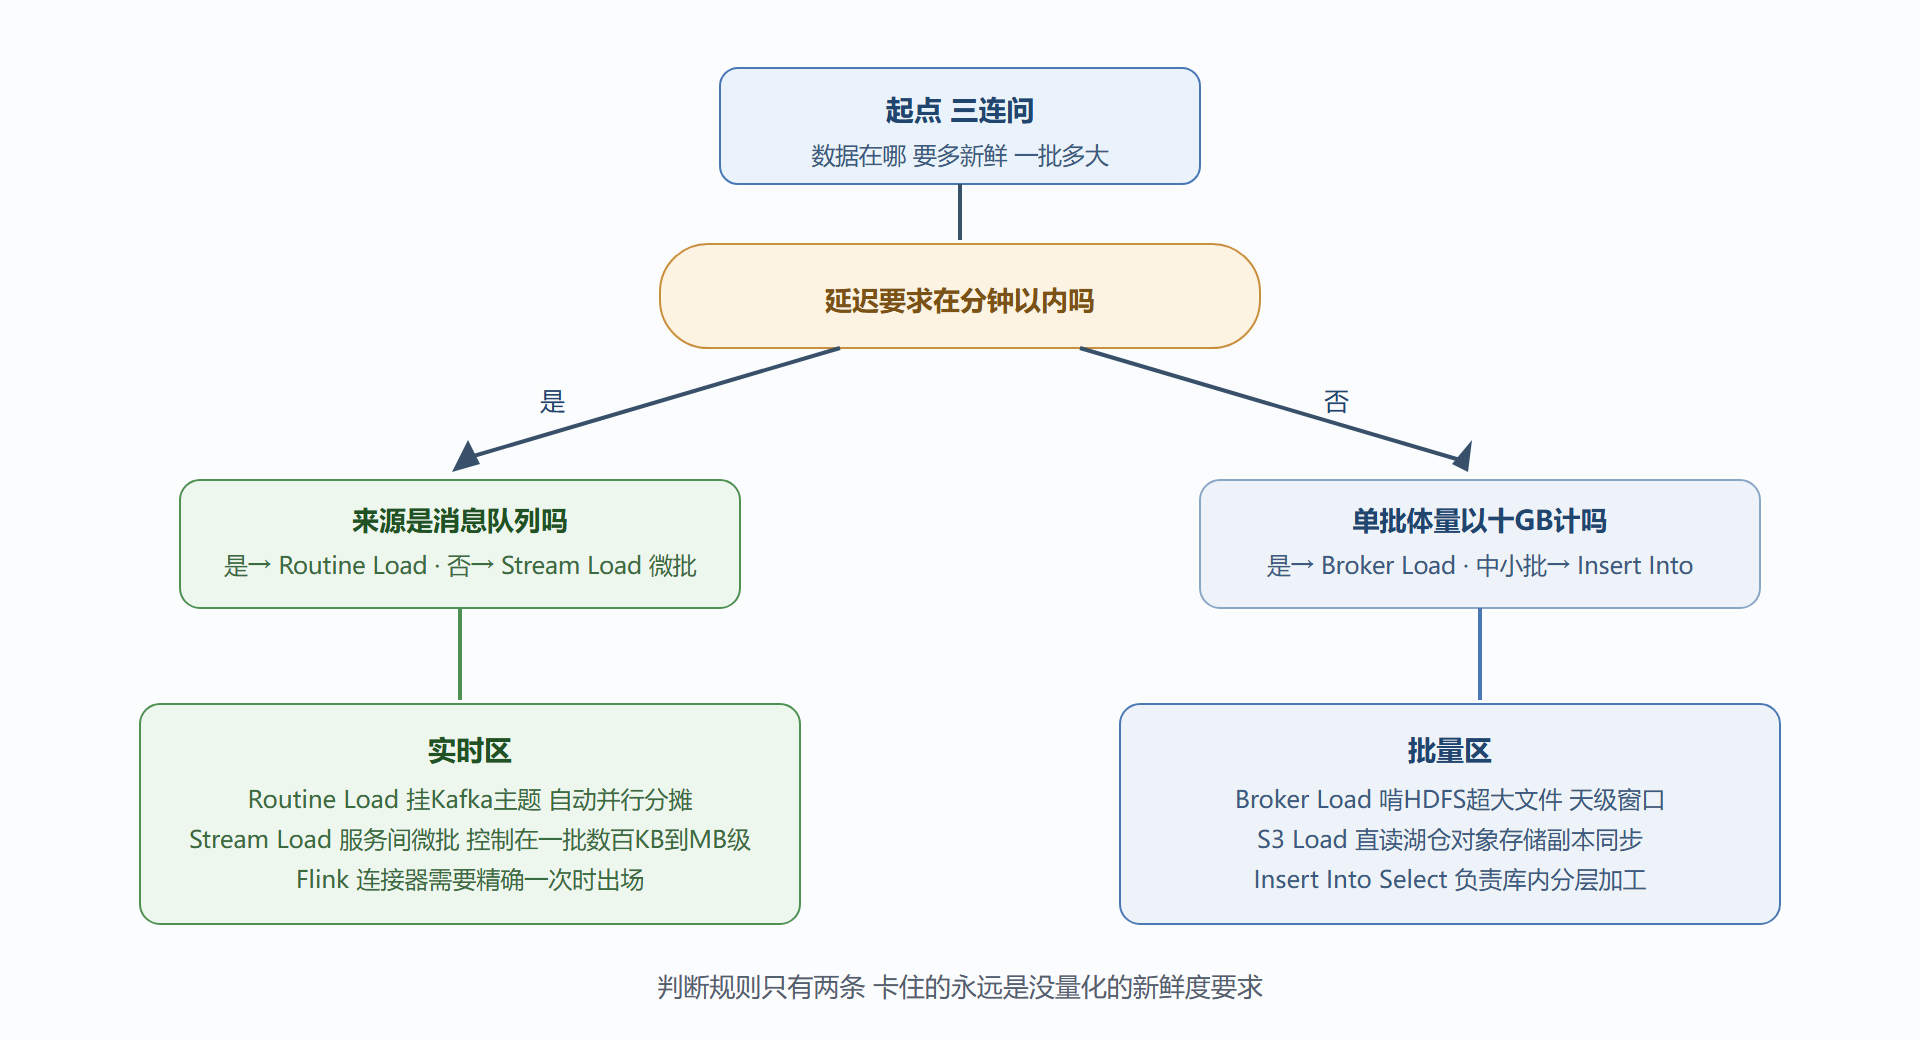
挑选的思考顺序是:数据在哪 → 要求多新鲜 → 单批多大。三问之后基本只剩一个候选;两个候选打架时比的是失败重放的运维成本,而不是峰值吞吐。
图 4-1:通道选择的决策流与典型落位
二、逐个过一遍最小可用形态
Stream Load 是唯一同步的通道,适合程序化微批:
curl -X PUT -u user:password -H "Expect:100-continue" -H "label:order_20260827_0007" -H "format:csv" -H "column_separator:," -T orders_batch.csv "fe-host:8030/api/sales/dwd_order_detail/_stream_load"
响应里的 Status 若为 Success 且已有同名 Label 被成功使用,会返回 Label Already Exists——这正是幂等语义在工作:上游只管按订单号拼 Label 重试即可。
Routine Load 让集群自己消费 Kafka:
CREATE ROUTINE LOAD sales.rl_order ON dwd_order_detail PROPERTIES ( "format" = "json", "max_batch_interval" = "10", "desired_concurrent_number" = "3" ) FROM KAFKA ( "kafka_broker_list" = "kafka1:9092,kafka2:9092", "kafka_topic" = "order_events", "property.group.id" = "doris_rl_order_v1" );
desired_concurrent_number 决定单个作业内部的并行度,配合 Kafka 分区数与 BE 数取最小公倍思路规划。改过 group id 后消费者组从零起算 offset,务必想清楚是从头补数还是接着消费。
Broker Load 的骨架是一条带 Label 的异步语句:
LOAD LABEL sales.backfill_202608 ( DATA INFILE("hdfs://nn/user/etl/dwd_order/20260826/*") INTO TABLE dwd_order_detail FORMAT AS "orc" ) WITH BROKER "hdfs_broker" PROPERTIES ("timeout" = "14400");
百万行级的月度回灌都走这里;超时参数要给足,因为它后台跑着你在客户端早就下班了。
三、两个选错通道的真实案例
案例一:拿 Insert Into 攒实时看板。 一个五个节点的集群被安排每三十秒执行一次 INSERT INTO SELECT 从外部 MySQL 抽数。结果 FE 计划缓存被打爆,查询 P99 反而劣化了两倍。根因是该负载本质是流式订阅,正确答案是 Kafka 加 Routine Load——迁移当天看板延迟降到二十秒内,FE CPU 从九成掉到两成。
案例二:拿 Stream Load 回灌三年历史。 运维脚本循环调用 Stream Load 发起了四万个小批次任务,版本计数一路飙升触发保护性拒绝(详见 4.4)。换成按月生成的 Broker Load,同等数据量从预估的十一个小时缩到五十分钟,且全程无版本告警。批量的归批量,实时的归实时——这条边界越早划清越好。
⚠️ 常见坑:Stream Load 指向了 BE 地址却在应用侧写死单节点。请求会被 302 重定向,多数 HTTP 客户端默认不跟随 POST/PUT 的重定向,表现为莫名其妙的连接错乱。要么直连正确的目标,要么显式开启跟随。
四、Group Commit 与高频小写的折中
物联网与监控类业务常出现"几千路传感器、每路一秒一条"的小写洪流,直接打 Stream Load 会把资源耗在调度而不是搬数据上。攒批提交(Group Commit)在服务端把这些小写入自动凑批发往同一张表,对外仍然保持插入语句的简单形态。它的代价是提交节奏由服务端控制,客户端感知到的可见延迟略有增加——对绝大多数指标类场景完全够用。用它,还是老老实实建设备网关做应用侧攒批?经验是:先试 Group Commit,量化瓶颈后再决定是否引入网关组件。
常见疑问
问:一次性的中等规模数据(几千万行)选哪个通道? 决策顺序是:已在对象存储或 HDFS 且格式规整,走 Broker Load 异步批量,客户端零等待;数据在应用内存里且调用方要同步确认结果,走 Stream Load;有 MySQL 连接且数据可由一条 SQL 表达,Insert Into Select 最省事。判断的主轴是"调用方要不要等"与"数据在哪",规模本身反而是次要变量。
问:多个通道能混着用吗? 能且常见——实时增量走 Routine Load、每日补数走 Broker Load、临时修正走 Insert,各自发挥所长。要守住的是并发总量:任何时刻在途的导入任务数与总吞吐要纳入监控(4.3 的两条曲线),混用不等于无序叠加。
本节要点回顾
- 六通道一张表记牢:延迟与吞吐各有所长,没有全能选手。
- 选型三问先行:数据在哪、多新鲜、多大一批。
- Label 幂等让重试无害:上游敢重放是整套体系的地基。
- 错配案例的共同点:都在用错误的节奏喂养引擎。
- 小写洪流先开攒批提交:确认瓶颈前不要急着加组件。
通道选好了,下一节深入最微妙的一环——主键表的覆盖更新在引擎内部到底怎么发生。