4.2 主键模型的实时更新机制
4.2 主键模型的实时更新机制
本节摘要:Unique Key 表如何做到"同一主键只看到最新版本"?答案藏在两条路径里:读时合并把成本留给查询,写时合并把它前置到导入。本节拆开 MoW 的执行序列——内存索引查询、删除位图生成、可见性切换——并解释为什么它对"高并发点查加持续更新"的画像表组合效果拔群,又在什么前提下变得昂贵。
读完你应当能够
阅读完本节,你应当能够:
- 完整复述一次 MoW 导入的五个步骤;
- 计算一个具体场景下 MoR 与 MoW 的读写开销分摊;
- 使用 DELETE 语句与批量删除通道正确执行删除语义;
- 判断自己的 Unique 表是否应该从 MoR 迁到 MoW;
- 说明列更新(部分列替换)在两种模式下的行为差异。
一、覆盖更新的两个买单位置
基础事实先摆出来:存储层的文件不可变,所以"更新"永远是一种幻觉——真实发生的只是追加一个新版本,再加一套"哪个版本说了算"的裁定规则。
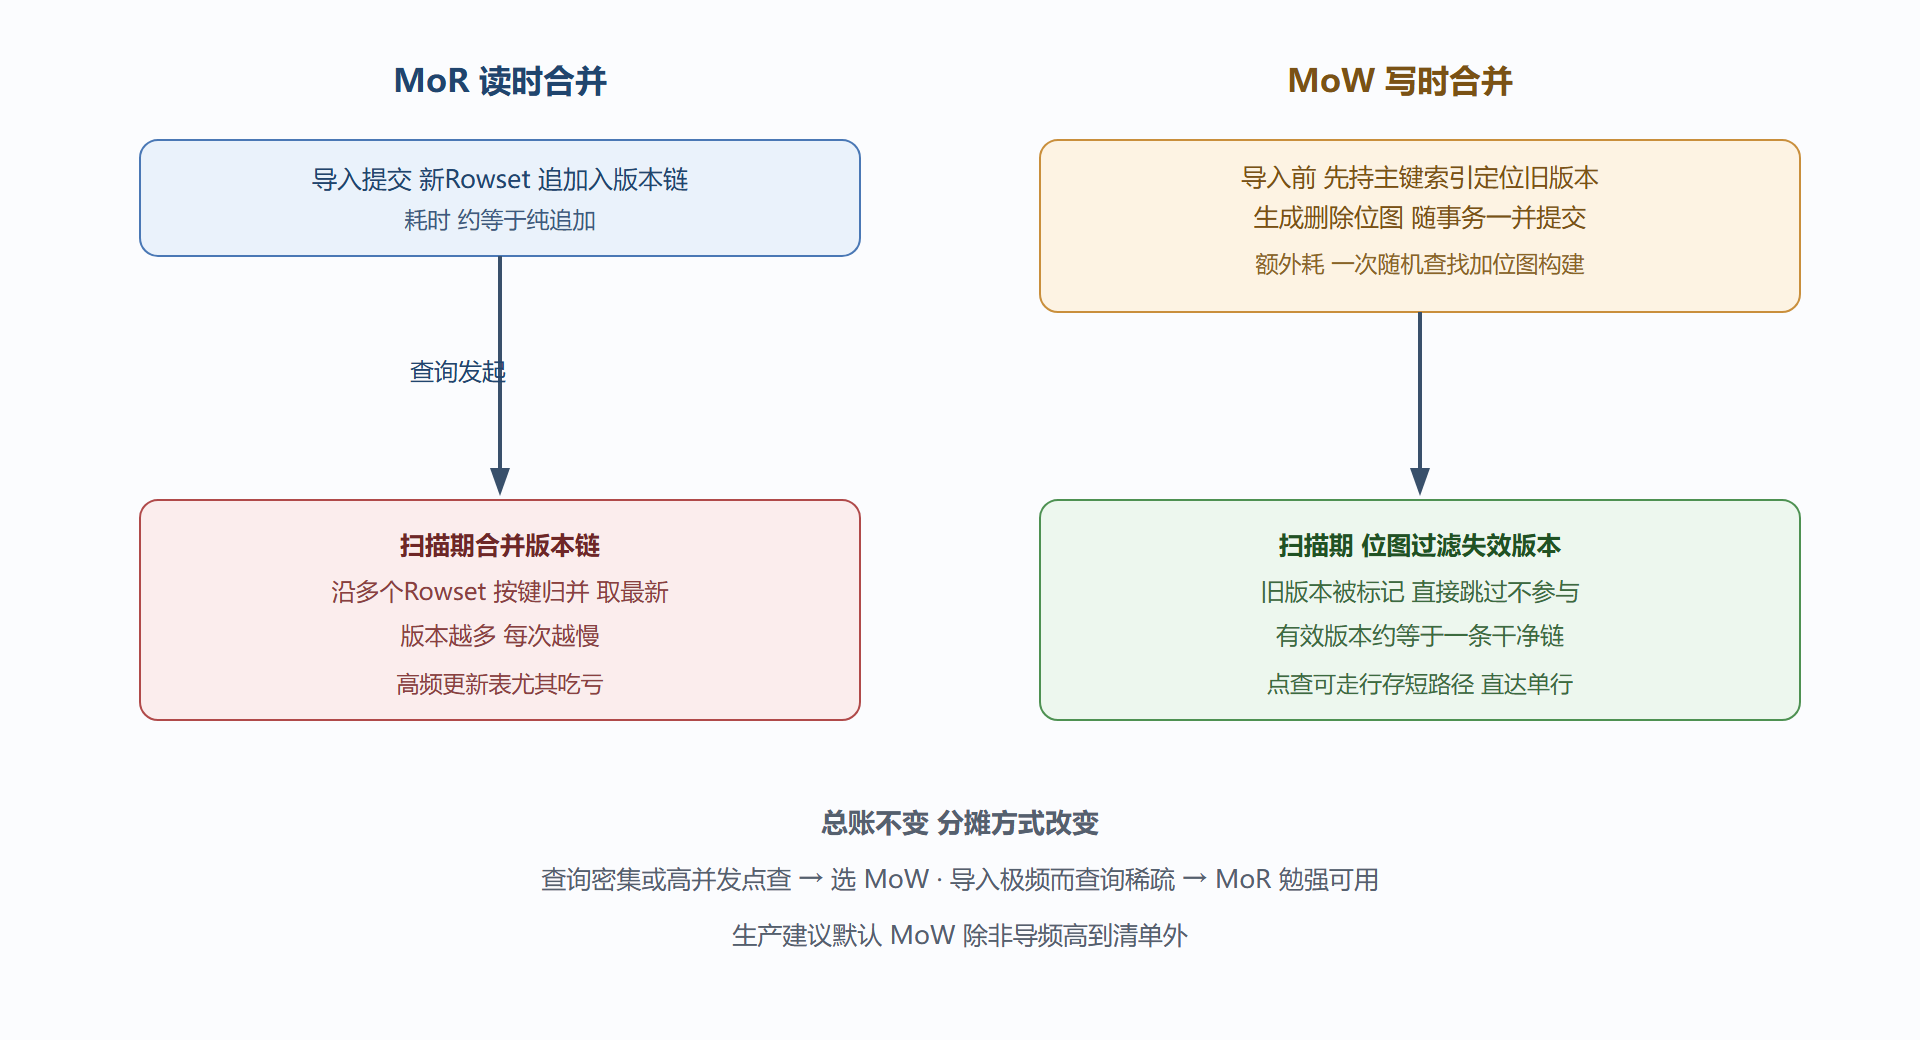
MoR(Merge-on-Read) 的规则最朴素:所有版本都留着,查询时按主键排序归并取最新。写入侧几乎免费,代价均匀地摊在每一次查询上。它像一间从不整理的仓库:进货快,找东西每回都要翻全部货架。
MoW(Merge-on-Write) 把裁定提前到写路径:每次导入先把这批新数据的主键拿去查已有数据的落位,生成一份删除位图,标记"这些旧版本从此作废",然后把删除位图与新 Rowset 作为同一个事务提交。此后查询读到的是近乎干净的追加流。它是那间每次进货都顺手销毁旧货签的仓库:进货慢一点,逛起来飞快。
图 4-2:同一次订单状态更新在两种模式下的路径
二、MoW 导入的五步完整序列
以一张用户画像 Unique MoW 表接收一批标签更新为例:
- 解析与切分:数据进入 BE 后整理成结构化批次,按分桶规则路由到目标 Tablet;
- 主键索引探查:借主键索引(2.x 已支持持久化形态,随 Rowset 落盘)找到新批键值命中的既有行组;
- 删除位图构建:为命中的旧版本生成段级位图,这一步是新批次专属的、跟着事务走;
- 原子提交:位图加新 Rowset 以同一版本号对外可见,可见瞬间旧版本逻辑消失;
- 后台收尾:Compaction 择机把位图指向的死版本物理清除,回收磁盘空间。
性能特征由此可以推演:批次越大,摊薄后的单位探查成本越低;主键越集中命中(同一批里大量重复键),位图收益越高。反过来,如果你的导入是「几秒一批、每批几十行」,MoW 的固定开销会显得嘈杂——这正是 Group Commit 或上游攒批该出场的信号。
一笔开销账。设每天五千万次主键更新、白天每分钟约一万条查询:MoR 下每次点查要多走版本链合并,平均延迟多付一至两毫秒就是每天十几小时的聚合浪费;MoW 下每次导入多一次索引探查,合计增加的 CPU 不足集群容量一个百分点。结论显然偏向 MoW。换成每三十秒一批、全天近三千批的高频小导入且夜间基本无查询的采集场景,天平立刻翻面。
三、删除语义的三种姿势
Unique 表的删除常见三种来源:
-- 一、条件删除 全分区内的明确条件即可 但注意它作用于所有历史分区中满足条件的行 DELETE FROM dws_user_profile WHERE dt = '2026-08-26' AND user_id = 10086; -- 二、按分区整体删除 秒级完成 且直接释放磁盘 ALTER TABLE dws_user_profile DROP PARTITION p20260501; -- 三、批量删除通道 在导入文件里携带删除标记列 由任务声明 DPP 处理 -- 适合上游给的是"对账差集"的场景 见下游Broker Load 的 delete 条件配置
第一种的实现同样依赖谓词生成删除位图,条件复杂时会退化为逐行评估,代价不容忽视;第二种是生命周期管理的正途;第三种在血缘清晰的对账链路里最省心。
四、部分列更新:宽表的最后一公里
画像与指标拼装场景经常出现"每个来源只更新自己的那几列"。开启指定列更新属性后,导入可以只带部分列,未出现的列保留原值(或按 REPLACE_IF_NOT_NULL 语义处理空值)。这条特性让宽表拼装不需要在上游维护全量视图,但有三条纪律:更新频率控制住,别让同一行在一天内被几十个来源轮番改写;关键列的空值语义要在评审时白纸黑字写清;尽量让同源更新走同批次,减少版本链抖动。
⚠️ 常见坑:部分列更新叠加高频率调用,直接把某张热点大表变成写入放大器。判断标准还是老朋友——看 Compaction 分数与导入延迟曲线是否共振上扬。
五、从 MoR 平滑迁到 MoW
存量 MoR 表的迁移没有在线开关——本质上要重建数据。可行路径两条:新建 MoW 表双写灰度后切流量(参照 3.4 的做法);或在低峰窗口用 INSERT INTO SELECT 从自身全量重建到备份表再换名。无论哪条,都请先把"每天真正被更新多少行"测清楚——大量所谓更新密集型表实测日变更率不足百分之一,为它们承担 MoW 的写入溢价并不划算。
常见疑问
问:MoW 的主键索引占多少内存? 2.x 起索引随 Rowset 持久化落盘,常驻内存的只有热路径的缓存部分,整体成本与主键列的字节数和数据总量成正比。评估方法很直接:主键列宽度乘以全表行数,再按命中缓存的预期比例折算内存占用——一条十亿行、主键十六字节的表,量级在十几个吉,多数集群可以平静接受,但要用自己集群的实测说话。
问:同一批数据里出现重复主键怎么办? 以批次内最后一次为准——导入内部的裁定规则与表模型一致,按键保留最新。这意味着上游无须为批次内去重做预清洗,但也意味着"顺序"成了隐含契约:上游要保证最终态的写入最后到达,乱序重放的链路要带版本或时间戳列参与裁定。
问:能不能用 Unique 表当队列用(频繁插入又频繁删)? 不建议。高频插入加高频删除的组合会把删除位图与压实任务同时推向高位,读写双方都受害。队列语义的正确载体是消息系统;仓库里的"删除"应当是低频的生命周期动作或对账修正,两种节奏别混在一起。
问:MoW 表做全量历史修正(比如回刷一年的标签)要注意什么? 把大修正拆成按分区的中批次串行执行,别一口气灌:海量键的一次性探查会把主键索引缓存全部挤穿,删除位图也会在压实前堆积出第二个"版本高峰"。回刷窗口避开日常导入高峰,进度按分区对账——修正也是导入,同样受这套机制的约束。
问:怎么实测一张表该用 MoR 还是 MoW? 采集两个数字观测一周:日均更新行数与日均查询命中行数。更新占比高、查询侧以点查为主,MoW;几乎只写不更新、查询以大范围扫描为主且频率低,MoR 的写入廉价才有意义。用数据回答,别用习惯回答。
本节要点回顾
- 更新的本质是版本裁定:MoR 查询时裁,MoW 写入时裁。
- MoW 五步序列:路由、探查、位图、原子提交、后台清理。
- 选择看读写乘积:查询次数乘版本深度是 MoR 的税基。
- 删除优先走分区与批量通道:条件 DELETE 是精确武器不是日常扫帚。
- 部分列更新有纪律:控频率、定空值语义、同源同批。
机制吃透了,下一节解决工程侧剩下的半壁江山——怎么盯着成千上万的导入任务不出事。