7.1 集群部署与扩缩容
7.1 集群部署与扩缩容
本节摘要:部署犯的错会在半年后以故障的形式计息。本节给出一套经过生产验证的部署账本:FE 按稳态配、BE 按弹性配,磁盘宁可多块也不要单块大;扩容不是加上节点就完事,数据再平衡的那几个小时有明确的观察点;缩容的每一步都要先问"副本补齐了吗"。文末附多租户场景的物理与逻辑两级隔离方案。
学习目标
阅读完本节,你应当能够:
- 独立给出一个日增千万级表集群的 FE 与 BE 配置清单;
- 说出在线扩容过程中副本迁移的触发、限流与验收三个环节;
- 按正确次序执行缩容并验证数据冗余完整;
- 用资源标签与工作负载组的组合为三条业务线划定资源边界。
一、两类节点两张账
部署的第一性原则:FE 是稳态账,BE 是弹性账,两张账的算法完全不同。FE 承担元数据与调度,负载与数据量无关、与集群操作频率弱相关,三台奇数节点(多数派选举的最低要求)配中庸规格就足够撑起几百张表的集群——给 FE 堆硬件是预算错配,钱要花在数据平面。唯一要吝啬的是网络:FE 之间的复制链路与 FE 到客户端的服务链路都要走内网低延迟通道,跨机架部署时留意交换层的带宽。
BE 的账按数据量与扫描并发算。一条实用的起点公式:日增千万行、保留九十天的核心表,单表九十天约九亿行,三副本摊到 BE 上,配十二台十六核六十四吉、每台四块独立 SSD 的节点,可以舒适承载十几张这个量级的表外加看板流量。独立盘优于单张大固态——列存的顺序扫描是典型的多队列负载,四块盘的并行读带宽接近单盘的四倍,而成本只是多三个挂载点。BE 支持在线增减,初期宁可少配两台留出机架位,也别一次买满。
网络与机架拓扑是部署账本里最容易被砍掉的条目,砍掉的代价会在故障日全额补缴。两条底线:BE 之间的副本同步与 Shuffle 流量走独占的内网通道,与业务流量物理隔离——Shuffle 风暴挤占业务带宽的拥塞症状,排查起来比预防贵十倍;机架感知要真正配置起来,三副本落到三个机架,让"一个机架断电"从灾难降级为一次副本补齐事件。机架感知没配的集群,副本分布报表会诚实地告诉你三个副本挤在同一台物理交换机下——看到这行数字的那天,就是该补配置的那天。
-- 加入一台新 BE 并打上资源标签 用于后续物理隔离 ALTER SYSTEM ADD BACKEND "10.0.4.21:9050"; ALTER SYSTEM MODIFY BACKEND "10.0.4.21:9050" SET PROPERTY "tag.location" = "group_finance";
二、扩容的那几个小时:观察点清单
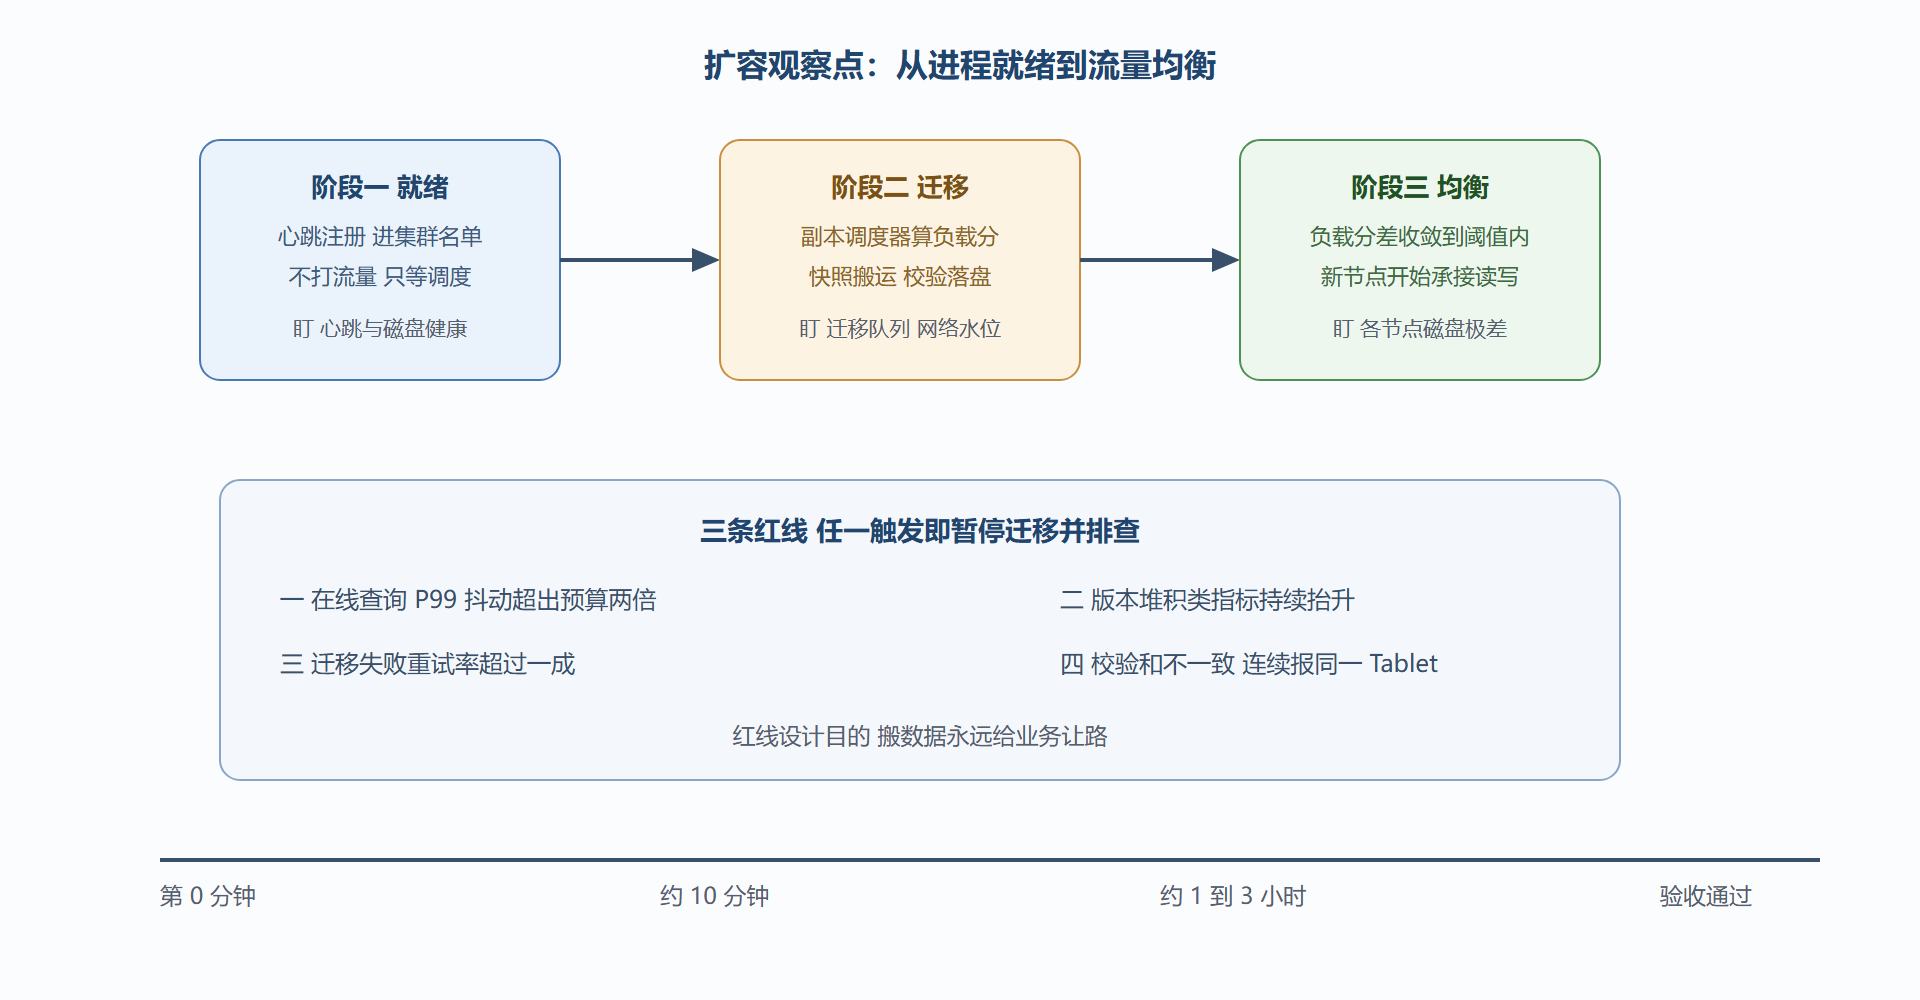
把一台新 BE 拉进集群,真正的交付不是进程起来了,而是数据再平衡完成。这个过程由 FE 的副本调度器接管,理解它才知道盯什么。调度器持续计算每个节点的负载分数——磁盘占用、副本数量、热度信息的加权——发现新节点的分数显著低于均值后,开始把老节点上的 Tablet 副本一个个搬过来。搬运走快照加校验和比对的路数:先在源节点对 Tablet 做快照,经网络落到新节点后逐字段校验,通过才更新路由元数据,任何环节失败都丢弃重来,不会出现搬一半的半成品副本。
限流是过程品质的关键。副本迁移默认以低优先级执行,避免挤压在线查询与导入——但大批量迁移叠加大促前压测时,仍要看三处:迁移队列的积压深度、集群网络带宽的水位、以及版本堆积类指标有没有因为搬运挤占 IO 而抬头。验收标准同样量化:各节点的磁盘占用极差收敛到个位数百分比、副本分布报表无悬空副本、扩容期间查询 P99 的抖动幅度在预设预算内。一套中型集群百 GB 级数据的再平衡,常见耗时在一到三小时,超过半天的多半是限流参数过紧或磁盘瓶颈。
三、缩容:先补齐,再告别
缩容比扩容危险,因为它主动制造副本缺口。标准次序是先把待下线节点的资源标签改掉,让调度器把它的副本在其余节点补齐到期望副本数;确认集群报表里该节点的副本计数归零,再执行节点下线。跳过补齐直接摘节点,等于同时删掉一批副本——如果恰好有 Tablet 的其余副本也不健康,就是一次真实的数据丢失事故。给缩容动作配一条硬性纪律:任何副本数低于期望值的告警存续期间,冻结一切缩容操作。
图 7-1:一台新 BE 加入后的数据再平衡全程
四、多租户:物理与逻辑的两级隔离
三条业务线共用一个集群时,隔离强度按需分级。物理隔离靠资源标签:给一组 BE 打上专用标签,敏感或重载业务建表时指定数据只落这组节点,从根上杜绝争抢——代价是这组节点利用率偏低,适合合规或 SLA 苛刻的核心业务。逻辑隔离靠工作负载组:所有业务共享节点,但各组有独立的 CPU 配额、内存上限与并发数,超配额的查询排队而不是抢跑——成本低、弹性好,是大多数内部分析场景的默认选择。
两种隔离可以叠用:金融条线的表落在专用标签节点上(物理),其内部再用工作负载组区分日常报表与临时探索(逻辑)。判断一笔共享集群的预算该花在哪,看业务的故障爆炸半径:看板挂十分钟没人报警的,逻辑隔离足够;财报数字错一分钟要发公告的,上物理隔离。
常见疑问
问:节点规格不齐(新旧机器混布)行不行? 行,但要主动管理。集群会把 Tablet 均匀分到各节点,规格不齐意味着老机器先被打满——用资源标签把老机器划入低优先级业务的布局,或者在均衡策略里给新旧机器设权重,别让调度器假装看不见硬件差异。混布集群的第一故障源永远是"最老的那几台"。
问:磁盘该留多少安全水位? 常规运行线定在七成:超过七成触发清理评估,八成五必须动手。留出的三成不是浪费——副本补齐、快照落盘、压实中间态都要在高峰期占用临时空间,水位打满的磁盘会让这些保护机制一起失灵,故障时的连锁反应远超"存不下"本身。
问:部署文档该沉淀到什么颗粒度? 达到"新人照着能重建一套等价环境"的程度:节点规格与角色、磁盘挂载与文件系统、资源标签规划、负载均衡与连接串分发、以及每项配置的改动理由。部署知识只有写到这个颗粒度,才在半年后的扩容与故障现场真正可用。
问:扩容前要不要停写入? 不要,在线扩容是设计内能力。要做的是错峰:避开导入洪峰与每日备份窗口,把再平衡的流量预算留给低峰时段。真正需要停写的是版本升级这类元数据动作,扩容与升级别排在同一个变更窗口里互相搅局。
问:怎么判断该扩容了? 三个前置信号:磁盘水位月增速推算出六个月内触顶;查询 P99 随并发线性抬升且资源组已无法压制;副本补齐任务的耗时持续变长。三条中两条出现,就把扩容立项——等第三条出现时,你已经在用故障倒逼容量规划了。
本节要点回顾
- FE 稳态 BE 弹性:两张账分开算,硬件预算向数据平面倾斜。
- 多块独立盘优于单张大固态:列存扫描吃的是多队列并行带宽。
- 扩容盯三处:迁移队列、网络水位、版本堆积,红线触发即暂停。
- 缩容先补齐再下线:副本缺口存续期间冻结一切缩容。
- 隔离分两级:故障爆炸半径决定用标签的物理隔离还是负载组的逻辑隔离。
集群跑起来之后,下一步是让它"会说话"——下一节拆监控指标的采集与读法。