7.2 监控指标拆解与告警
7.2 监控指标拆解与告警
本节摘要:监控体系失败的方式通常不是没装监控,而是装了一百个面板却回答不了"现在健康吗"。本节把 Doris 的指标世界压成一张四象限地图——负载、延迟、合并、内存——讲清四者的联动关系与告警阈值的定法,再给一条从指标异常到根因日志的固定排障链路。读完你应当能把值班面板从一百个格子砍到十二个。
学习目标
阅读完本节,你应当能够:
- 说清指标采集的拉取机制与 FE、BE 各自暴露的指标域;
- 用四象限框架定位"集群不健康"的具体象限并下钻到节点;
- 沿"指标异常、时间窗口、查询标识、节点日志"四步链路完成一次根因定位;
- 为三类核心指标设定带动态基线的分级告警。
一、先看采集层:指标是怎么到你面板上的
Doris 的 FE 与 BE 进程内嵌了指标暴露端点,以标准的文本格式对外提供指标快照,主流采集系统按周期拉取即可,无需在节点上装任何侵入式代理。这意味着两件实际的事:其一,接入成本几乎为零,采集器配好抓取目标,几分钟后指标就出现在存储里;其二,指标是"被问才答"的瞬时快照,抓取间隔决定了时间粒度——看板用十五秒粒度足够,做容量分析要另存长周期聚合。指标命名有约定俗成的语义结构:子系统、指标名、单位三段式,FE 侧集中在元数据操作、查询入口、JVM 运行态,BE 侧集中在扫描吞吐、合并任务、内存池,拿到一份陌生指标先按这个结构断句。
二、四象限地图:负载、延迟、合并、内存
上百个指标里真正日常值守要看的不过十几个,按四个象限归置:
| 象限 | 代表指标 | 健康特征 | 异常时先问 |
|---|---|---|---|
| 负载 | 每秒查询数、导入任务数、连接数 | 曲线随业务节奏平稳波动 | 谁在涨:新业务、重试风暴、还是攻击性脚本 |
| 延迟 | 查询 P95 与 P99、计划耗时 | P99 稳定在业务承诺内 | 涨幅集中在某类语句还是全面劣化 |
| 合并 | 合并积压分数、合并任务数 | 积压分数低位平稳 | 是导入洪峰挤压了合并,还是合并停滞 |
| 内存 | 进程内存、各内存池占用 | 水位高但有节奏地回落 | 哪个池在涨:查询池、导入池、还是缓存 |
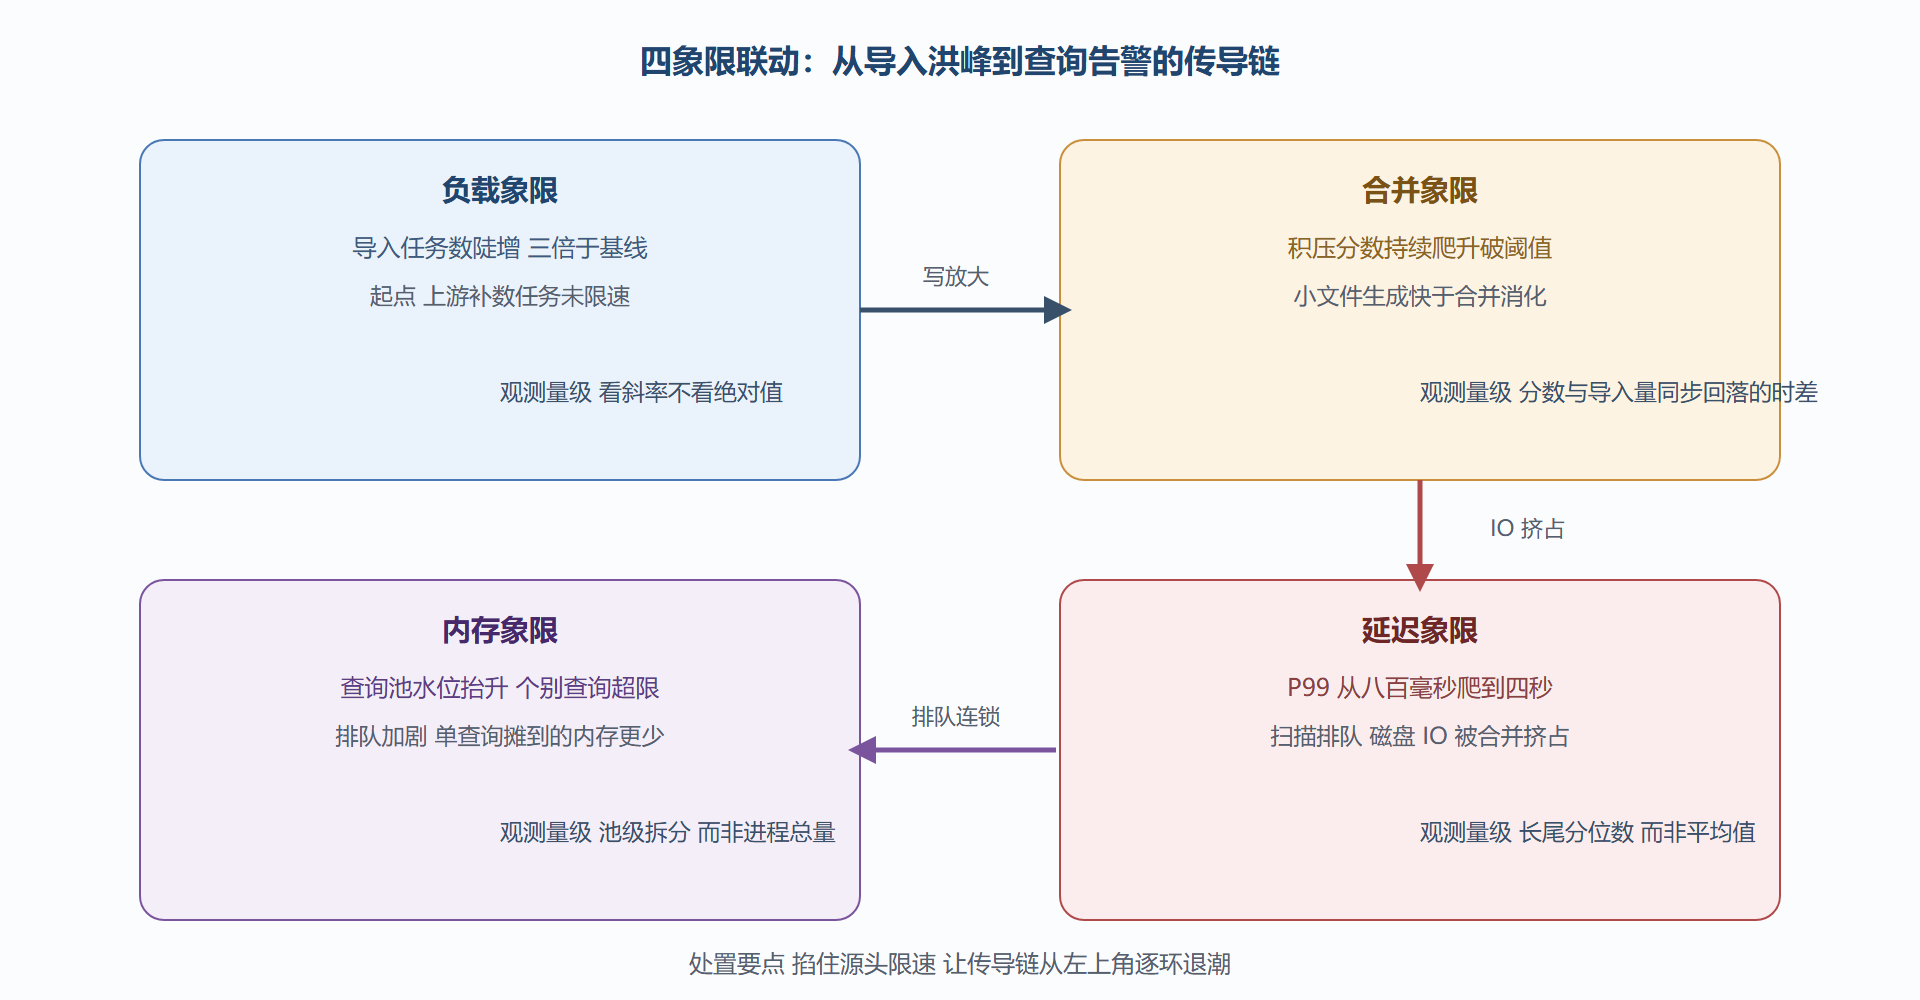
四象限的价值在联动读法。典型的传导链是:导入洪峰(负载)推高合并积压(合并),积压的合并任务占住磁盘 IO,查询扫描变慢(延迟),延迟升高让查询排队更久、内存池水位抬升(内存)——一个内存告警的根因可能在两小时前的导入配置变更。反过来读也一样:内存池异常上涨会触发查询失败重试,重试推高负载,负载再加剧合并挤压。单指标告警告诉你"哪里疼",象限联动才告诉你"为什么疼"。
图 7-2:一次导入洪峰在四象限的传导路径
三、排障链:从红色面板到根因日志
指标异常只是案发现场,定位要走固定的四步链。第一步锁时间窗:异常从哪个精确时刻开始爬升,前后五分钟内发生过什么——发版、扩缩容、导入策略调整、上游业务活动,一半的"灵异故障"在这一步就找到凶手。第二步下钻维度:按节点、按库表、按语句类型切片,确认是全局劣化还是局部热点——全局看基础设施(磁盘、网络、版本变更),局部看数据(倾斜、大表新增)。第三步拿查询标识:从延迟面板下钻到具体的慢查询标识,这是连接指标世界与日志世界的钥匙。第四步翻节点日志:拿标识去对应节点的运行日志里检索,内存超限、副本缺失、合并停滞这类根因都会留下结构化的错误记录。
这条链的效率取决于一个常被忽略的基础设施:查询审计日志的留存。它记录每条查询的标识、耗时、扫描量、命中状态,是第三步的素材来源。留存周期建议不少于十四天——覆盖一个完整的业务双周节奏,让"上周三也慢过一次"这类线索可回溯。
四、告警定级:让人只在需要时被叫醒
告警体系的失败模式是狼来了:阈值一刀切,白天黑夜一个标准,两周后值班群自动静音。改造分三步。其一,动态基线:负载类指标天然随业务节奏波动,用历史同时段数据生成波动区间,出区间才告警——早十点 QPS 涨五成是活动,凌晨三点涨五成是事故。其二,组合条件:单一指标异常大概率是噪音,"积压分数高 + 延迟抬头 + 磁盘水位高"三者齐发才是真故障,把这类组合固化为告警规则。其三,分级通道:警告级进日报不进夜呼,严重级(副本缺失、FE 切主)进值班群,致命级(多数节点失联、数据不可访问)电话叫醒。每一级对应明确的响应时限,超时自动升级。
一次实战处置验证过这套流程的价值:某天上午积压分数告警触发,值班同学沿传导链回溯,发现凌晨一条补数任务的并发翻了三倍——上游改了配置没通报。处置动作是把补数任务限速回原值,两小时后积压分数自然回落,全程无需重启任何节点。这类"掐源头、等退潮"的处置思路,比"先重启再说"高明在它留下了完整的数据证据链。
五、一张十二格的值守面板
把四象限落到实操,建议的面板布局是十二个格子分四行:第一行负载格(每秒查询数、导入速率、连接数),第二行延迟格(查询 P95 与 P99、计划耗时),第三行合并格(积压分数峰值、合并任务数、磁盘 IO 利用率),第四行内存格(进程内存水位、查询池占用、导入池占用)。每格一张曲线加一条动态基线,配色统一"越界变红"。整个集群的健康态在十秒内可扫完——这十秒就是监控体系的设计目标,任何做不到十秒扫完的面板都是在为难值班的人。
每周还要有一份人工动作:把当周触发过的所有告警按"真故障、噪音、重复"归类,噪音率超过四成就要回头修阈值。阈值不是一次配好的,它跟着集群规模与业务节奏持续演进——从这个意义上说,告警体系不是建成的,是养成的。
常见疑问
问:指标采集会不会影响集群性能? 影响可忽略。拉取式采集的代价是每次抓取生成一份指标快照,频率即便压到五秒一次,开销也在节点能力的千分位。真正的性能陷阱不在采集而在存储端:指标保存周期过长、基数标签设计过细(比如给每个查询 ID 建标签),会把监控系统自己的存储撑爆——标签设计守"可聚合、有限集"原则。
问:告警阈值怎么定才不拍脑袋? 三段法:先用历史数据看指标的自然分布(P50 与 P99 各在哪);再把阈值放在"正常波动之上、故障水位之下"的间隙里;上线两周后按误报率回调。任何直接抄来的阈值都要重新校准——集群规模不同、业务节奏不同,别人的数字只能当起点。
问:Compaction 积压分数的告警线怎么设? 比绝对值更重要的是趋势:分数随导入高峰起落是健康的,设定"高峰回落时限"类告警(如高峰结束后两小时内未回落到基线)比"分数超过某固定值"更精准。固定值告警在导入低谷期会漏报慢积压,在洪峰期又会误报正常堆积。
本节要点回顾
- 四象限压平面板:负载、延迟、合并、内存,十几个指标覆盖九成值守场景。
- 联动读法找根因:单指标说哪里疼,象限传导说为什么疼。
- 四步排障链固定化:时间窗、维度下钻、查询标识、节点日志。
- 审计日志留十四天:跨周对比的素材库,第三步的命脉。
- 告警三改造:动态基线、组合条件、分级通道,把夜呼留给真故障。
监控让你看见病灶,但有些病灶在线处置无解——下一节讲最后防线:备份恢复怎么做才敢在深夜按恢复键。