8.1 数据生态对接
8.1 数据生态对接
本节摘要:一个仓库再快,孤悬在生态之外就只是昂贵的硬盘。本节把对接工作组织成"铁三角":数据流入决定时效上限、任务编排决定可靠下限、数据消费决定价值兑现——三层各有一个从旧范式到新范式的切换点,也各有一组容易踩坑的接缝。读完你应当能为自己的业务画出完整的端到端链路图,并说清每一段的时效承诺由哪个组件兑现。
学习目标
阅读完本节,你应当能够:
- 为变更捕获链路选配消息队列与常驻导入任务,并设定各段的时效预算;
- 把散落的定时脚本重构为声明式编排的依赖图,接上重试与血缘;
- 用四个质量特征评估 BI 消费层的成熟度;
- 识别链路里最容易断裂的三处接缝并预置监控。
一、流入:从批量搬运到变更捕获
铁三角的第一角是数据怎么进来。旧范式的批量搬运(每天凌晨全量抽一遍)在 4.1 已经算过账,这里讲新范式:变更捕获加消息队列加常驻消费。数据库的变更日志被捕获组件实时解析成结构化事件,写入消息队列缓冲解耦;仓库侧的常驻消费任务订阅队列,按批拉取写入目标表。整条链路的意义在于把"数据新鲜度"从调度周期解绑——T 加一变成秒级,而代价是链路上多了两个活性组件。
组件选择的决策点有二。捕获端看源库类型与运维成本:主流关系库都有成熟的日志捕获组件,选型的关键其实是团队对哪个技术栈更熟——捕获组件常驻在生产库旁边,故障处置的熟练度比功能清单重要。消费端就是第 4 章的 Routine Load:声明订阅的队列主题、数据格式与目标表映射,常驻任务自动并行拉取,断点续传与错误重试内建。两段之间用消息队列解耦是纪律而非偏好——没有缓冲层的直连链路,源端一次流量尖峰就会把仓库导入打穿。
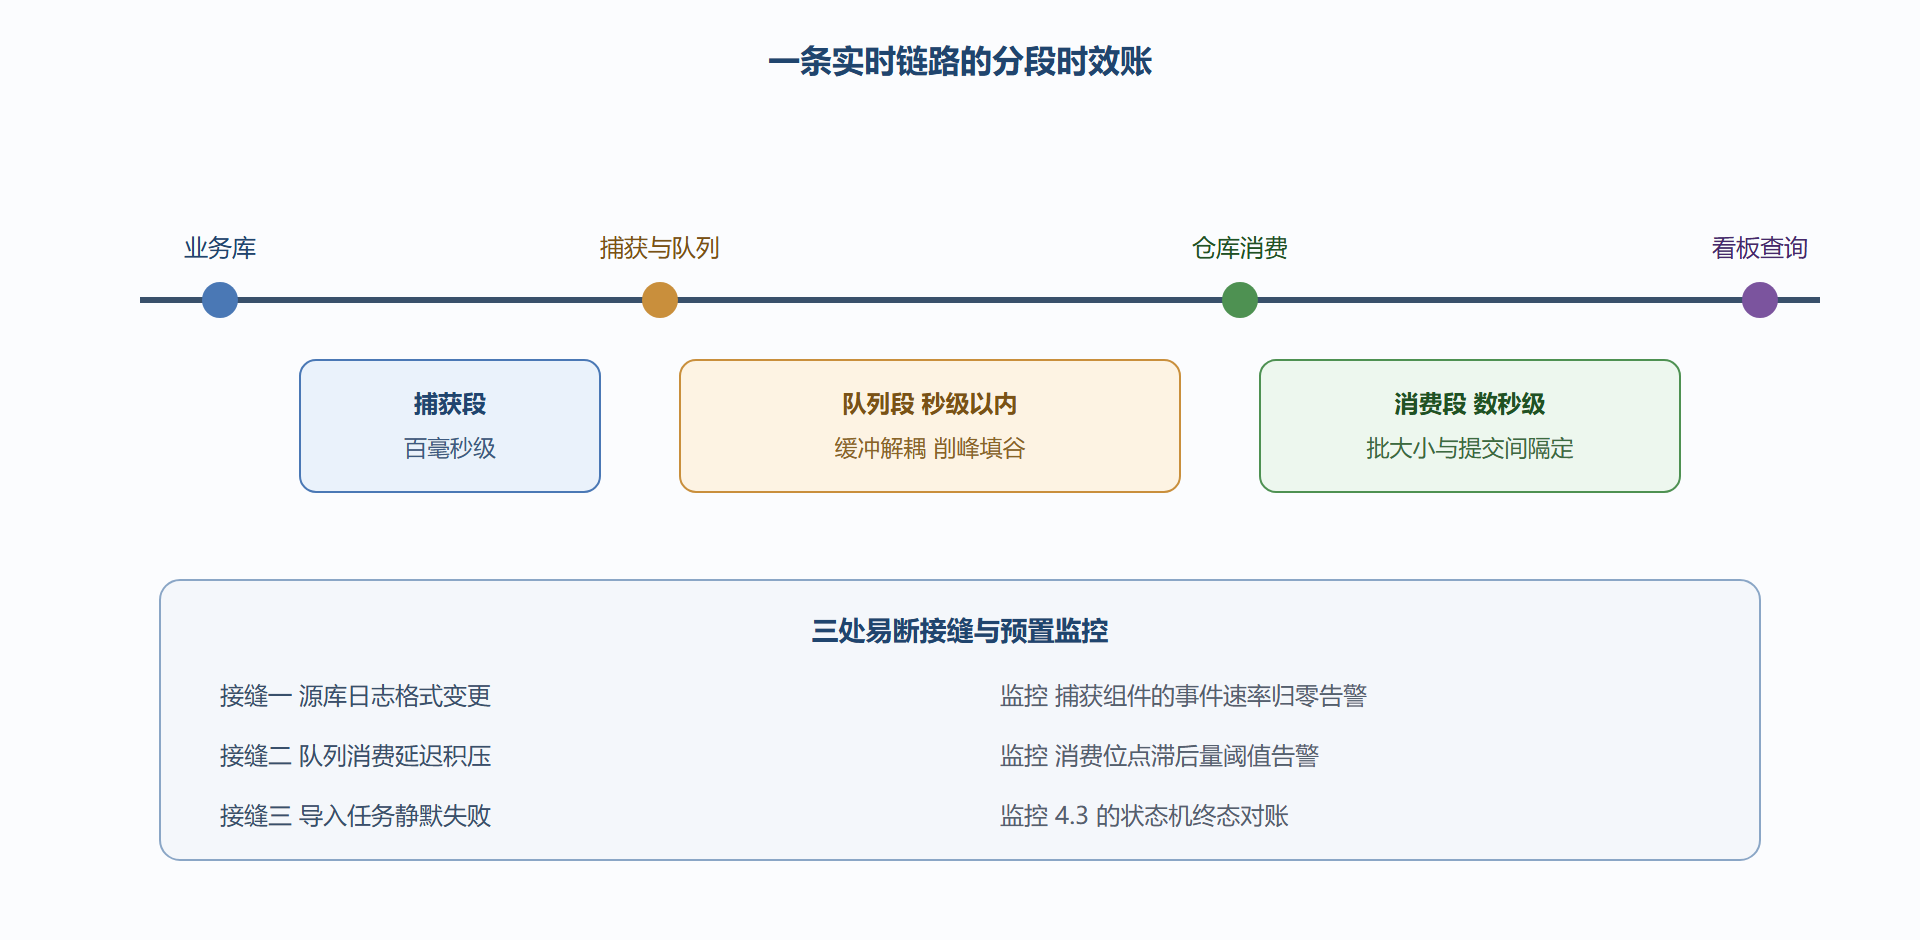
时效预算要分段定而不是整体定。一条典型链路的预算分配:捕获段百毫秒级、队列段秒级以内、消费段受批大小与提交间隔控制。业务提出的"实时"诉求必须翻译成每段的数字承诺,否则排障时无法定位延迟产生在哪一段——8.2 的风控样本会展示一份完整的预算表。
二、编排:从脚本拼接到声明式依赖
第二角是任务之间怎么协作。散落各机的定时脚本是小团队的常态,也是事故的温床——没有依赖表达、没有重试语义、没有全局视角,任务 A 失败了任务 B 照跑,产出一批基于残缺数据的报表。现代编排系统(Airflow、DolphinScheduler 及同类)把任务抽象成依赖图:每个节点是原子任务,边表达依赖,上游成功下游才触发,重试、超时、告警都是节点级配置。
对接仓库的方式优先走声明式算子:编排系统提供的数据仓库算子直接执行 SQL 或调用导入接口,配置即代码。把 4.1 到 4.3 的导入任务、6.1 的物化视图刷新、7.3 的快照备份统一收进同一张依赖图,是编排收益最大化的做法——数据链路的全景从此只有一张图,新同事接手值班的成本从一周降到一天。
血缘是编排的进阶要求。任务级血缘(哪个任务产出哪张表)在编排系统里天然可得,值得补的是字段级血缘与变更感知:上游表结构变更时,依赖它的下游任务能被自动标记受影响。这一步对接数据目录类组件,成本不低,但回报在高价值场景立现——"这张报表的数字能信吗"的质询,从半小时的人工排查变成一次血缘图谱查询。
图 8-1:端到端链路的时效预算分配
三、消费:BI 层的四个质量特征
第三角是数据怎么出去。连接层面几乎没有门槛——仓库兼容 MySQL 网络协议,主流 BI 工具即插即用;真正拉开差距的是消费层的质量。四个特征可以作为评估清单:语义层有没有建立——指标口径(GMV、留存率的定义)沉淀在统一的语义层,还是散落在每张报表的 SQL 里;缓存策略有没有设计——首页大盘这类高频查询是每次现算还是命中缓存;交互深度够不够——从总览到明细的下钻是流畅的联动查询还是预制的多张静态页;权限衔接是否完整——6.3 的行列级策略与 BI 工具的用户体系有没有打通,还是全员共用一个高权限账号。
第四个特征最常被跳过也最危险。BI 工具直连仓库的服务账号一旦权限过宽,6.3 辛苦建起的策略体系就被整体绕过——治理的最后一公里在消费端收口。
四、一次真实链路的落地记录
背景:某零售企业的会员分析链路,旧架构是每晚全量抽数,报表 T 加一,营销部门抱怨活动期间看不到实时转化。改造目标:会员与订单数据准实时可见,活动期间端到端延迟不超过一分钟。
操作:捕获段选用社区成熟的日志捕获组件对接核心交易库,输出标准化变更事件;队列段按活动峰值三倍冗余设定分区数;消费段为会员表与订单表各建一条 Routine Load,Unique 模型承接会员状态更新,明细模型承接订单事实;编排系统把六个小时任务与两条实时链路纳入同一张依赖图,物化视图刷新挂在导入完成事件之后;消费段接入 BI 工具并为营销团队单独建角色,行级策略按大区过滤。
结果:活动期间端到端延迟实测四十秒上下,预算表内;一次源库大版本升级导致捕获组件停摆二十分钟,事件速率归零告警三分钟内触发,补数走队列回放,下游零感知——预置的三处接缝监控全部派上用场。
解读:这次改造的真正杠杆不是某个组件的选型,而是"时效预算分段"的思路:把"一分钟"拆成三段的数字承诺后,每段的责任边界清晰,排障从全链路猜谜变成单段定位。变式思考:若业务把延迟要求收紧到五秒,队列段与消费段的批模式就要重议——时效每收紧一个量级,成本曲线都不是线性增长,先问业务愿为这五秒付多少,再动架构。
常见疑问
问:小团队要不要一上来就建设完整的铁三角? 按业务时效的真实压力分级起步:报表能容忍小时级,调度加批量导入就够,实时链路的三件套先不建;一旦出现"分钟级新鲜度有真实消费者"的需求,再补捕获与队列。铁三角是能力储备不是基础设施竞赛——每多一个常驻组件,就多一份监控、升级与值班的长期税。
问:源库直接抽数和走变更捕获怎么选? 看三个条件:源库能否承受周期性全量扫描的负载;业务要的时效是否低于抽数周期的下限;是否有历史数据初始化的需求。三条件里时效是硬门槛——要分钟级就只有捕获一条路,要天级则全量抽数简单可靠,初始化与增量的衔接用"先全量快照、再从快照位点接增量"的标准套路闭合。
问:编排系统的任务粒度怎么定? 以"可独立重跑、有明确完成语义"为原子标准:一条 SQL 是任务,一次导入是任务,一个校验探针也是任务;把多个动作塞进一个脚本节点,重试就会重复全部副作用。粒度判据定好之后,依赖图的清晰度是自然结果而不是刻意设计的产物。
问:BI 直连和中间加一层语义服务怎么选? 团队规模与口径治理压力决定:十人以内、口径简单,BI 直连加视图层足够;多团队共用、口径频繁争议,值得引入独立的语义层把指标定义集中托管。判断信号很简单——"同一个指标两个数"的争论每月超过一次,就该上语义层了。
本节要点回顾
- 铁三角各管一段:流入定时效上限,编排定可靠下限,消费定价值兑现。
- 队列解耦是纪律:缓冲层保护仓库导入,削峰填谷。
- 编排收拢一张图:导入、刷新、备份统一依赖图,血缘是进阶必修。
- BI 四特征评估:语义层、缓存、下钻、权限衔接,最后一公里在消费端。
- 时效预算分段:整体承诺拆成段内数字,排障才能单段定位。
通路铺好了,数据有了,下一节看三个行业怎么在这条通路上跑出各自的标准答案。