8.2 典型行业解决方案
8.2 典型行业解决方案
本节摘要:数据圈有句行话:脱离场景谈架构,都是纸上谈兵。本节把三个差异极大的行业样本摆在同一张解剖台上——互联网用户行为分析、金融实时风控、物联网时序聚合——看同一套引擎如何通过表模型、索引与刷新策略的取舍,长成三种完全不同的形态。读完你应当能按"数据形态、时效承诺、查询模式"三要素,为自己行业推导适配方案,而不是照抄任何模板。
学习目标
阅读完本节,你应当能够:
- 用三要素框架分析任意新场景的数据仓库适配需求;
- 为行为分析场景设计宽表与位图索引的组合并估算去重开销;
- 为风控场景搭建聚合模型的实时指标表并设定拦截查询的延迟预算;
- 为时序场景选择明细模型加多维排序键的组合,兼顾写入吞吐与聚合效率。
一、三要素:行业适配的推导起点
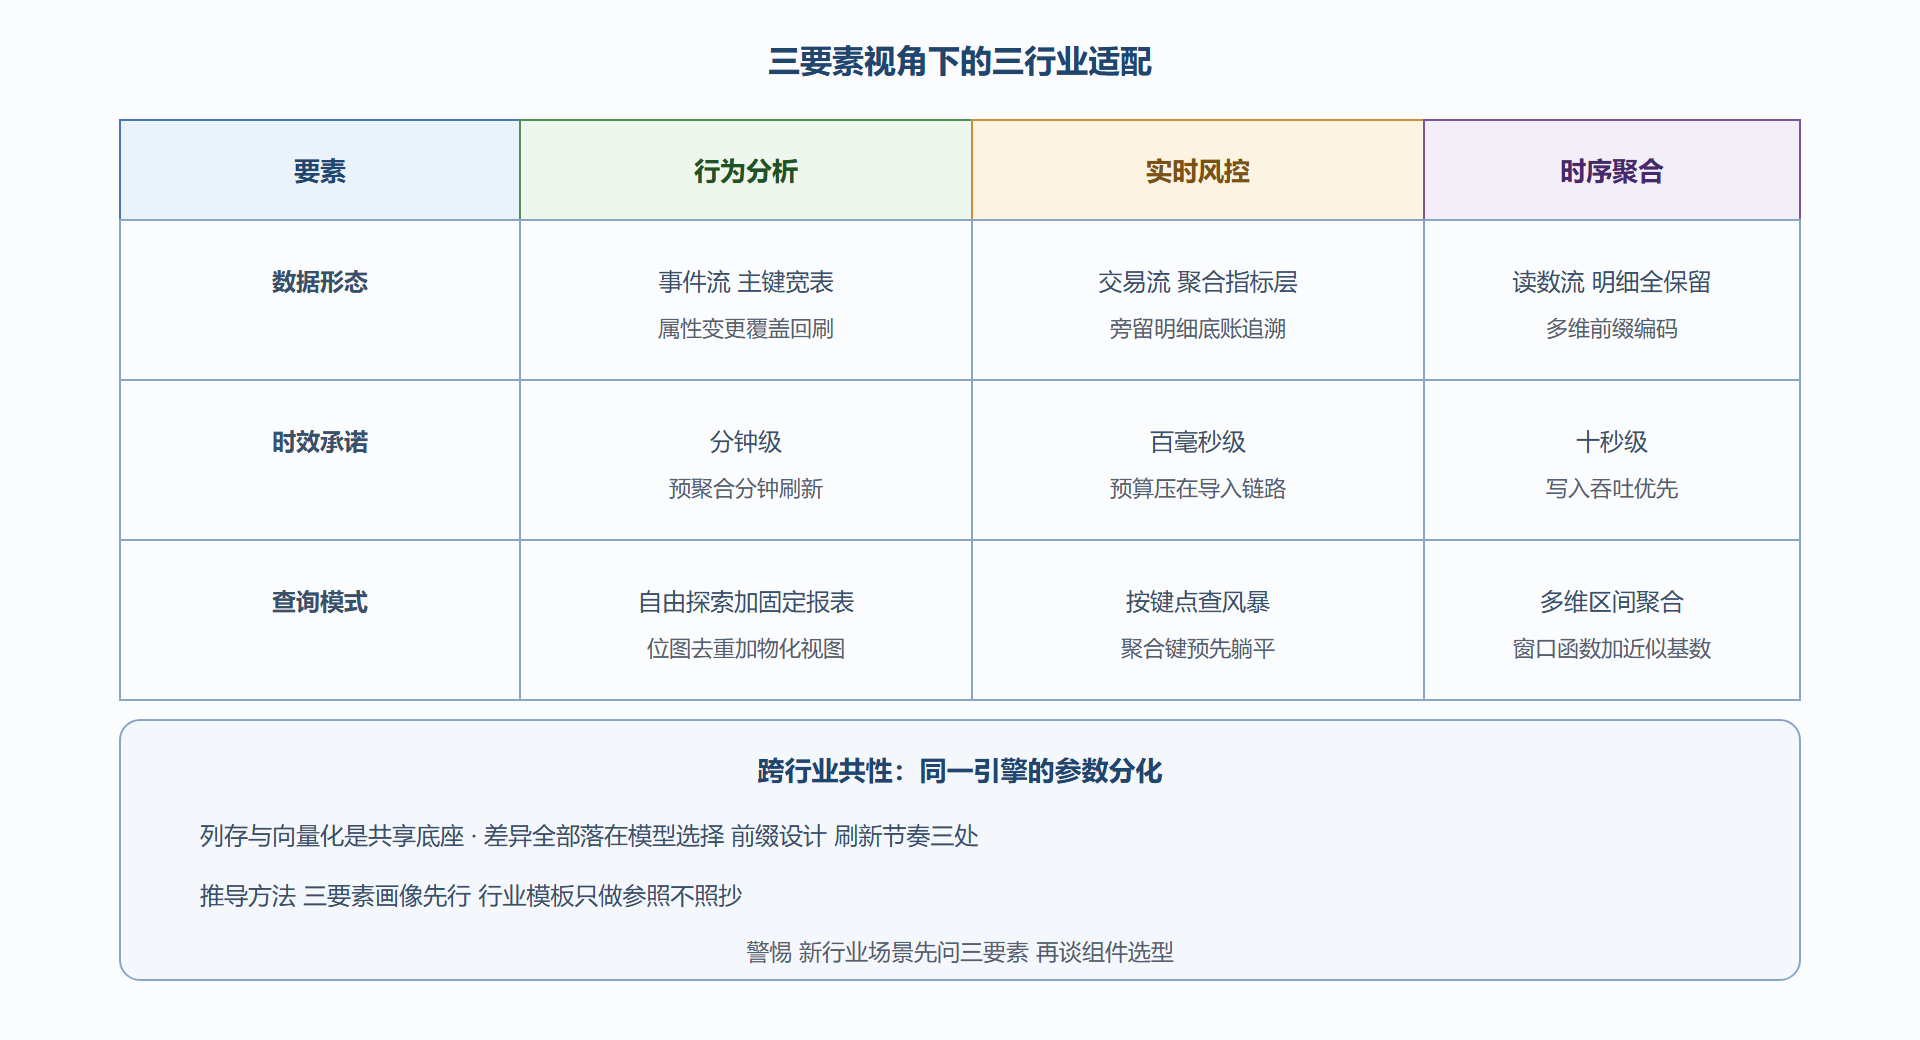
三个行业样本共享同一套推导框架。数据形态:事件流、交易流还是传感器读数,决定了表模型的骨架——只追加的事实流适合明细模型,需要按键更新的状态流适合主键模型,天然可加的度量流适合聚合模型。时效承诺:运营看板的三分钟、风控拦截的一百毫秒、设备监控的十秒,时效每收紧一档,导入与查询的参数就向不同方向倾斜。查询模式:固定口径的高频报表、自由探索的即席分析、还是按键取值的点查风暴,决定了索引与预计算的投入方向。行业只是表象,三要素才是本质——下面三个样本都从这三要素推起。
二、行为分析:宽表与去重索引的组合
互联网场景的三要素画像:事件流形态、分钟级时效、自由探索的查询模式。落地方案的核心一步是写入时预关联:把行为事件与用户属性在数据进入仓库时就拼成宽表,而不是让每次查询现场关联。代价是用户属性变更(升级会员、换设备)需要回刷历史事件的属性值——主键模型按用户与事件时间联合键做覆盖更新正好承接,这也是第 3 章讲 Merge-on-Write 时那个"更新不频繁但必须正确"场景的完整兑现。
行为分析最重的计算是去重统计:留存、独立访客、转化漏斗,全是集合运算。精确去重在亿级事件上是昂贵的,工程上的成熟折中是位图族函数:把用户标识编码进位图结构存储,交并差运算直接在位图上进行,存储与计算成本比原始去重低一个量级,精度对整数型标识是精确的。配套的物化视图把"每日各渠道活跃"这类固定口径预聚合掉(6.1 的四齿梳检验通过),自由探索的部分留给基表。
三、风控:毫秒级指标工厂
金融风控的三要素画像最苛刻:交易流形态、百毫秒级时效、按键点查的查询模式。指标工厂的架构是让"规则引擎要问的每个问题"都提前算好躺着待查:交易流水经实时导入落入聚合模型表,"单卡当日累计金额""近五分钟同设备交易次数"这类指标由聚合键自动累加维护,规则引擎的拦截查询退化为一次简单的按键范围检索——延迟预算的大头花在数据进入仓库的链路上,查询本身是毫秒级。
-- 风控指标表 聚合模型自动维护累加值 CREATE TABLE risk_metrics ( card_no VARCHAR(32), merchant VARCHAR(64), event_minute DATETIME, txn_count BIGINT SUM, txn_amount DECIMAL(18,2) SUM ) AGGREGATE KEY(card_no, merchant, event_minute) DISTRIBUTED BY HASH(card_no) BUCKETS 32; -- 规则引擎的拦截查询 点查形态 SELECT txn_count, txn_amount FROM risk_metrics WHERE card_no = '输入卡号' AND event_minute >= '窗口起点';
风控场景有一个常被低估的诉求:事后追溯。拦截只是止损,分析师要还原"这张卡事发前一小时的操作序列"找作案模式。这要求指标工厂旁边保留一份明细底账——聚合表负责快、明细表负责全,两层并存是风控架构的标准形态。同时 6.3 的权限体系在这里不是合规装饰而是业务组件:风控人员能看全量卡片数据,客服只能看已脱敏的摘要,同一套表两类视图。
四、时序聚合:写入吞吐与多维扫描的平衡
物联网场景的三要素画像:传感器读数流、十秒级时效、多维聚合的查询模式。它的特殊矛盾在于写入侧——百万设备每秒数条读数,写入吞吐是第一约束。方案骨架:明细模型保留全部原始读数(传感器数据的价值在完整历史),分桶按设备打散保证写入并行度,多维排序键把设备、区域、指标类型编码进前缀,让"华东区全部温度传感器最近一小时均值"这类查询只扫相关的数据块。
时序场景的两个专门武器值得一提。窗口函数处理"状态突变检测"这类相邻行比较的计算——温差告警就是一条窗口函数查询的事;近似基数函数处理"全网活跃设备数"这类全局去重——亿级设备数的去重用近似结构以千分位精度换百倍性能,监控场景完全够用。
图 8-2:三行业适配矩阵
五、共性复盘:统一引擎的参数分化
三个样本摆在一起,真正的洞察是架构同源、参数分化。存储引擎、执行模型、优化器完全同一套,三个行业长出三种形态的改动点集中在三处:表模型选择(主键、聚合、明细各占其一)、排序前缀设计(为各自的查询模式定制)、刷新与导入节奏(各配各的时效)。这印证了全册反复出现的判断——Doris 的高性能不是魔法,而是把决策权交给使用者的代价结构:模型选对、前缀排对、节奏配对,性能自然出来;选错了,调参救不回建模的错。
落到行动上,给自己业务做适配时坚持"三问在先":数据形态问清楚再选模型,时效承诺谈到数字再定链路,查询模式抽样统计再设计前缀。行业模板的价值是对照参考,不是施工图纸。
常见疑问
问:同一张表要同时服务两个行业的场景怎么办? 混合场景按"主画像建模、辅画像适配"处理:判断哪类查询占八成流量,按它建主结构,另一类查询用辅助手段承接——物化视图补预聚合、联邦查外部明细、或单独建一张面向辅画像的小型投影表。让一张表同时优化两种矛盾的查询模式,结果通常是两头都不达标。
问:行业方案里数字指标(延迟、精度)的依据是什么? 本节的数字都来自可复现的量级推演而非绝对承诺——你的数据分布、硬件规格、版本都会让实测偏移。正确的用法是学推演方法:把业务指标拆到链路段落,逐段估量级,再用自己的 PoC 实测校准。带着方法走的团队,换任何场景都能自己算出答案。
问:三个行业样本之外,第四类场景怎么推? 回到三要素从零画像,并优先找"最苛刻的那一维":写入吞吐、查询延迟、分析深度,三者中业务最不能让步的那个决定架构主轴,其余两维用辅助手段平衡。样本的价值是校准你对量级的直觉,不是限制你只建这三种形态。
本节要点回顾
- 三要素先于选型:数据形态、时效承诺、查询模式,三问之后再谈组件。
- 宽表在写入时拼:预关联换取查询简洁,代价由主键模型的覆盖更新消化。
- 风控双层并存:聚合指标层负责快,明细底账负责追溯,缺一不可。
- 时序写入优先:明细保全历史,多维前缀让聚合只扫相关块。
- 架构同源参数分化:模型、前缀、节奏三处决策决定行业形态。
方案跑起来了,每一环都有效——但每个月的账单在说话。下一节把"又快又省"从口号变成可核算的账本。